Tự làm Web App định giá laptop cũ bằng KNN với NumPy và Gradio
Trong bài này
- Chuẩn bị
- Ôn nhanh: KNN trong 3 bước
- Bước 1: dữ liệu 40 laptop cũ
- Bộ dữ liệu
- Đọc dữ liệu và chuẩn hóa
- Vì sao bắt buộc chuẩn hóa ở đây?
- Bước 2: viết hàm định giá bằng KNN
- Bước 3: đóng gói thành Web App bằng Gradio
- Chơi thử với Web App
- Bước 4: đối chiếu với scikit-learn
- Chọn k bao nhiêu thì hợp lý?
- Lỗi thường gặp
- Tự luyện thêm
- Tóm tắt
Series · Bài 5/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
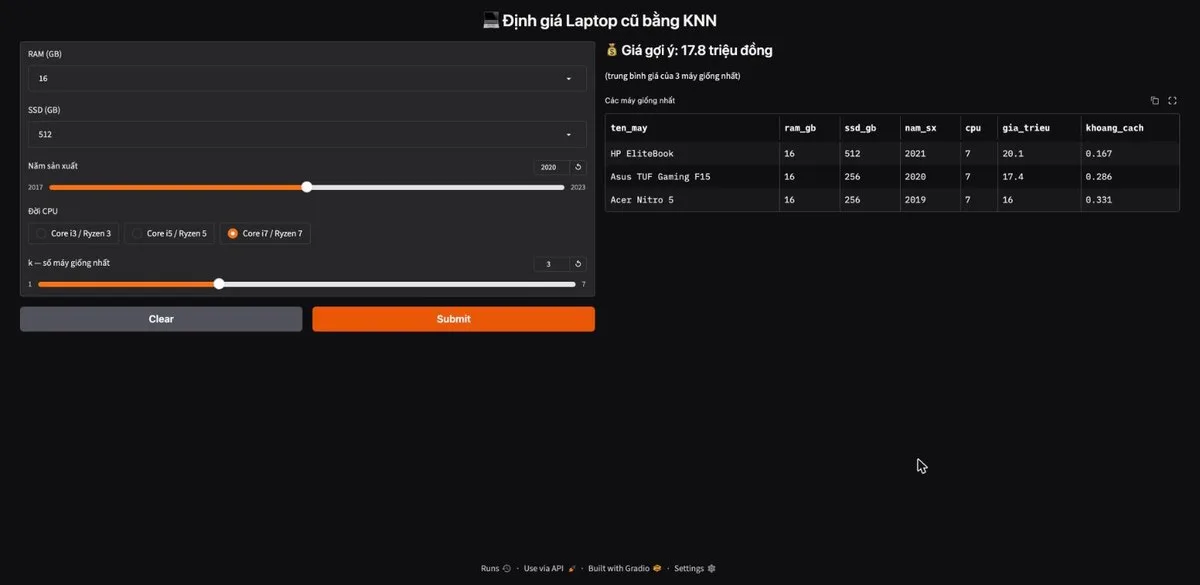
Bạn định bán laptop (láp-tóp) cũ để lên đời nhưng không biết hét giá bao nhiêu: hét cao thì không ai hỏi, hét thấp thì tiếc. Ở bài trước trong series, bạn đã tính tay thuật toán KNN (ca-en-en) với 6 máy. Lần này mình làm thật.
Bạn sẽ dùng dữ liệu 40 laptop đã bán, chuẩn hóa 4 thông số, tự viết hàm định giá bằng NumPy chỉ khoảng 10 dòng, đóng gói thành Web App có link gửi bạn bè dùng thử, rồi đối chiếu với thư viện chuyên nghiệp scikit-learn để chắc chắn mình làm đúng.
Chuẩn bị
Mở notebook Colab (cô-láp) của bài: mở notebook trên Google Colab. Bài này dùng phần Bài tập 3 ở cuối notebook: một ô tạo dữ liệu và 4 ô Bước 1 đến Bước 4.
- Bấm link, đăng nhập Google, chọn File › Save a copy in Drive để có bản sao của riêng bạn.
- Bấm Connect ở góc phải trên, thấy dấu ✓ xanh là sẵn sàng.
- Chạy các ô theo đúng thứ tự: ô
%%writefile→ Bước 1 → Bước 2 → Bước 3 → Bước 4. Ô sau dùng biến của ô trước.
Dùng notebook mới cũng được: dán lần lượt từng đoạn code trong bài vào các ô riêng. Bước 3 sẽ cài thêm thư viện Gradio nên cần mạng, lần đầu mất khoảng 30 giây.
💡 Notebook có sẵn ô đáp án cho hàm định giá (tên bắt đầu bằng 🔑). Hãy tự điền khung code trước rồi mới mở ra đối chiếu.
Ôn nhanh: KNN trong 3 bước
Viết máy cần định giá thành vector (véc-tơ) 𝐪 (đọc: "vector q"), tức danh sách 4 thông số của nó. Để định giá 𝐪, KNN làm đúng ba việc:
- Chuẩn hóa Min-Max mọi cột về đoạn [0, 1] để không cột nào lấn át:
x' = (x − min) / (max − min) (đọc: "x phẩy bằng x trừ min, chia cho max trừ min") - Đo khoảng cách Euclid (Ơ-clít) từ 𝐪 tới từng máy đã bán:
d(𝐚, 𝐛) = √∑(ai − bi)² (đọc: "d của a, b bằng căn của tổng bình phương a i trừ b i") - Lấy trung bình giá của k máy gần nhất:
ŷ = (1/k) ∑ yi (đọc: "y mũ bằng một phần k nhân tổng y i"), với yi là giá máy thứ i và ŷ là giá dự đoán.
Nếu ba công thức này còn lạ, hãy đọc lại bài trước trong series, nơi mình tính tay từng bước. Ở đây ta chỉ việc ráp chúng lại trên dữ liệu thật.
Bước 1: dữ liệu 40 laptop cũ
Bộ dữ liệu
Mỗi máy có 4 thông số (đặc trưng) và giá đã bán:
| Cột | Ý nghĩa | Khoảng giá trị |
|---|---|---|
ram_gb |
Dung lượng RAM | 4 – 32 GB |
ssd_gb |
Dung lượng ổ SSD | 128 – 1024 GB |
nam_sx |
Năm sản xuất | 2017 – 2023 |
cpu |
Đời CPU: 3 = Core i3 / Ryzen 3, 5 = i5 / Ryzen 5, 7 = i7 / Ryzen 7 | 3, 5, 7 |
gia_trieu |
Giá đã bán (triệu đồng), thứ cần dự đoán | 5.4 – 27.7 |
Ô dưới đây dùng lệnh %%writefile của Colab để ghi 40 dòng dữ liệu thành file laptop_cu.csv trên máy chủ. Chạy xong, Colab báo Writing laptop_cu.csv.
%%writefile laptop_cu.csv
ten_may,ram_gb,ssd_gb,nam_sx,cpu,gia_trieu
Dell Inspiron 15,4,128,2022,3,10.4
Dell Inspiron 14,4,256,2021,5,13.1
Dell Latitude,16,512,2022,5,19.3
Dell XPS 13,32,512,2023,7,27.7
HP Pavilion 14,16,512,2018,5,13.2
HP ProBook,8,512,2023,5,18.1
HP EliteBook,16,512,2021,7,20.1
HP 240,4,256,2020,3,8.3
Lenovo IdeaPad 3,8,128,2022,3,12.6
Lenovo ThinkPad T,16,128,2020,5,15.0
Lenovo ThinkPad X1,8,128,2023,7,19.4
Lenovo Legion 5,8,256,2018,7,12.0
Asus VivoBook 15,4,512,2023,3,14.2
Asus ZenBook 14,8,512,2023,5,18.5
Asus TUF Gaming F15,32,512,2020,7,23.9
Acer Aspire 5,8,1024,2020,5,15.4
Acer Nitro 5,16,256,2019,7,16.0
Acer Swift 3,4,512,2019,5,10.4
MSI Modern 14,8,256,2020,5,13.0
MSI GF63 Thin,4,512,2021,7,15.5
Dell Inspiron 15,8,128,2020,3,9.4
Dell Inspiron 14,8,256,2019,5,11.6
Dell Latitude,8,512,2017,5,9.0
Dell XPS 13,16,128,2021,7,18.1
HP Pavilion 14,8,512,2023,5,17.6
HP ProBook,8,1024,2019,5,13.6
HP EliteBook,8,512,2018,7,12.4
HP 240,8,256,2022,3,12.9
Lenovo IdeaPad 3,16,256,2018,3,10.1
Lenovo ThinkPad T,16,512,2023,5,20.1
Lenovo ThinkPad X1,32,256,2017,7,18.8
Lenovo Legion 5,32,256,2017,7,18.0
Asus VivoBook 15,8,128,2017,3,5.4
Asus ZenBook 14,16,512,2017,5,11.4
Asus TUF Gaming F15,16,256,2020,7,17.4
Acer Aspire 5,8,1024,2020,5,15.9
Acer Nitro 5,32,256,2018,7,19.4
Acer Swift 3,4,512,2022,5,15.6
MSI Modern 14,16,1024,2022,5,20.0
MSI GF63 Thin,16,512,2018,7,15.5
Đọc dữ liệu và chuẩn hóa
# BÀI TẬP 3 — Bước 1: đọc dữ liệu & chuẩn hóa
import numpy as np
import pandas as pd

df = pd.read_csv("laptop_cu.csv")
COT = ["ram_gb", "ssd_gb", "nam_sx", "cpu"]
X = df[COT].to_numpy(dtype=float)        # ma trận 40 × 4
y = df["gia_trieu"].to_numpy()           # giá của 40 máy

x_min, x_max = X.min(axis=0), X.max(axis=0)
X_cc = (X - x_min) / (x_max - x_min)     # chuẩn hóa Min-Max từng cột
print("Kích thước X:", X.shape)
df.head()Kết quả: (Colab hiển thị df.head() dạng bảng)
Kích thước X: (40, 4)
            ten_may  ram_gb  ssd_gb  nam_sx  cpu  gia_trieu
0  Dell Inspiron 15       4     128    2022    3       10.4
1  Dell Inspiron 14       4     256    2021    5       13.1
2     Dell Latitude      16     512    2022    5       19.3
3       Dell XPS 13      32     512    2023    7       27.7
4    HP Pavilion 14      16     512    2018    5       13.2
X là một ma trận 40 hàng (40 máy) × 4 cột (4 thông số). Trong Toán, người ta viết X ∈ ℝ40×4 (đọc: "X thuộc R mũ 40 nhân 4"): một bảng số thực 40 hàng, 4 cột. Còn y là vector 40 giá tiền, mỗi máy một giá.
Vì sao bắt buộc chuẩn hóa ở đây?
Bốn cột có đơn vị rất khác nhau. Hai máy chênh nhau 256 GB SSD thì hiệu số là 256, còn lên đời từ i5 sang i7 chỉ chênh 2. Nếu đo khoảng cách trên số gốc, máy sẽ gần như chỉ nhìn cột SSD mà phớt lờ CPU, đúng cái bẫy "đổi đơn vị, máy chọn sai" ở bài trước.
Sau chuẩn hóa, mọi cột về [0, 1]. Tính tay cho máy 8 GB RAM, SSD 512 GB, năm 2020, Core i5:
- RAM: (8 − 4) / (32 − 4) = 4 / 28 ≈ 0.14
- SSD: (512 − 128) / (1024 − 128) = 384 / 896 ≈ 0.43
- Năm: (2020 − 2017) / (2023 − 2017) = 3 / 6 = 0.5
- CPU: (5 − 3) / (7 − 3) = 2 / 4 = 0.5
Giờ bốn con số "cùng hạng cân", cột nào cũng có tiếng nói ngang nhau.
Bước 2: viết hàm định giá bằng KNN
Hàm dinh_gia nhận cấu hình máy và k, trả về giá gợi ý cùng bảng k máy giống nhất. Các bước:
- Chuẩn hóa máy cần định giá q bằng cùng
x_min,x_maxcủa dữ liệu (đã viết sẵn). - Tính khoảng cách từ
q_cctới cả 40 máy đã chuẩn hóaX_cc. - Lấy k vị trí gần nhất bằng
np.argsort(d)[:k]. - Giá gợi ý là trung bình giá của k máy đó.
# BÀI TẬP 3 — Bước 2: KHUNG CODE hàm KNN, điền vào chỗ ____
def dinh_gia(ram, ssd, nam, cpu, k=3):
    q = np.array([ram, ssd, nam, cpu], dtype=float)
    q_cc = (q - x_min) / (x_max - x_min)              # chuẩn hóa máy cần định giá
    d = np.sqrt(np.sum((____ - ____) ** 2, axis=1))     # khoảng cách tới 40 máy
    idx = np.argsort(d)[:____]                         # k máy gần nhất
    gia_goi_y = y[idx].____()                          # trung bình giá k máy
    bang = df.iloc[idx].copy()
    bang["khoang_cach"] = d[idx].round(3)
    return round(float(gia_goi_y), 1), bang

gia, bang = dinh_gia(8, 512, 2020, 5, k=3)
print("Giá gợi ý:", gia, "triệu")
bang
Xem đáp án
def dinh_gia(ram, ssd, nam, cpu, k=3):
    q = np.array([ram, ssd, nam, cpu], dtype=float)
    q_cc = (q - x_min) / (x_max - x_min)
    d = np.sqrt(np.sum((X_cc - q_cc) ** 2, axis=1))
    idx = np.argsort(d)[:k]
    gia_goi_y = y[idx].mean()
    bang = df.iloc[idx].copy()
    bang["khoang_cach"] = d[idx].round(3)
    return round(float(gia_goi_y), 1), bang

gia, bang = dinh_gia(8, 512, 2020, 5, k=3)
print("Giá gợi ý:", gia, "triệu")
bang
Kết quả:
Giá gợi ý: 11.7 triệu
         ten_may  ram_gb  ssd_gb  nam_sx  cpu  gia_trieu  khoang_cach
17  Acer Swift 3       4     512    2019    5       10.4        0.220
18  MSI Modern 14      8     256    2020    5       13.0        0.286
21 Dell Inspiron 14 8 256 2019 5 11.6 0.331Kiểm tra tay: (10.4 + 13.0 + 11.6) / 3 = 35 / 3 ≈ 11.67, làm tròn 1 chữ số thập phân là 11.7 triệu.
Thú vị là máy giống nhất lại là Acer Swift 3 chỉ có 4 GB RAM. Tính tay khoảng cách đã chuẩn hóa: RAM chênh 4 / 28 ≈ 0.143, năm chênh 1 / 6 ≈ 0.167, SSD và CPU trùng khớp (chênh 0). Vậy d = √(0.143² + 0.167²) ≈ √0.048 ≈ 0.220, đúng như bảng. Máy này "lệch" hai thông số một chút, nhưng khớp hoàn toàn hai thông số còn lại, nên vẫn gần nhất.
Hai lệnh mới trong hàm: df.iloc[idx] lấy các hàng của bảng theo vị trí trong idx; .copy() tạo bản sao để thêm cột khoang_cach mà không đụng vào dữ liệu gốc.
Bước 3: đóng gói thành Web App bằng Gradio
Gradio (gờ-ra-đi-ô) là thư viện Python giúp dựng giao diện web chỉ bằng vài dòng: bạn đưa vào một hàm, khai báo ô nhập và ô kết quả, Gradio lo phần còn lại.
# BÀI TẬP 3 — Bước 3: đóng gói thành Web App bằng Gradio
!pip install -q gradio
import gradio as gr

CPU = {"Core i3 / Ryzen 3": 3, "Core i5 / Ryzen 5": 5, "Core i7 / Ryzen 7": 7}

def app_dinh_gia(ram, ssd, nam, ten_cpu, k):
    gia, bang = dinh_gia(ram, ssd, nam, CPU[ten_cpu], int(k))
    return f"## 💰 Giá gợi ý: {gia} triệu đồng\n(trung bình giá của {int(k)} máy giống nhất)", bang

demo = gr.Interface(
    fn=app_dinh_gia,
    inputs=[
        gr.Dropdown([4, 8, 16, 32], value=8, label="RAM (GB)"),
        gr.Dropdown([128, 256, 512, 1024], value=512, label="SSD (GB)"),
        gr.Slider(2017, 2023, value=2020, step=1, label="Năm sản xuất"),
        gr.Radio(list(CPU), value="Core i5 / Ryzen 5", label="Đời CPU"),
        gr.Slider(1, 7, value=3, step=1, label="k — số máy giống nhất"),
    ],
    outputs=[gr.Markdown(), gr.Dataframe(label="Các máy giống nhất")],
    title="💻 Định giá Laptop cũ bằng KNN",
    flagging_mode="never",
)
demo.launch(share=True)
Đọc code theo từng khối:
- 5 ô nhập trong
inputsđược truyền lần lượt vào 5 tham số củaapp_dinh_gia: 2 ô chọn (Dropdown) cho RAM và SSD, 2 thanh trượt (Slider) cho năm sản xuất và k, 1 nhóm nút chọn (Radio) cho đời CPU. - Từ điển
CPUđổi chữ người dùng chọn ("Core i5 / Ryzen 5") thành con số mà công thức cần (5). - 2 ô kết quả:
Markdownhiện dòng giá gợi ý,Dataframehiện bảng các máy giống nhất. int(k)đổi giá trị thanh trượt sang số nguyên cho chắc ăn, vì[:k]chỉ nhận số nguyên.share=Truetạo một link công khai dạnghttps://….gradio.live: mở được trên điện thoại hoặc gửi bạn bè dùng thử. Link sống tối đa 1 tuần và mất khi bạn tắt Colab.
Chơi thử với Web App
- Cấu hình mặc định (8 GB, 512 GB, 2020, Core i5, k = 3): bấm Submit, app trả 11.7 triệu cùng bảng 3 máy, khớp với Bước 2.
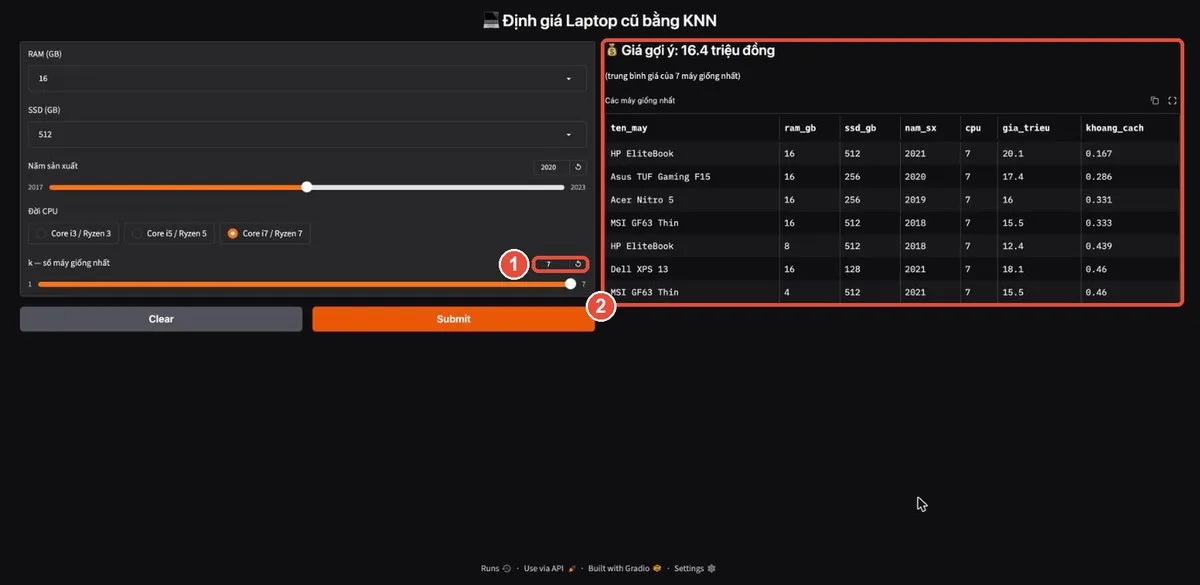
- Đổi sang 16 GB RAM, Core i7 (giữ 512 GB, năm 2020): giá gợi ý tăng lên 17.8 triệu, và 3 máy giống nhất (HP EliteBook, Asus TUF Gaming F15, Acer Nitro 5) đều là máy i7, 16 GB, đúng như ảnh đầu bài.
- Cùng cấu hình đó, kéo k lên 7: giá gợi ý còn 16.4 triệu.
Bước 4: đối chiếu với scikit-learn
Làm sao biết hàm tự viết của mình đúng? So với KNeighborsRegressor, bản KNN của thư viện máy học scikit-learn (xai-kít lơn) mà dân AI dùng hằng ngày.
# BÀI TẬP 3 — Bước 4: Tự kiểm tra (không cần giao diện)
from sklearn.neighbors import KNeighborsRegressor

cau_hinh = [(8, 512, 2020, 5), (16, 512, 2020, 7), (4, 256, 2018, 3)]
mo_hinh = KNeighborsRegressor(n_neighbors=3).fit(X_cc, y)

for ch in cau_hinh:
    gia_cua_ban, _ = dinh_gia(*ch, k=3)
    q_cc = (np.array(ch, dtype=float) - x_min) / (x_max - x_min)
    gia_sklearn = mo_hinh.predict([q_cc])[0]
    print(ch, "→ của bạn:", gia_cua_ban, "| sklearn:", round(gia_sklearn, 1))
Kết quả:
(8, 512, 2020, 5) → của bạn: 11.7 | sklearn: 11.7
(16, 512, 2020, 7) → của bạn: 17.8 | sklearn: 17.8
(4, 256, 2018, 3) → của bạn: 7.7 | sklearn: 7.7
Bảng kiểm thử đầy đủ để bạn đối chiếu (k = 3):
| RAM | SSD | Năm | CPU | Giá gợi ý | 3 máy gần nhất |
|---|---|---|---|---|---|
| 8 | 512 | 2020 | i5 | 11.7 | Acer Swift 3, MSI Modern 14, Dell Inspiron 14 |
| 16 | 512 | 2020 | i7 | 17.8 | HP EliteBook, Asus TUF Gaming F15, Acer Nitro 5 |
| 4 | 256 | 2018 | i3 | 7.7 | Asus VivoBook 15, HP 240, Dell Inspiron 15 |
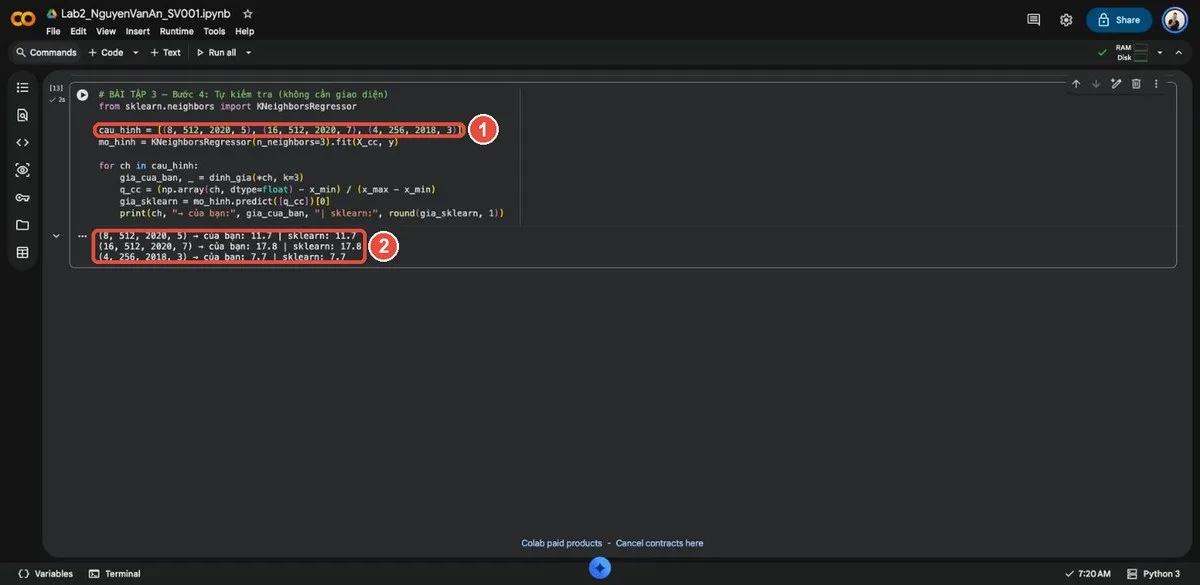
Cả ba dòng trùng nhau. Nghĩa là KNeighborsRegressor bên trong cũng chỉ làm đúng ba việc bạn vừa tự code: đo khoảng cách, chọn k gần nhất, lấy trung bình. Để ý là ta vẫn phải tự chuẩn hóa dữ liệu (X_cc, q_cc) trước khi đưa cho thư viện: scikit-learn không tự làm việc đó giúp bạn.
Chọn k bao nhiêu thì hợp lý?
Với máy 16 GB, Core i7 ở trên, k = 3 cho 17.8 triệu còn k = 7 cho 16.4 triệu. Chênh gần 1,5 triệu chỉ vì đổi một con số. Vậy chọn k thế nào?
- k quá nhỏ (như k = 1): giá chỉ dựa vào đúng một máy. Nếu người bán máy đó bán hớ hoặc gặp khách "hào phóng", giá gợi ý của bạn lệch theo.
- k quá lớn: app kéo cả những máy ít giống (cũ hơn, cấu hình thấp hơn) vào trung bình, như trường hợp k = 7 ở trên.
Không có con số k đúng cho mọi bài toán. Cách thực tế là thử vài giá trị, nhìn bảng "các máy giống nhất" xem chúng có thật sự giống máy của bạn không, rồi chọn k cho kết quả hợp lý nhất. Bạn sẽ tự làm việc này ở phần luyện tập dưới đây.
Lỗi thường gặp
| Thông báo lỗi | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'np' is not defined |
Chưa chạy ô import | Chạy ô có import numpy as np trước |
NameError: name 'X_cc' is not defined |
Chưa chạy ô Bước 1 | Chạy lần lượt ô %%writefile → Bước 1 → Bước 2 |
FileNotFoundError: laptop_cu.csv |
Chưa chạy ô %%writefile, hoặc máy chủ vừa khởi động lại |
Chạy lại ô %%writefile |
ValueError: operands could not be broadcast |
Vector q khác số phần tử với số cột của X | Kiểm tra .shape: q phải có đúng số cột của X |
| Link Gradio hết hạn | Link share tồn tại tối đa 1 tuần và mất khi tắt Colab | Chạy lại ô demo.launch(share=True) |
Tự luyện thêm
- Chọn cách đo trong Web App: thêm một nhóm nút chọn
gr.Radiođể người dùng chọn khoảng cách Euclid hay Manhattan. Nhớ lại: khoảng cách Manhattan d1(𝐚, 𝐛) = ∑|ai − bi| (đọc: "d một của a, b bằng tổng trị tuyệt đối a i trừ b i"). - Định giá máy của chính bạn: nhập cấu hình laptop bạn đang dùng (hoặc máy bạn muốn mua), thử k = 1, 3, 5, 7. Bạn chọn k nào và vì sao?
- Trả thêm khoảng giá: ngoài giá trung bình, cho app hiện giá thấp nhất và cao nhất của k máy, ví dụ "từ 10.4 đến 13.0 triệu". Gợi ý:
y[idx].min(),y[idx].max().
Xem gợi ý cho thử thách 1
Thêm tham số cach_do vào hàm định giá và rẽ nhánh khi tính khoảng cách:
def dinh_gia(ram, ssd, nam, cpu, k=3, cach_do="Euclid"):
    q = np.array([ram, ssd, nam, cpu], dtype=float)
    q_cc = (q - x_min) / (x_max - x_min)
    if cach_do == "Manhattan":
        d = np.sum(np.abs(X_cc - q_cc), axis=1)
    else:
        d = np.sqrt(np.sum((X_cc - q_cc) ** 2, axis=1))
    idx = np.argsort(d)[:k]
    bang = df.iloc[idx].copy()
    bang["khoang_cach"] = d[idx].round(3)
    return round(float(y[idx].mean()), 1), bang
Sau đó thêm tham số thứ sáu cach_do cho app_dinh_gia, truyền nó vào dinh_gia(..., cach_do=cach_do), và thêm ô nhập thứ sáu vào cuối danh sách inputs: gr.Radio(["Euclid", "Manhattan"], value="Euclid", label="Cách đo khoảng cách").
Tóm tắt
- KNN định giá = chuẩn hóa Min-Max → đo khoảng cách tới mọi máy → lấy trung bình giá của k máy gần nhất. Toàn bộ chỉ khoảng 10 dòng NumPy.
- Phải chuẩn hóa máy cần định giá bằng cùng min, max của dữ liệu.
- Gradio biến một hàm Python thành Web App có link chia sẻ chỉ với một lệnh
gr.Interface. - Hàm tự viết cho kết quả trùng với
KNeighborsRegressorcủa scikit-learn: thư viện không có gì "phép thuật", chỉ là Toán bạn đã hiểu.
| Ký hiệu Toán | Cách đọc | Lệnh NumPy |
|---|---|---|
| X ∈ ℝ40×4 | "X thuộc R mũ 40 nhân 4" | X.shape → (40, 4) |
| x' = (x − min) / (max − min) | "x phẩy bằng x trừ min, chia cho max trừ min" | (X - x_min) / (x_max - x_min) |
| d(𝐚, 𝐛) = √∑(ai − bi)² | "d của a, b bằng căn của tổng bình phương a i trừ b i" | np.sqrt(np.sum((X_cc - q_cc) ** 2, axis=1)) |
| d1(𝐚, 𝐛) = ∑|ai − bi| | "d một của a, b bằng tổng trị tuyệt đối a i trừ b i" | np.sum(np.abs(X_cc - q_cc), axis=1) |
| ŷ = (1/k) ∑ yi | "y mũ bằng một phần k nhân tổng y i" | y[np.argsort(d)[:k]].mean() |
Bài tiếp theo trong series: Vector, tích vô hướng, độ dài và độ tương tự cosine. Mình sẽ nhìn vector theo một cách mới: không chỉ đo hai thứ cách nhau bao xa, mà còn đo chúng "cùng hướng" đến đâu.
