Tìm kiếm ngữ nghĩa bằng embedding và RAG: Web App tìm đồ án, so CV với JD
Trong bài này
- Chuẩn bị
- Embedding là gì? Một "người phiên dịch" chữ sang số
- Dữ liệu và tải mô hình
- Hai file dữ liệu
- Bước 1: tải mô hình embedding
- Bước 2: biến mọi tài liệu thành vector
- Bước 3: hàm tìm kiếm ngữ nghĩa top-k
- Bước 4: RAG mini, ghép tài liệu vào prompt
- Bước 5: đóng gói thành Web App bằng Gradio
- Bước 6: tự kiểm tra 8 câu
- Lỗi thường gặp
- Tự luyện thêm
- Tóm tắt
Series · Bài 8/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
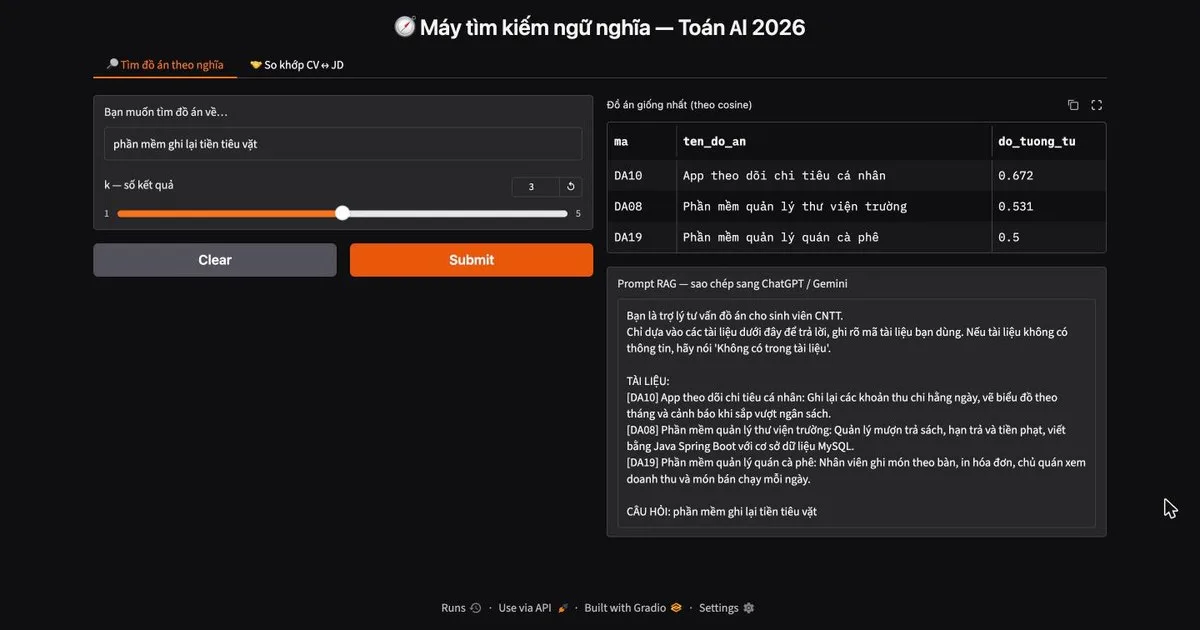
Ở bài trước, máy tìm đồ án bằng đếm từ đã "trượt" câu hỏi "phần mềm ghi lại tiền tiêu vặt" vì nó chỉ thấy chữ, không thấy nghĩa. Bài này sửa đúng lỗi đó: thay đếm từ bằng một mô hình embedding (nhúng) biến mỗi câu thành 384 con số theo nghĩa, rồi vẫn dùng công thức cosine quen thuộc để tìm kiếm.
Cuối bài, bạn có một Web App chạy thật với hai chức năng: tìm đồ án theo ý tưởng bằng lời của bạn, và dán vài dòng giới thiệu bản thân để app gợi ý JD thực tập phù hợp. App còn tạo sẵn một prompt RAG để bạn hỏi tiếp ChatGPT hoặc Gemini, và đây cũng chính là bộ khung của các chatbot "hỏi đáp tài liệu" ngoài đời.
Chuẩn bị
- Mở notebook Colab của bài này, cuộn xuống phần Bài tập 3.
- Chọn File › Save a copy in Drive, rồi bấm Connect ở góc phải trên. Máy CPU mặc định của Colab là đủ, không cần GPU.
- Hoặc tạo notebook mới và dán lần lượt các ô code trong bài theo đúng thứ tự.
Lưu ý: mô hình embedding nặng khoảng 470 MB. Lần đầu tải mất khoảng 1 phút; các lần chạy sau trong cùng phiên sẽ nhanh. Colab cài sẵn thư viện sentence-transformers; nếu bạn chạy trên máy riêng, cần pip install sentence-transformers gradio trước.
💡 Notebook có ô Đáp án đã thu gọn cho hàm tìm kiếm. Hãy tự điền khung code trước rồi mới mở ra đối chiếu.
Embedding là gì? Một "người phiên dịch" chữ sang số
Hãy tưởng tượng embedding là một người phiên dịch đã đọc rất nhiều câu: nhận vào một câu bất kỳ, trả ra 384 con số. Người phiên dịch này được huấn luyện sao cho hai câu cùng nghĩa, dù khác chữ, thậm chí khác ngôn ngữ, sẽ có vector cùng hướng, nên cosine gần 1.
Viết bằng ký hiệu: mỗi tài liệu i được biến thành vector 𝐞ᵢ ∈ ℝ³⁸⁴ (đọc: "e i thuộc R mũ 384", tức là một danh sách 384 số thực), câu hỏi được biến thành vector 𝐪 (đọc: "vector q"). Sau đó mọi thứ giống hệt bài trước: tính cos(𝐪, 𝐞ᵢ) (đọc: "cô-sin của q và e i") với từng tài liệu, lấy những cái lớn nhất.
| Đếm từ (bài trước) | Embedding (bài này) | |
|---|---|---|
| Độ dài vector | Bằng số từ trong từ vựng (52) | Cố định 384, câu dài hay ngắn đều vậy |
| Mỗi số nghĩa là gì | Số lần một chữ xuất hiện | Không gán được cho chữ nào, cả vector mới mang nghĩa |
| "tiền tiêu vặt" và "chi tiêu" | Coi như không liên quan | Nhận ra là cùng ý |
| Cách so sánh | Cosine | Vẫn là cosine |
Ta dùng mô hình paraphrase-multilingual-MiniLM-L12-v2: miễn phí, chạy được trên CPU và hiểu tiếng Việt lẫn tiếng Anh. Bạn không cần huấn luyện gì, chỉ gọi mo_hinh.encode("câu").
Dữ liệu và tải mô hình
Hai file dữ liệu
Dữ liệu gồm 30 đồ án sinh viên (mã, tên, mô tả) và 10 JD thực tập (mã, vị trí, công ty, yêu cầu). Mỗi ô %%writefile ghi một file CSV vào máy chủ Colab; chạy xong sẽ thấy dòng Writing do_an.csv và Writing jd.csv.
%%writefile do_an.csv
ma,ten_do_an,mo_ta
DA01,Ứng dụng đặt đồ ăn trong căng tin,"App Flutter cho sinh viên chọn món, thanh toán bằng mã QR và xem còn bao nhiêu người đang chờ lấy đồ."
DA02,Website bán quần áo thời trang,"Trang web React và Node.js có giỏ hàng, mã giảm giá và trang quản trị sản phẩm cho chủ shop."
DA03,Chatbot tư vấn tuyển sinh,"Chatbot trả lời câu hỏi của thí sinh về ngành học, học phí, điểm chuẩn và hồ sơ xét tuyển của trường."
...
%%writefile jd.csv
ma,vi_tri,cong_ty,yeu_cau
JD01,Thực tập sinh Frontend ReactJS,Công ty Sao Mai Tech,"Cắt giao diện web từ bản thiết kế Figma bằng HTML, CSS, JavaScript và ReactJS, làm việc với REST API."
JD02,Thực tập sinh Backend Java,Công ty Hồng Hà Software,"Xây dựng API bằng Java Spring Boot, thiết kế cơ sở dữ liệu MySQL, viết truy vấn SQL tối ưu."
...💡 Hai ô trên đã được rút gọn: dòng
...chỉ đánh dấu chỗ lược bớt, đừng chép nó vào notebook. Hai ô đầy đủ (30 đồ án DA01–DA30 và 10 JD từ Frontend, Backend, Mobile, Phân tích dữ liệu, AI ngôn ngữ đến DevOps, IoT) có sẵn trong notebook; nếu bạn tạo notebook mới, hãy sao chép nguyên hai ô đó sang.
Bước 1: tải mô hình embedding
# BÀI TẬP 3 — Bước 1: tải mô hình embedding (lần đầu mất khoảng 1 phút)
import numpy as np
import pandas as pd
from sentence_transformers import SentenceTransformer

mo_hinh = SentenceTransformer("sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2")

def cosine(a, b):
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))

v = mo_hinh.encode("cà phê sữa đá")
print("Một câu →", v.shape, "→ 8 số đầu:", v[:8].round(3))

for a, b in [("cà phê", "coffee"), ("điện thoại", "smartphone"), ("cà phê", "bóng đá")]:
    print(f"cos('{a}', '{b}') = {cosine(mo_hinh.encode(a), mo_hinh.encode(b)):.3f}")
Kết quả:
Một câu → (384,) → 8 số đầu: [-0.278 -0.15   0.121  0.519  0.119  0.047  0.107  0.125]
cos('cà phê', 'coffee') = 0.987
cos('điện thoại', 'smartphone') = 0.794
cos('cà phê', 'bóng đá') = 0.273
Hãy dừng lại ở con số 0.987: "cà phê" và "coffee" không chung một ký tự nào, đếm từ sẽ cho cos = 0, nhưng embedding cho gần như 1. Còn "cà phê" và "bóng đá" chỉ được 0.273. Đây là thứ mà đếm từ không bao giờ làm được.
💡 Khi tải mô hình, Colab có thể hiện cảnh báo về
HF_TOKENhoặc "unauthenticated requests to the HF Hub". Đó không phải lỗi, mô hình này tải được mà không cần đăng nhập Hugging Face. Cứ bỏ qua.
Bước 2: biến mọi tài liệu thành vector
Mỗi đồ án được ghép "tên. mô tả" thành một câu dài rồi đưa vào mô hình; mỗi JD ghép "vị trí. yêu cầu". Kết quả E_da là một ma trận 30 hàng, mỗi hàng là vector 384 số của một đồ án. Việc này chỉ làm một lần; sau đó mỗi câu hỏi mới chỉ cần tính thêm đúng một vector.
# BÀI TẬP 3 — Bước 2: đọc dữ liệu & biến MỌI tài liệu thành vector
df_da = pd.read_csv("do_an.csv")
df_jd = pd.read_csv("jd.csv")

E_da = mo_hinh.encode((df_da["ten_do_an"] + ". " + df_da["mo_ta"]).tolist())   # 30 vector
E_jd = mo_hinh.encode((df_jd["vi_tri"] + ". " + df_jd["yeu_cau"]).tolist())     # 10 vector
print("E_da:", E_da.shape, "  E_jd:", E_jd.shape)
df_da.head()
Kết quả:
E_da: (30, 384) E_jd: (10, 384)Kèm theo là bảng 5 đồ án đầu tiên do df_da.head() in ra. Các hệ thống tìm kiếm thật cũng làm vậy: nhúng sẵn cả kho tài liệu, khi người dùng hỏi thì chỉ việc so sánh.
Bước 3: hàm tìm kiếm ngữ nghĩa top-k
top-k = k tài liệu có cos(𝐪, 𝐞ᵢ) lớn nhất
Đọc: "tóp ca là k tài liệu có cô-sin của q và e i lớn nhất", trong đó 𝐪 là vector câu hỏi, 𝐞ᵢ là vector của tài liệu thứ i.
So với KNN ở Bài 4 trong series: KNN lấy k món có khoảng cách nhỏ nhất (np.argsort(d)[:k]); tìm theo nghĩa lấy k tài liệu có cosine lớn nhất (np.argsort(diem)[::-1][:k]). Cùng một ý tưởng "tìm hàng xóm gần nhất", chỉ đổi thước đo.
Điền vào các chỗ ____:
# BÀI TẬP 3 — Bước 3: KHUNG CODE hàm tìm kiếm ngữ nghĩa, điền vào chỗ ____
def tim_kiem(cau_hoi, E, k=3):
    q = mo_hinh.encode(cau_hoi)                        # câu hỏi → vector
    diem = np.array([cosine(____, q) for e in E])      # cosine với TỪNG tài liệu
    idx = np.argsort(____)[::-1][:____]                # k tài liệu có cosine lớn nhất
    return idx, diem[idx]

def tim_do_an(cau_hoi, k=3):
    idx, diem = tim_kiem(cau_hoi, E_da, k)
    bang = df_da.iloc[idx][["ma", "ten_do_an", "mo_ta"]].copy()
    bang["do_tuong_tu"] = diem.round(3)
    return bang

def tim_jd(cv, k=3):
    idx, diem = tim_kiem(cv, ____, k)                  # so CV với 10 JD
    bang = df_jd.iloc[idx][["ma", "vi_tri", "cong_ty"]].copy()
    bang["do_phu_hop"] = diem.round(3)
    return bang

display(tim_do_an("app gọi món ăn ở canteen"))
display(tim_do_an("phần mềm ghi lại tiền tiêu vặt"))   # câu bài trước tìm sai — giờ thì sao?
display(tim_jd("Em giỏi Excel và thích làm báo cáo số liệu"))
Xem đáp án
def tim_kiem(cau_hoi, E, k=3):
    q = mo_hinh.encode(cau_hoi)
    diem = np.array([cosine(e, q) for e in E])
    idx = np.argsort(diem)[::-1][:k]
    return idx, diem[idx]

def tim_jd(cv, k=3):
    idx, diem = tim_kiem(cv, E_jd, k)      # E_jd chứ không phải E_da!
    # ... phần còn lại giữ nguyên
Kết quả (rút gọn, bỏ cột mô tả):
| Câu hỏi | Top 3 | cos |
|---|---|---|
| app gọi món ăn ở canteen | DA01 · Ứng dụng đặt đồ ăn trong căng tin | 0.627 |
| DA19 · Phần mềm quản lý quán cà phê | 0.523 | |
| DA17 · Sàn thương mại điện tử đồ công nghệ | 0.313 | |
| phần mềm ghi lại tiền tiêu vặt | DA10 · App theo dõi chi tiêu cá nhân | 0.672 |
| DA08 · Phần mềm quản lý thư viện trường | 0.531 | |
| DA19 · Phần mềm quản lý quán cà phê | 0.500 | |
| Em giỏi Excel và thích làm báo cáo số liệu | JD04 · Thực tập sinh Phân tích dữ liệu | 0.602 |
| JD07 · Thực tập sinh Kiểm thử phần mềm | 0.373 | |
| JD02 · Thực tập sinh Backend Java | 0.177 |
"canteen" tìm ra "căng tin" dù không trùng chữ. Câu bài trước tìm sai giờ ra đúng App theo dõi chi tiêu cá nhân (0.672), vượt hẳn quán cà phê (0.500). Công thức cosine không đổi, chỉ đổi cách biến chữ thành vector. (Số cosine của bạn có thể lệch nhẹ ở chữ số thứ ba tùy máy chủ.)
Bước 4: RAG mini, ghép tài liệu vào prompt
ChatGPT không biết gì về 30 đồ án của trường bạn. Nếu hỏi thẳng "em nên chọn đề nào", nó sẽ trả lời chung chung hoặc bịa. RAG (Retrieval-Augmented Generation, nghĩa là "sinh câu trả lời có tra cứu tài liệu") giải quyết chuyện này bằng ba bước:
- Retrieve (tìm): lấy vài tài liệu liên quan nhất. Bước 3 đã làm xong.
- Augment (ghép): dán các tài liệu đó vào prompt, kèm lời dặn "chỉ dựa vào tài liệu này". Bước 4 làm phần này.
- Generate (sinh): mô hình ngôn ngữ như ChatGPT, Gemini đọc prompt và trả lời. Bạn chỉ cần sao chép prompt sang, không cần API key.
# BÀI TẬP 3 — Bước 4: RAG mini = Tìm (Retrieve) → Ghép vào prompt (Augment) → để mô hình ngôn ngữ trả lời (Generate)
def tao_prompt(cau_hoi, k=3):
    bang = tim_do_an(cau_hoi, k)
    tai_lieu = "\n".join(f"[{r.ma}] {r.ten_do_an}: {r.mo_ta}" for r in bang.itertuples())
    return (
        "Bạn là trợ lý tư vấn đồ án cho sinh viên CNTT.\n"
        "Chỉ dựa vào các tài liệu dưới đây để trả lời, ghi rõ mã tài liệu bạn dùng. "
        "Nếu tài liệu không có thông tin, hãy nói 'Không có trong tài liệu'.\n\n"
        f"TÀI LIỆU:\n{tai_lieu}\n\n"
        f"CÂU HỎI: {cau_hoi}"
    )

print(tao_prompt("Em muốn làm đồ án về AI xử lý tiếng Việt, nên chọn đề nào?"))
# 👉 Sao chép toàn bộ đoạn trên, dán vào ChatGPT / Gemini để xem câu trả lời có trích dẫn [DAxx].
Kết quả:
Bạn là trợ lý tư vấn đồ án cho sinh viên CNTT.
Chỉ dựa vào các tài liệu dưới đây để trả lời, ghi rõ mã tài liệu bạn dùng. Nếu tài liệu không có thông tin, hãy nói 'Không có trong tài liệu'.

TÀI LIỆU:
[DA15] Tóm tắt tin tức tự động: Đọc một bài báo tiếng Việt dài và tự viết lại đoạn tóm tắt vài câu bằng mô hình ngôn ngữ.
[DA27] Chuyển giọng nói thành văn bản tiếng Việt: Ghi âm cuộc họp hoặc bài giảng và tự động chuyển lời nói thành biên bản dạng chữ.
[DA03] Chatbot tư vấn tuyển sinh: Chatbot trả lời câu hỏi của thí sinh về ngành học, học phí, điểm chuẩn và hồ sơ xét tuyển của trường.

CÂU HỎI: Em muốn làm đồ án về AI xử lý tiếng Việt, nên chọn đề nào?
Mỗi tài liệu có mã [DAxx] để AI trích dẫn, nhờ đó bạn kiểm tra được nó có "bịa" hay không. Hãy thử dán prompt vào ChatGPT hoặc Gemini: câu trả lời có ghi mã [DA15], [DA27]… không? Rồi thử một câu không có trong tài liệu, ví dụ "đồ án về blockchain": AI có trả lời "Không có trong tài liệu" không?
Bước 5: đóng gói thành Web App bằng Gradio
Gradio (grây-đi-ô) biến một hàm Python thành giao diện web chỉ với vài dòng. App có hai tab, mỗi tab gọi một hàm bạn vừa viết:
# BÀI TẬP 3 — Bước 5: đóng gói thành Web App bằng Gradio
!pip install -q gradio
import gradio as gr

def app_tim_do_an(cau_hoi, k):
    bang = tim_do_an(cau_hoi, int(k))[["ma", "ten_do_an", "do_tuong_tu"]]   # bỏ cột mô tả cho gọn
    return bang, tao_prompt(cau_hoi, int(k))

def app_tim_jd(cv, k):
    return tim_jd(cv, int(k))[["ma", "vi_tri", "do_phu_hop"]]

tab1 = gr.Interface(
    fn=app_tim_do_an,
    inputs=[gr.Textbox(value="app gọi món ăn ở canteen", label="Bạn muốn tìm đồ án về…"),
            gr.Slider(1, 5, value=3, step=1, label="k — số kết quả")],
    outputs=[gr.Dataframe(label="Đồ án giống nhất (theo cosine)"),
             gr.Textbox(label="Prompt RAG — sao chép sang ChatGPT / Gemini", lines=10)],
    flagging_mode="never",
)
tab2 = gr.Interface(
    fn=app_tim_jd,
    inputs=[gr.Textbox(value="Em hay viết Python, từng làm chatbot trả lời câu hỏi bằng tiếng Việt",
                       label="Dán vài dòng giới thiệu bản thân / CV", lines=4),
            gr.Slider(1, 5, value=3, step=1, label="k — số JD")],
    outputs=gr.Dataframe(label="JD phù hợp nhất"),
    flagging_mode="never",
)
demo = gr.TabbedInterface([tab1, tab2], ["🔎 Tìm đồ án theo nghĩa", "🤝 So khớp CV ↔ JD"],
                          title="🧭 Máy tìm kiếm ngữ nghĩa — Toán AI 2026")
demo.launch(share=True)
App hiện ngay bên dưới ô code, kèm một link công khai dạng …gradio.live để gửi cho bạn bè (tồn tại tối đa 1 tuần, mất khi tắt Colab). Tab đầu là app ở ảnh đầu bài: gõ ý tưởng, kéo thanh k, bấm Submit. Tab thứ hai nhận vài dòng giới thiệu bản thân và trả về JD phù hợp nhất.
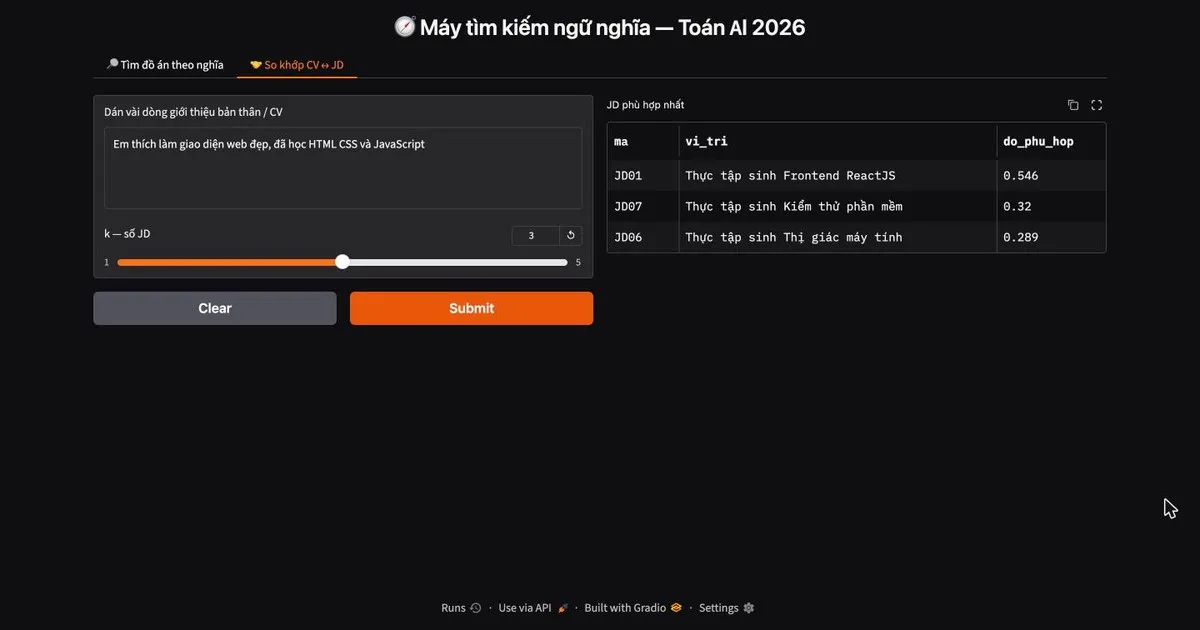
Hãy thử dán đoạn giới thiệu của chính bạn và xem kết quả có hợp lý không.
Bước 6: tự kiểm tra 8 câu
Đoạn code dưới đây chạy 8 câu thử (4 câu tìm đồ án, 4 đoạn giới thiệu bản thân) và so kết quả số 1 với đáp án mong đợi.
# BÀI TẬP 3 — Bước 6: Tự kiểm tra (không cần giao diện)
kiem_thu_da = [
    ("app gọi món ăn ở canteen", "DA01"),
    ("đọc chữ trên bảng số ô tô", "DA04"),
    ("phần mềm ghi lại tiền tiêu vặt", "DA10"),   # câu mà bài trước tìm sai!
    ("tìm nhà thuê", "DA16"),
]
kiem_thu_jd = [
    ("Em thích làm giao diện web đẹp, đã học HTML CSS và JavaScript", "JD01"),
    ("Em giỏi Excel và thích làm báo cáo số liệu", "JD04"),
    ("Em hay viết Python, từng làm chatbot trả lời câu hỏi bằng tiếng Việt", "JD05"),
    ("Em thích tìm lỗi phần mềm, cẩn thận và tỉ mỉ", "JD07"),
]
dung = 0
for cau, ky_vong in kiem_thu_da:
    r = tim_do_an(cau, 1).iloc[0]
    ok = r["ma"] == ky_vong; dung += ok
    print("✅" if ok else "❌", f"{cau:40s} → {r['ma']} {r['ten_do_an']} ({r['do_tuong_tu']})")
for cau, ky_vong in kiem_thu_jd:
    r = tim_jd(cau, 1).iloc[0]
    ok = r["ma"] == ky_vong; dung += ok
    print("✅" if ok else "❌", f"{cau[:40]:40s} → {r['ma']} {r['vi_tri']} ({r['do_phu_hop']})")
print(f"\nĐúng {dung}/8")Kết quả:
✅ app gọi món ăn ở canteen                 → DA01 Ứng dụng đặt đồ ăn trong căng tin (0.627)
✅ đọc chữ trên bảng số ô tô                → DA04 Nhận diện biển số xe ở bãi gửi xe (0.654)
✅ phần mềm ghi lại tiền tiêu vặt           → DA10 App theo dõi chi tiêu cá nhân (0.672)
✅ tìm nhà thuê                             → DA16 Ứng dụng tìm phòng trọ gần trường (0.518)
✅ Em thích làm giao diện web đẹp, đã học H → JD01 Thực tập sinh Frontend ReactJS (0.546)
✅ Em giỏi Excel và thích làm báo cáo số li → JD04 Thực tập sinh Phân tích dữ liệu (0.602)
✅ Em hay viết Python, từng làm chatbot trả → JD05 Thực tập sinh AI xử lý ngôn ngữ (0.8)
✅ Em thích tìm lỗi phần mềm, cẩn thận và t → JD07 Thực tập sinh Kiểm thử phần mềm (0.641)

Đúng 8/8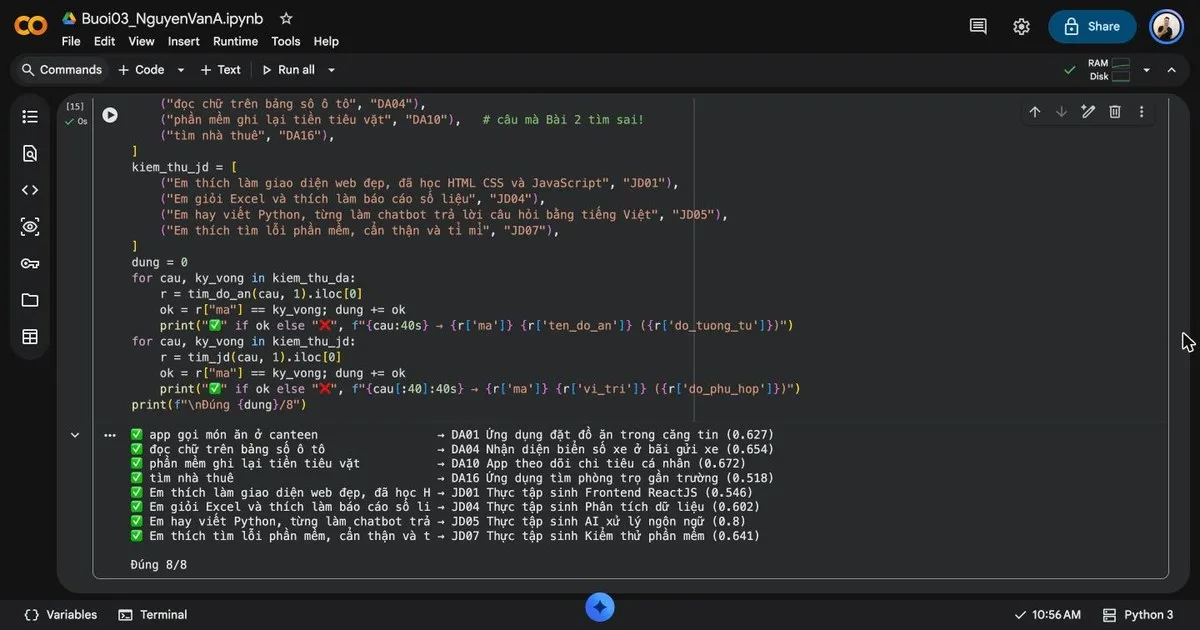
Nếu có dấu ❌, xem bảng lỗi bên dưới (thường là quên [::-1] hoặc truyền nhầm E_da cho tim_jd). Để ý "tìm nhà thuê" → phòng trọ, "bảng số ô tô" → biển số xe: không trùng chữ, nhưng máy vẫn hiểu.
Lỗi thường gặp
| Thông báo lỗi / hiện tượng | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'mo_hinh' is not defined |
Chưa chạy Bước 1, hoặc máy chủ vừa khởi động lại | Chạy lần lượt 2 ô %%writefile → Bước 1 → Bước 2 → Bước 3 |
Warning: You are sending unauthenticated requests to the HF Hub |
Tải mô hình không cần đăng nhập Hugging Face | Không phải lỗi, bỏ qua |
FileNotFoundError: do_an.csv |
Chưa chạy ô %%writefile, hoặc máy chủ vừa khởi động lại |
Chạy lại 2 ô %%writefile |
| Kết quả là đồ án KÉM giống nhất | Quên [::-1] nên lấy cosine nhỏ nhất |
Dùng np.argsort(diem)[::-1][:k] |
| Tab CV ↔ JD trả về tên đồ án | tim_jd truyền nhầm E_da |
Đổi thành E_jd |
| Link Gradio hết hạn | Link share tồn tại tối đa 1 tuần và mất khi tắt Colab | Chạy lại ô demo.launch(share=True) |
Tự luyện thêm
- Thử câu "máy tự trả lời thắc mắc của học sinh muốn vào trường". Kết quả số 1 là "Hỏi đáp quy chế đào tạo" chứ không phải "Chatbot tư vấn tuyển sinh". Vì sao? Gợi ý: so sánh chữ trong câu hỏi với mô tả của DA21 và DA03. Thử sửa mô tả của một đồ án rồi chạy lại Bước 2 để kết quả đúng hơn.
- Thêm 3 đồ án của chính bạn hoặc bạn bè vào
do_an.csv, chạy lại Bước 2 và tìm thử bằng lời của mình. - Thêm ngưỡng: chỉ hiện kết quả có cos ≥ 0.4, nếu không có kết quả nào thì báo "Không tìm thấy đồ án phù hợp". Đây là cách chatbot thật tránh trả lời bừa.
- Trả lời ngắn bằng lời của bạn: vì sao khi so sánh câu chữ, ta dùng cosine thay vì khoảng cách Euclid? (Gợi ý: nhớ lại chuyện An và Bình ở Bài 6.)
Tóm tắt
- Embedding biến mỗi câu thành một vector cố định 384 số sao cho câu cùng nghĩa thì vector cùng hướng, kể cả khác chữ, khác ngôn ngữ.
- Tìm kiếm ngữ nghĩa = nhúng sẵn kho tài liệu một lần, nhúng câu hỏi, tính cosine, lấy top-k. Công thức y hệt bài đếm từ, chỉ đổi cách biến chữ thành số.
- RAG = Retrieve (tìm tài liệu) → Augment (ghép vào prompt) → Generate (để mô hình ngôn ngữ trả lời), giúp AI trả lời dựa trên tài liệu của bạn và có trích dẫn.
| Ký hiệu Toán | Cách đọc | Lệnh NumPy / Python |
|---|---|---|
| 𝐪, 𝐞ᵢ | "vector q", "vector e i" | mo_hinh.encode("câu") |
| 𝐞ᵢ ∈ ℝ³⁸⁴ | "e i thuộc R mũ 384" | v.shape → (384,) |
| 𝐄 (30 hàng × 384 cột) | "ma trận E" | E_da = mo_hinh.encode(danh_sach_cau) |
| cos(𝐪, 𝐞ᵢ) | "cô-sin của q và e i" | cosine(e, q) |
| cos θ = 𝐚·𝐛 / (‖𝐚‖‖𝐛‖) | "cô-sin tê-ta bằng a nhân vô hướng b chia chuẩn a nhân chuẩn b" | np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)) |
| Top-k lớn nhất | "tóp ca": k tài liệu có cos lớn nhất | np.argsort(diem)[::-1][:k] |
Bài tiếp theo trong series: mình sẽ chuyển từ vector sang ma trận: nhân ma trận, xem ma trận "biến hình" không gian ra sao, và gặp hai khái niệm nổi tiếng là vector riêng và trị riêng.
