Lan truyền ngược bằng NumPy: nơ-ron truy tìm thủ phạm và tự sửa sai
Trong bài này
Series · Bài 12/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
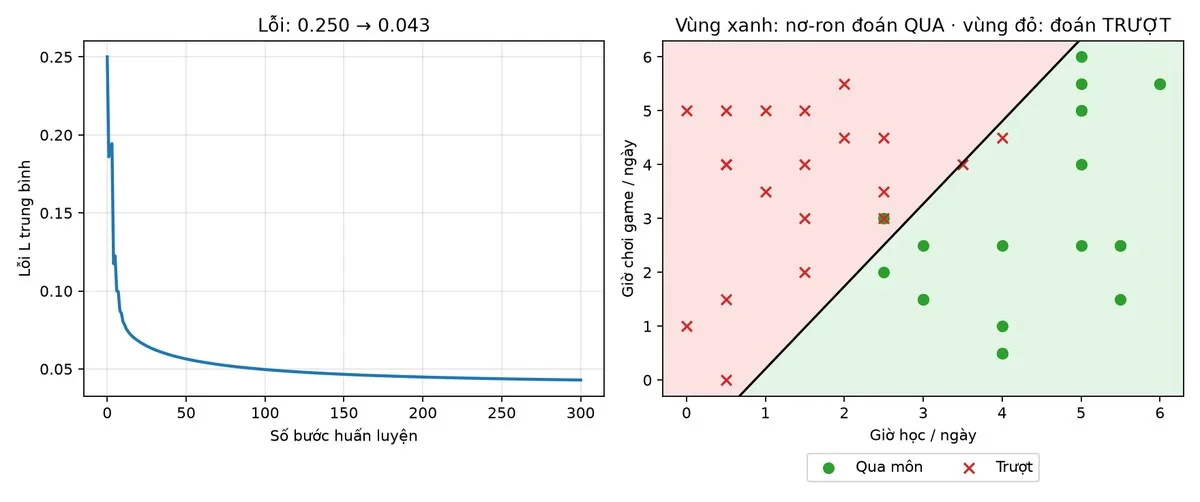
AI "học" bằng cách nào? Không có phép màu: nó đoán, đo xem sai bao nhiêu, truy ngược xem tham số nào gây ra cái sai đó, rồi nhích tham số ấy một chút theo hướng ít sai hơn — lặp lại vài trăm lần. Cách truy ngược đó gọi là lan truyền ngược (backpropagation — bách-prô-pa-ghê-sần), và nó chỉ dùng đúng đạo hàm riêng với chain rule mà bạn đã học ở bài trước.
Trong bài cuối của series, bạn sẽ tự viết lan truyền ngược cho một nơ-ron, cho nó "truy tìm thủ phạm" gây lỗi, rồi huấn luyện nó trên 40 sinh viên để dự đoán khả năng qua môn của chính bạn — tất cả gói trong một Web App. Đây là thứ bạn sẽ làm ra:
Chuẩn bị
Mở notebook Colab (cô-láp) của bài: Notebook Lab 5 — Lan truyền ngược & Web App → File › Save a copy in Drive → bấm Connect. Bạn cũng có thể tạo notebook mới rồi dán từng ô code trong bài.
- Bài này dùng lại hàm
sigmoidvà ý tưởng chain rule của bài trước. Nếu notebook mới, hãy chạy ô A1 – A4 trước (hoặc ít nhất định nghĩasigmoidnhư trong code bên dưới). - Ô đầu tiên dùng thư viện PyTorch (pai-torch), có sẵn trên Colab, import mất vài giây. Web App dùng Gradio (gra-đi-ô), cài mất khoảng 10–30 giây.
- Trong code:
y_mulà ŷ (đọc: "y mũ"),dL_dwlà ∂L/∂w (đọc: "đạo hàm riêng của L theo w").
💡 Notebook có sẵn các ô "🔑 Đáp án". Tự gõ khung code trước, chạy được rồi hãy mở đáp án ra đối chiếu.
Một nơ-ron = một dây chuyền 3 khâu
Bài nhóm bị điểm thấp. Truy ngược: điểm ← phần trình bày ← nội dung slide ← người viết từng phần. Mỗi khâu nhân thêm "mức ảnh hưởng" của nó; ai có tích lớn nhất là "thủ phạm" chính. Lan truyền ngược trong AI làm đúng như vậy, chỉ là với các con số w, b.
Ví dụ: một bạn ôn bài x = 2 giờ mỗi ngày và qua môn (y = 1). Nơ-ron đang có w = 0.5, b = −1. Nó là dây chuyền 3 khâu:
z = w·x + b → ŷ = σ(z) → L = (ŷ − y)²
Đọc: "z bằng w nhân x cộng b; y mũ bằng xích-ma của z; L bằng y mũ trừ y, bình phương" — ŷ là xác suất nơ-ron đoán, L là lỗi (loss), càng nhỏ càng tốt.
| Đi xuôi | Giá trị | Đi ngược (đạo hàm từng khâu) | Giá trị |
|---|---|---|---|
| z = w·x + b | 0 | ∂z/∂w = x; ∂z/∂b = 1 | 2; 1 |
| ŷ = σ(z) | 0.5 | ∂ŷ/∂z = ŷ(1 − ŷ) | 0.25 |
| L = (ŷ − y)² | 0.25 | ∂L/∂ŷ = 2(ŷ − y) | −1 |
Nhân dồn đạo hàm các khâu từ cuối về đầu (chain rule):
∂L/∂w = (−1) × 0.25 × 2 = −0.5 ∂L/∂b = (−1) × 0.25 × 1 = −0.25
Đọc: "đạo hàm riêng của L theo w" — nhân dồn đạo hàm các khâu từ cuối về đầu.
Đọc kết quả: cả hai đạo hàm đều âm → tăng w, b thì lỗi giảm. |−0.5| (đọc: "trị tuyệt đối của âm 0.5") lớn gấp đôi |−0.25| → w là "thủ phạm" chính. Sửa một bước bằng cách nhích ngược dấu đạo hàm:
w mới = w − bước nhích × ∂L/∂w
Đọc: "w mới bằng w trừ bước nhích nhân đạo hàm riêng của L theo w". Với bước nhích 1.0: w mới = 0.5 − (−0.5) = 1.0, b mới = −0.75.
# [A5]: Một nơ-ron = một dây chuyền 3 khâu:  z = w·x + b  →  ŷ = σ(z)  →  L = (ŷ − y)²
# x = 2 giờ ôn bài mỗi ngày, bạn đó QUA môn (y = 1). Nơ-ron đang có w = 0.5, b = −1
import numpy as np
sigmoid = lambda z: 1 / (1 + np.exp(-z))
x, y = 2, 1
w, b = 0.5, -1.0

# Đi xuôi (forward): tính dự đoán và lỗi
z = w * x + b                     # 0.0
y_mu = sigmoid(z)                 # ŷ ("y mũ") = 0.5
L = (y_mu - y) ** 2               # lỗi = 0.25
print(f"Đi xuôi : z = {z},  ŷ = {y_mu},  L = {L}")

# Đi ngược (backward): đạo hàm từng khâu, nhân dồn từ cuối về đầu
dL_dy = 2 * (y_mu - y)            # khâu 3: −1
dy_dz = y_mu * (1 - y_mu)         # khâu 2: 0.25
dL_dw = dL_dy * dy_dz * x         # khâu 1: ∂z/∂w = x  →  −0.5
dL_db = dL_dy * dy_dz * 1         #         ∂z/∂b = 1  →  −0.25
print(f"Đi ngược: dL/dŷ = {dL_dy},  dŷ/dz = {dy_dz}  →  ∂L/∂w = {dL_dw},  ∂L/∂b = {dL_db}")

# Kiểm tra bằng số: nhích w (hoặc b) một chút xem lỗi đổi bao nhiêu
loi = lambda w, b: (sigmoid(w * x + b) - y) ** 2
h = 1e-6
print("Bằng số : ∂L/∂w ≈", round((loi(w + h, b) - loi(w, b)) / h, 4), "  ∂L/∂b ≈", round((loi(w, b + h) - loi(w, b)) / h, 4))

# Thư viện AI (PyTorch) tính đúng như vậy bằng lệnh .backward()
import torch
wt = torch.tensor(w, requires_grad=True)
bt = torch.tensor(b, requires_grad=True)
Lt = (torch.sigmoid(wt * x + bt) - y) ** 2
Lt.backward()
print("PyTorch : ∂L/∂w =", wt.grad.item(), "  ∂L/∂b =", bt.grad.item())

# Sửa 1 bước: đạo hàm âm → tăng w, b thì lỗi giảm.  Nhích NGƯỢC dấu đạo hàm
w_moi = w - 1.0 * dL_dw
b_moi = b - 1.0 * dL_db
print(f"\nSau 1 bước sửa: w = {w_moi}, b = {b_moi} → ŷ = {sigmoid(w_moi * x + b_moi):.3f}, L = {loi(w_moi, b_moi):.4f} (trước: {L})")Kết quả:
Đi xuôi : z = 0.0,  ŷ = 0.5,  L = 0.25
Đi ngược: dL/dŷ = -1.0,  dŷ/dz = 0.25  →  ∂L/∂w = -0.5,  ∂L/∂b = -0.25
Bằng số : ∂L/∂w ≈ -0.5   ∂L/∂b ≈ -0.25
PyTorch : ∂L/∂w = -0.5   ∂L/∂b = -0.25

Sau 1 bước sửa: w = 1.0, b = -0.75  →  ŷ = 0.777,  L = 0.0496  (trước: 0.25)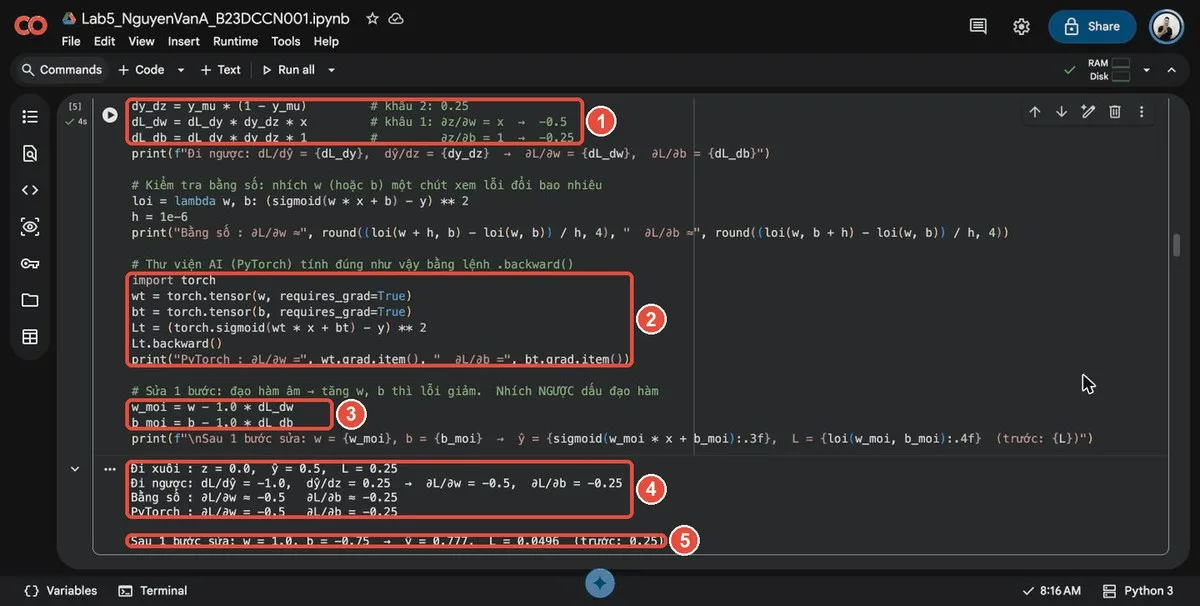
Ba cách — tính tay, nhích bằng số, và PyTorch — ra cùng một con số. Nghĩa là thứ các thư viện AI làm trong lệnh .backward() không có gì bí ẩn: đó chính là chain rule bạn vừa viết bằng 4 dòng.
💡 Tự kiểm tra: nếu ∂L/∂w = +0.8 thì nên tăng hay giảm w? (Giảm — luôn đi ngược dấu đạo hàm.)
Viết hàm lan truyền ngược: ai là "thủ phạm"?
Giờ nơ-ron có 2 đầu vào: x = [giờ học / ngày, giờ chơi game / ngày]. Nó đang "chưa học": w = [0.2, 0.4], b = −1 — tức là còn tin rằng chơi game giúp qua môn (trọng số game còn lớn hơn trọng số học)! Nhiệm vụ: viết hàm lan_truyen_nguoc tính ∂L/∂w₁, ∂L/∂w₂, ∂L/∂b cho 3 bạn, kiểm tra bằng số, rồi chỉ ra thủ phạm.
∂L/∂wᵢ = 2(ŷ − y) · ŷ(1 − ŷ) · xᵢ ∂L/∂b = 2(ŷ − y) · ŷ(1 − ŷ) · 1
Đọc: "đạo hàm riêng của L theo w i bằng hai nhân y mũ trừ y, nhân y mũ nhân một trừ y mũ, nhân x i" — wᵢ, xᵢ (đọc: "w i", "x i") là trọng số và đầu vào thứ i.
| Bạn | x = [học, game] | Kết quả thật y | Ý nghĩa |
|---|---|---|---|
| An | [3, 1] | 1 (qua) | Học nhiều, chơi ít |
| Bình | [1, 4] | 0 (trượt) | Học ít, chơi nhiều |
| Chi | [2, 2] | 1 (qua) | Cân bằng |
Các bước: khâu 3 (lỗi) dL_dy = 2 * (y_mu - y) → khâu 2 (sigmoid) dy_dz = y_mu * (1 - y_mu) → chain rule dL_dz = dL_dy * dy_dz → khâu 1 dL_dw = dL_dz * x (cả mảng 2 số một lúc) và dL_db = dL_dz * 1.
# BÀI TẬP 2 — KHUNG CODE: điền vào chỗ ____
import numpy as np
sigmoid = lambda z: 1 / (1 + np.exp(-z))

def di_xuoi(x, w, b):
    return sigmoid(np.dot(w, x) + b)                # ŷ = σ(w·x + b)

def lan_truyen_nguoc(x, y, w, b):
    y_mu = di_xuoi(x, w, b)
    L = (y_mu - y) ** 2
    dL_dy = 2 * (____ - y)                          # khâu 3: L = (ŷ − y)²
    dy_dz = y_mu * (1 - ____)                       # khâu 2: ŷ = σ(z)
    dL_dz = dL_dy * ____                            # chain rule: nhân dồn
    dL_dw = dL_dz * ____                            # khâu 1: ∂z/∂wᵢ = xᵢ  (cả mảng 2 số)
    dL_db = dL_dz * ____                            #         ∂z/∂b = 1
    return L, dL_dw, dL_db

# Kiểm tra bằng số: nhích từng tham số một chút (đạo hàm riêng)
def dao_ham_bang_so(x, y, w, b, h=1e-6):
    loi = lambda w, b: (di_xuoi(x, w, b) - y) ** 2
    return [(loi(w + [h, 0], b) - loi(w, b)) / h, (loi(w + [0, h], b) - loi(w, b)) / h, (loi(w, b + h) - loi(w, b)) / h]

w, b = np.array([0.2, 0.4]), -1.0                   # nơ-ron "chưa học": còn tin chơi game giúp qua môn!
TEN_TS = ["w₁ (giờ học)", "w₂ (giờ game)", "b"]
for ten, x, y in [("An", [3, 1], 1), ("Bình", [1, 4], 0), ("Chi", [2, 2], 1)]:
    L, dw, db = lan_truyen_nguoc(np.array(x), y, w, b)
    dao = np.array([*dw, db])
    so = np.array(dao_ham_bang_so(np.array(x), y, w, b))
    thu_pham = TEN_TS[np.argmax(np.abs(dao))]
    print(f"{ten:5s} x = {x}, y = {y}:  ŷ = {di_xuoi(np.array(x), w, b):.3f}, L = {L:.3f}")
    print(f"      ∂L/∂w₁ = {dao[0]:7.4f}  ∂L/∂w₂ = {dao[1]:7.4f}  ∂L/∂b = {dao[2]:7.4f}",
          "✅ khớp bằng số" if np.allclose(dao, so, atol=1e-4) else "❌ lệch bằng số", f"→ thủ phạm: {thu_pham}")
Xem đáp án
def lan_truyen_nguoc(x, y, w, b):
    y_mu = di_xuoi(x, w, b)
    L = (y_mu - y) ** 2
    dL_dy = 2 * (y_mu - y)
    dy_dz = y_mu * (1 - y_mu)
    dL_dz = dL_dy * dy_dz
    dL_dw = dL_dz * x
    dL_db = dL_dz * 1
    return L, dL_dw, dL_db
Kết quả:
An    x = [3, 1], y = 1:  ŷ = 0.500, L = 0.250
      ∂L/∂w₁ = -0.7500  ∂L/∂w₂ = -0.2500  ∂L/∂b = -0.2500 ✅ khớp bằng số → thủ phạm: w₁ (giờ học)
Bình  x = [1, 4], y = 0:  ŷ = 0.690, L = 0.476
      ∂L/∂w₁ =  0.2952  ∂L/∂w₂ =  1.1807  ∂L/∂b =  0.2952 ✅ khớp bằng số → thủ phạm: w₂ (giờ game)
Chi   x = [2, 2], y = 1:  ŷ = 0.550, L = 0.203
∂L/∂w₁ = -0.4457 ∂L/∂w₂ = -0.4457 ∂L/∂b = -0.2228 ✅ khớp bằng số → thủ phạm: w₁ (giờ học)- An qua môn nhưng nơ-ron chỉ đoán 50%: ∂L/∂w₁ âm và lớn nhất → cần tăng trọng số giờ học.
- Bình trượt nhưng nơ-ron đoán 69% qua: thủ phạm là w₂ (dương, 1.1807) → cần giảm trọng số giờ game.
- Chi: ∂L/∂w₁ và ∂L/∂w₂ bằng nhau vì Chi học và chơi bằng nhau (x₁ = x₂ = 2); khi hòa,
np.argmaxchọn tham số đứng trước là w₁.
Hai câu hỏi để nghĩ: (1) Vì sao ∂L/∂w₁ của An lớn gấp 3 lần ∂L/∂b? (2) Nếu một bạn có x = [0, 0] thì đạo hàm theo w₁, w₂ bằng bao nhiêu?
Xem gợi ý
(1) Hai đạo hàm có chung phần dL_dz, chỉ khác thừa số cuối: w₁ nhân với x₁ = 3, còn b nhân với 1. (2) Bằng 0, vì dL_dw = dL_dz * x mà x = [0, 0]: một đầu vào bằng 0 thì trọng số của nó không ảnh hưởng gì đến dự đoán, nên không thể là "thủ phạm" — chỉ còn b chịu trách nhiệm.
Mini-App: nơ-ron tự học trên 40 sinh viên
Tập đá phạt đền: sút → xem lệch trái hay phải bao nhiêu → chỉnh chân một chút ngược hướng lệch → sút lại. Lặp vài trăm lần thì vào. Nơ-ron "tập" cũng vậy. Bắt đầu từ w = [0, 0], b = 0 (chưa biết gì, đoán ai cũng 50%), mỗi bước huấn luyện lặp lại đúng 4 việc của nơ-ron ở trên nhưng cho cả 40 bạn một lúc: đi xuôi → đo lỗi → đi ngược → nhích w, b ngược dấu đạo hàm.
Dữ liệu 40 sinh viên
Mỗi dòng là một bạn: giờ học / ngày, giờ chơi game / ngày và kết quả qua môn (1) hay trượt (0). Ô %%writefile ghi dữ liệu thành file trên máy chủ Colab:
Ô tạo file qua_mon.csv (40 dòng)
%%writefile qua_mon.csv
ma,hoc,game,qua_mon
SV01,5,2.5,1
SV02,5,5,1
SV03,3,1.5,1
SV04,1.5,2,0
SV05,0.5,5,0
SV06,2.5,3,1
SV07,2.5,3,0
SV08,0.5,1.5,0
SV09,0.5,0,0
SV10,6,5.5,1
SV11,4,0.5,1
SV12,1.5,5,0
SV13,2.5,2,1
SV14,6,5.5,1
SV15,5.5,2.5,1
SV16,5,5.5,1
SV17,2.5,3.5,0
SV18,3,1.5,1
SV19,4,4.5,0
SV20,0.5,4,0
SV21,3.5,4,0
SV22,1.5,3,0
SV23,5.5,1.5,1
SV24,0.5,4,0
SV25,4,0.5,1
SV26,5,4,1
SV27,1.5,4,0
SV28,5.5,2.5,1
SV29,5,5,1
SV30,0,1,0
SV31,4,2.5,1
SV32,0,5,0
SV33,3,2.5,1
SV34,2.5,4.5,0
SV35,1,3.5,0
SV36,2,5.5,0
SV37,5,6,1
SV38,2,4.5,0
SV39,1,5,0
SV40,4,1,1
# Đọc dữ liệu thành ma trận
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
sigmoid = lambda z: 1 / (1 + np.exp(-z))
df = pd.read_csv("qua_mon.csv")
X = df[["hoc", "game"]].values.astype(float) # ma trận 40 × 2
y = df["qua_mon"].values # 40 số 0 / 1
n = len(X)
print("X.shape:", X.shape, " · số bạn qua môn:", y.sum(), "/", n)Kết quả:
X.shape: (40, 2) · số bạn qua môn: 20 / 40Hàm huấn luyện: 4 việc, lặp 300 lần
Mẹo để làm cho 40 bạn một lúc mà không cần vòng lặp: X @ w (nhân ma trận với vector — Bài 9 của series) cho ra 40 giá trị z; X.T @ dL_dz / n cộng đạo hàm theo w của 40 bạn rồi chia trung bình.
# KHUNG CODE hàm huấn luyện, điền vào chỗ ____
def huan_luyen(so_buoc=300, buoc_nhich=1.0):
    w, b = np.zeros(2), 0.0
    lich_su = []                                        # lỗi sau mỗi bước
    for t in range(so_buoc + 1):
        y_mu = sigmoid(X @ ____ + b)                    # 1. đi xuôi: dự đoán cho 40 bạn
        L = np.mean((y_mu - y) ** 2)                    # 2. lỗi trung bình
        lich_su.append(L)
        if t == so_buoc: break
        dL_dz = 2 * (y_mu - y) * ____ * (1 - y_mu)      # 3. đi ngược: chain rule cho từng bạn
        dw = X.T @ dL_dz / n                            #    trung bình ∂L/∂w của 40 bạn
        db = dL_dz.mean()                               #    trung bình ∂L/∂b
        w = w - buoc_nhich * ____                       # 4. nhích NGƯỢC dấu đạo hàm
        b = b - buoc_nhich * ____
    return w, b, lich_su

w, b, lich_su = huan_luyen(300, 1.0)
dung = np.mean((sigmoid(X @ w + b) > 0.5) == y)
print("w =", w.round(3), " b =", round(b, 3))
print(f"Lỗi: {lich_su[0]:.3f} (lúc đầu)  →  {lich_su[-1]:.3f} (sau 300 bước)  ·  đoán đúng {dung:.1%}")
Xem đáp án
Các chỗ trống lần lượt là w, y_mu, dw, db:
        y_mu = sigmoid(X @ w + b)
        dL_dz = 2 * (y_mu - y) * y_mu * (1 - y_mu)
        w = w - buoc_nhich * dw
        b = b - buoc_nhich * db
Kết quả:
w = [ 2.465 -1.608]  b = -2.134
Lỗi: 0.250 (lúc đầu) → 0.043 (sau 300 bước) · đoán đúng 92.5%Nơ-ron tự rút ra điều mà ai cũng biết: w₁ = 2.465 dương (học làm tăng khả năng qua môn), w₂ = −1.608 âm (chơi game làm giảm). Không ai dạy nó luật này — nó tự tìm ra từ 40 ví dụ, nhờ đạo hàm. Biểu đồ ở đầu bài chính là kết quả này: lỗi giảm rất nhanh trong khoảng 20 bước đầu rồi chậm dần; đường đen là nơi ŷ = 0.5, vài điểm nằm sai vùng chính là 7.5% đoán sai.
💡 Kiểu "đi xuống dốc theo đạo hàm, từng bước một" này có tên là gradient descent (gờ-rây-đi-ần đi-xen). Các mô hình AI lớn cũng được huấn luyện theo đúng tinh thần đó, chỉ với hàng triệu tham số thay vì 3.
Dự đoán cho chính bạn
# KHUNG CODE dự đoán, điền vào chỗ ____
def du_doan(hoc, game, w, b):
    z = w[0] * hoc + w[1] * ____ + ____           # z = w₁·học + w₂·game + b
    return sigmoid(____)                          # xác suất qua môn

toi = [3, 2]                                      # [giờ học, giờ game] mỗi ngày — sửa thành của bạn!
p = du_doan(toi[0], toi[1], w, b)
print(f"Học {toi[0]} giờ, chơi game {toi[1]} giờ mỗi ngày  →  xác suất qua môn: {p:.1%}")
Xem đáp án
def du_doan(hoc, game, w, b):
    z = w[0] * hoc + w[1] * game + b
    return sigmoid(z)
Kết quả:
Học 3 giờ, chơi game 2 giờ mỗi ngày → xác suất qua môn: 88.5%Đóng gói thành Web App
Web App có 2 tab: Truy tìm thủ phạm (nhập giờ học, giờ game, kết quả thật và w₁, w₂, b → xem bảng đi xuôi, đi ngược và tham số gây lỗi nhiều nhất) và Huấn luyện nơ-ron (chọn số bước, bước nhích, giờ học/game của bạn → xem đường lỗi, vùng qua/trượt và ngôi sao là bạn). Phần giao diện khá dài nên mình chỉ trích phần "bộ não" bên dưới; ô đầy đủ (kèm hàm vẽ ve_ket_qua) có sẵn trong notebook — bạn chỉ cần chạy.
# Trích đoạn ô Web App — bản đầy đủ có trong notebook
!pip install -q gradio
import gradio as gr

def app_thu_pham(hoc, game, ket_qua, w1, w2, b0):
    x, yy, ww = np.array([hoc, game], float), 1 if ket_qua == "Qua môn" else 0, np.array([w1, w2], float)
    L, dw, db = lan_truyen_nguoc(x, yy, ww, b0)          # dùng lại hàm vừa viết
    dao = np.array([dw[0], dw[1], db])
    ten = ["w₁ (giờ học)", "w₂ (giờ game)", "b"]
    k = int(np.argmax(np.abs(dao)))                     # thủ phạm = |đạo hàm| lớn nhất
    huong = "giảm" if dao[k] > 0 else "tăng"            # đi ngược dấu đạo hàm
    ...                                                 # tạo bảng Markdown + biểu đồ thanh, trả về

def app_huan_luyen(so_buoc, buoc_nhich, hoc, game):
    w, b, ls = huan_luyen(int(so_buoc), float(buoc_nhich))   # huấn luyện lại từ đầu
    ...                                                      # vẽ bằng ve_ket_qua, in lỗi & xác suất của bạn

# tab1, tab2 = gr.Interface(...) với các thanh trượt Slider, rồi ghép 2 tab:
demo = gr.TabbedInterface([tab1, tab2], ["🔍 Truy tìm thủ phạm", "🏋️ Huấn luyện nơ-ron"],
                          title="🧠 Nơ-ron học từ lỗi — Toán AI 2026")
demo.launch(share=True)Chạy ô này, app hiện ngay bên dưới, kèm một link công khai …gradio.live để mở ở tab mới hoặc gửi bạn bè (link tồn tại tối đa 1 tuần và mất khi tắt Colab).
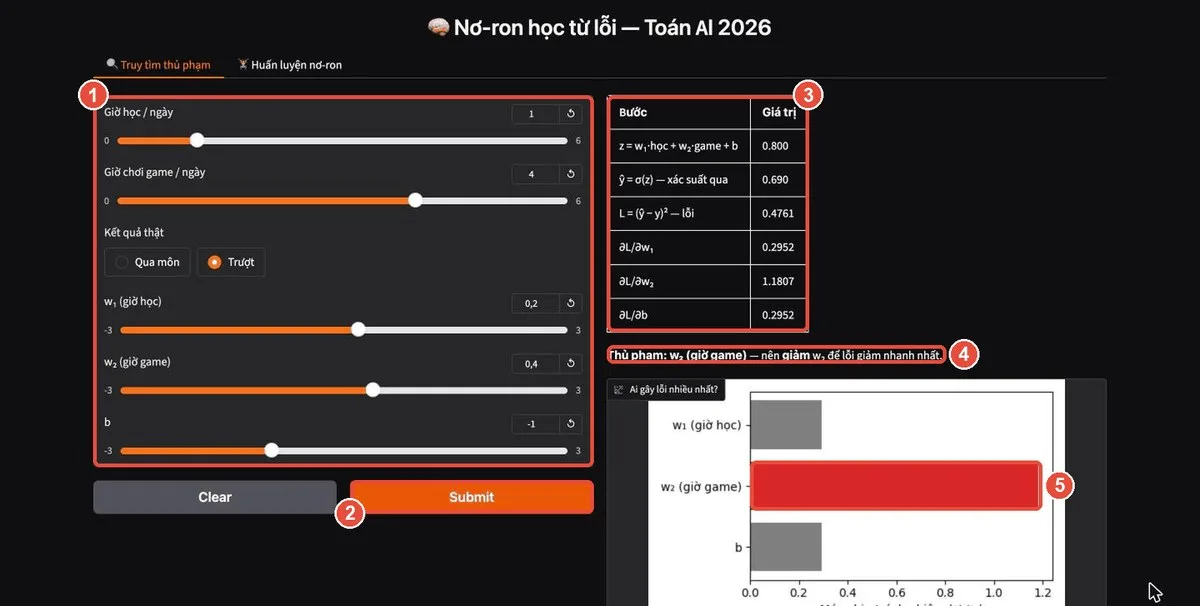
Thử ngay vài thí nghiệm:
- Tab Huấn luyện, đổi bước nhích thành 0.1: sau 300 bước lỗi mới xuống 0.064 (thay vì 0.043) — nhích quá nhỏ thì học chậm.
- Đổi số bước thành 0: w = [0, 0], nơ-ron đoán ai cũng 50%.
- Tab Truy tìm thủ phạm, giữ số liệu bạn Bình nhưng đặt w₂ = −1.5 rồi Submit: nơ-ron đoán đúng là trượt, lỗi và cả 3 đạo hàm gần bằng 0 — đoán đúng thì gần như không còn gì để sửa.
Tự kiểm tra: kết quả của bạn nên khớp các con số dưới (có thể lệch ở chữ số thứ tư):
| Kiểm tra | Đầu vào | Mong đợi |
|---|---|---|
| An: ∂L/∂w₁ | x = [3, 1], y = 1, w = [0.2, 0.4], b = −1 | −0.750 |
| Bình: ∂L/∂w₂ · ∂L/∂b | x = [1, 4], y = 0, cùng w, b | 1.181 · 0.295 |
| Lỗi lúc đầu → sau huấn luyện | 0 bước → 300 bước, bước nhích 1 | 0.250 → 0.043 |
| Tỉ lệ đoán đúng · w₁ | sau 300 bước | 0.925 · 2.465 |
| Xác suất qua môn | học 3 giờ, game 2 giờ mỗi ngày | 0.885 |
Lỗi thường gặp
| Thông báo lỗi / hiện tượng | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'lan_truyen_nguoc' is not defined |
Chưa chạy ô lan truyền ngược trước Web App, hoặc máy chủ vừa khởi động lại | Chạy ô hàm lan_truyen_nguoc (hoặc ô đáp án của nó) rồi chạy lại |
FileNotFoundError: qua_mon.csv |
Chưa chạy ô %%writefile |
Chạy lại ô %%writefile → ô đọc dữ liệu → ô huấn luyện |
| Báo "❌ lệch bằng số" | Sai một khâu, thường là dy_dz hoặc quên nhân x |
Đối chiếu: y_mu * (1 - y_mu) và dL_dz * x |
| Lỗi TĂNG dần khi huấn luyện | Viết w + buoc_nhich * dw (cộng) |
Phải TRỪ: đi ngược dấu đạo hàm |
ValueError: matmul: … mismatch |
Viết X @ dL_dz thay vì X.T @ dL_dz |
(2 × 40) @ (40,) mới khớp — cần .T |
| Link Gradio hết hạn | Link share tồn tại tối đa 1 tuần và mất khi tắt Colab | Chạy lại ô demo.launch(share=True) |
Tự luyện thêm
- Thử bước nhích 5 với 300 bước. Lỗi cuối cùng thế nào so với bước nhích 1? Đường lỗi có còn trơn không?
- Thêm cột thứ ba "giờ ngủ / ngày" (tự bịa số cho 40 bạn), sửa
w = np.zeros(3). Cần sửa thêm dòng nào khác không? (Gợi ý: nhờX @ wvàX.T @ dL_dz, gần như không cần.) - Trong
huan_luyen, in ra thủ phạm (tham số có |đạo hàm| lớn nhất) ở bước 0, 10, 100. Thủ phạm có đổi theo thời gian không? - Viết lại bài huấn luyện bằng PyTorch: dùng
torch.tensor(..., requires_grad=True)và.backward()thay cho đạo hàm tự viết, so w sau 300 bước.
Tóm tắt & nhìn lại hành trình 12 bài
Lan truyền ngược chỉ là chain rule áp dụng có hệ thống: đi xuôi để tính dự đoán và lỗi, đi ngược để nhân dồn đạo hàm từng khâu, tham số có |đạo hàm| lớn nhất là "thủ phạm", rồi nhích mọi tham số ngược dấu đạo hàm. Lặp lại vài trăm lần, nơ-ron tự học.
| Ký hiệu Toán | Cách đọc | Lệnh NumPy / Python |
|---|---|---|
| ŷ | "y mũ" | y_mu |
| L = (ŷ − y)² | "L bằng y mũ trừ y, bình phương" | (y_mu - y) ** 2 |
| ∂L/∂w | "đạo hàm riêng của L theo w" | dL_dw |
| σ(z)(1 − σ(z)) | "xích-ma nhân một trừ xích-ma" | y_mu * (1 - y_mu) |
| |a| | "trị tuyệt đối của a" | np.abs(a) |
| w − bước · ∂L/∂w | "w trừ bước nhích nhân đạo hàm" | w - buoc_nhich * dw |
| Xᵀ · (∂L/∂z) | "X chuyển vị nhân đạo hàm của L theo z" | X.T @ dL_dz / n |
| — | Thư viện tự đi ngược | L.backward() (PyTorch) |
Đây cũng là bài cuối của series "Toán AI thực chiến". Nhìn lại, bạn đã đi qua 5 chặng:
| Chặng | Bài | Bạn đã làm được |
|---|---|---|
| Vector & ma trận | 1 – 2 | Đọc ký hiệu ∑, x̄, 𝐱 ∈ ℝⁿ bằng NumPy; công thức một nơ-ron ŷ = w·x + b; coi ảnh là ma trận để "cứu sáng"; Web App chấm điểm CV |
| Hàm số & khoảng cách | 3 – 5 | Hàm Sigmoid biến điểm số thành xác suất; khoảng cách, chuẩn hóa và KNN tính tay; app định giá laptop cũ |
| Cosine & tìm kiếm ngữ nghĩa | 6 – 8 | Tích vô hướng, độ tương tự cosine; biến chữ thành vector; embedding (nhúng) và RAG để tìm đồ án, so khớp CV với JD |
| Nhân ma trận & PCA | 9 – 10 | Ma trận "biến hình", vector riêng, trị riêng; tự viết PCA để vẽ bản đồ sinh viên 2D và nén ảnh |
| Đạo hàm & lan truyền ngược | 11 – 12 | Đạo hàm, đạo hàm riêng, chain rule; nơ-ron truy tìm thủ phạm và tự sửa sai |
Hãy nhìn lại hàm huan_luyen 15 dòng của bài này — nó dùng gần như cả series: X là ma trận 40 × 2 (Bài 1), X @ w và X.T là nhân ma trận, chuyển vị (Bài 9), sigmoid là hàm số (Bài 3), np.mean là x̄ (Bài 1), và dL_dz là chain rule (Bài 11). Toán trong AI không phải một núi công thức rời rạc — nó là vài viên gạch nhỏ, ghép lại thành một cỗ máy biết học.
Từ đây, khi đọc tài liệu về mạng nơ-ron, Transformer hay mô hình ngôn ngữ, bạn sẽ gặp lại đúng những viên gạch ấy: vector, nhân ma trận, cosine, đạo hàm và .backward(). Chúc bạn tiếp tục hành trình — và nhớ: khi sai, hãy đi ngược dấu đạo hàm.
