PCA từ A đến Z: tính tay, tự viết bằng NumPy, vẽ bản đồ sinh viên & nén ảnh
Trong bài này
- Chuẩn bị
- PCA tính tay: chọn "góc chụp" giữ nhiều thông tin nhất
- Tự viết PCA bằng NumPy: từ 3 chiều xuống 2 chiều
- Mini-App: bản đồ 60 sinh viên từ 6 chiều xuống 2 chiều
- Bước 1 — PCA 6 chiều → 2 chiều bằng thư viện
- Bước 2 — Vẽ bản đồ
- Bước 3 — Đoán nhóm của bạn
- Nén ảnh bằng PCA
- Đóng gói thành Web App bằng Gradio
- Lỗi thường gặp
- Tự luyện thêm
- Tóm tắt
Series · Bài 10/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
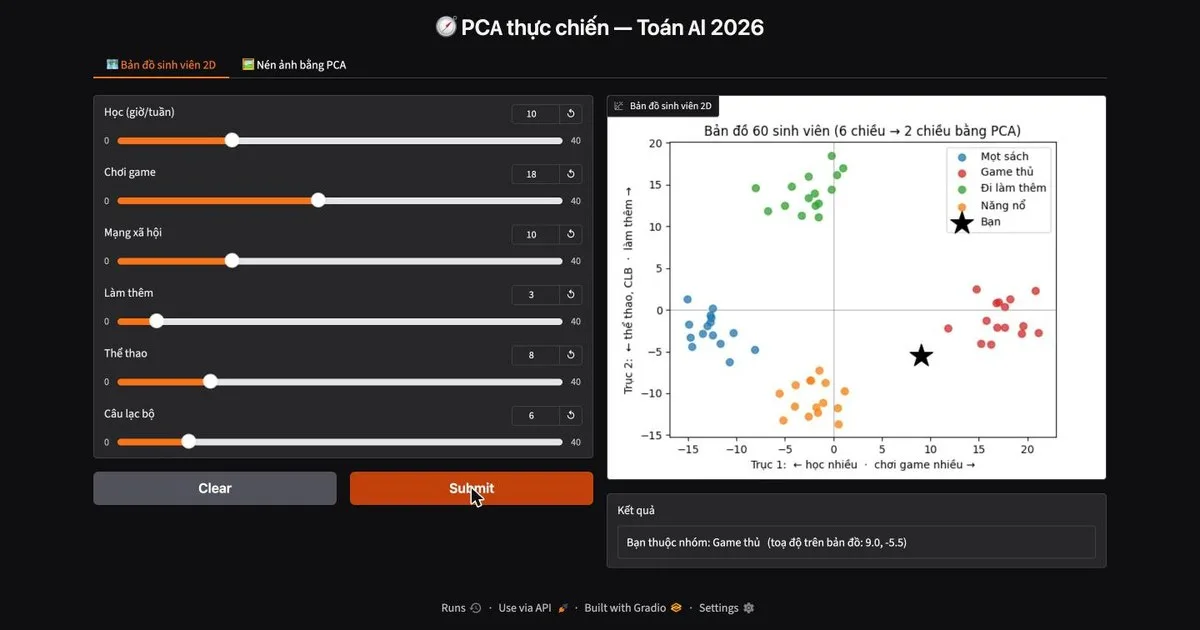
Mô tả một sinh viên bằng 6 con số (giờ học, chơi game, lướt mạng, làm thêm, thể thao, câu lạc bộ) thì không ai vẽ được. PCA (Principal Component Analysis — phân tích thành phần chính) ép dữ liệu nhiều chiều xuống còn 2–3 chiều mà vẫn giữ phần lớn thông tin, và nó chạy hoàn toàn bằng thứ bạn học ở bài trước: vector riêng và trị riêng.
Trong bài này, bạn sẽ tính PCA bằng tay với 5 con số, tự viết PCA 4 bước bằng NumPy, rồi làm một Web App hai chức năng: vẽ bản đồ 60 sinh viên từ 6 chiều xuống 2 chiều để đoán bạn thuộc nhóm nào, và nén ảnh bằng PCA.
Chuẩn bị
- Mở notebook của bài (dùng chung với bài trước): Notebook Colab — Ma trận, trị riêng & PCA.
- Chọn File › Save a copy in Drive, rồi bấm Connect ở góc phải trên.
- Hoặc tạo notebook mới và dán lần lượt từng ô code. Colab có sẵn NumPy, Pandas, scikit-learn; Gradio được cài ở ô Web App (10–30 giây).
💡 Notebook có sẵn ô đáp án thu gọn — hãy tự điền các chỗ
____trước rồi mới mở đáp án.
PCA tính tay: chọn "góc chụp" giữ nhiều thông tin nhất
Chụp ảnh cả nhóm: đứng ở đầu hàng thì mọi người che nhau, đứng chính diện thì thấy đủ. Ảnh nào cũng ép 3D xuống 2D, nhưng chọn góc tốt thì giữ được nhiều thông tin hơn. PCA chọn "góc chụp" giữ nhiều thông tin nhất: hướng mà dữ liệu trải rộng nhất.
Ví dụ: 5 bạn ghi [giờ chơi game, giờ xem stream game] mỗi tuần: [9, 9], [3, 3], [7, 5], [5, 7], [6, 6]. Hai cột gần như đi cùng nhau, nên có thể gộp thành một trục "mức mê game" mà hầu như không mất gì. PCA làm đúng 4 bước:
| Bước | Việc làm | Kết quả tính tay |
|---|---|---|
| 1. Trừ trung bình | x̄ = [6, 6]; Xc = X - X.mean(axis=0) |
[3, 3], [−3, −3], [1, −1], [−1, 1], [0, 0] |
| 2. Ma trận C | C = Xc.T @ Xc / (n - 1) |
[[5, 4], [4, 5]] |
| 3. Vector riêng của C | xếp λ từ lớn đến nhỏ: argsort(lam)[::-1] |
λ₁ = 9, 𝐰₁ = [0.707, 0.707]; λ₂ = 1 |
| 4. Chiếu | z = Xc @ w |
4.24, −4.24, 0, 0, 0 |
- x̄ (đọc: "x ngang") — trung bình từng cột; Xc = X − x̄ dời dữ liệu về quanh gốc 0.
- C = XcᵀXc / (n − 1) (đọc: "C bằng X c chuyển vị nhân X c, chia n trừ 1"). Đường chéo (5, 5) cho biết mỗi cột trải rộng bao nhiêu; số 4 dương ngoài đường chéo nghĩa là hai cột cùng tăng cùng giảm.
- λ₁, 𝐰₁ ("lam-đa một", "vector w một") — trị riêng lớn nhất của C và vector riêng của nó. λ là độ trải của dữ liệu theo hướng đó: λ càng lớn, trục càng giữ nhiều thông tin. Tỉ lệ giữ lại = λ₁ / (λ₁ + λ₂) = 9 / 10 = 90%.
Bước 4 "chiếu" chính là tích vô hướng ở Bài 6 trong series: mỗi bạn còn đúng một con số.
# [A5]: PCA tính tay — 5 bạn, mỗi bạn 2 con số: [giờ chơi game, giờ xem stream game] mỗi tuần
import numpy as np
import matplotlib.pyplot as plt

X = np.array([[9, 9], [3, 3], [7, 5], [5, 7], [6, 6]])
n = len(X)

Xc = X - X.mean(axis=0)              # Bước 1: trừ trung bình từng cột → dữ liệu quanh gốc 0
C  = Xc.T @ Xc / (n - 1)             # Bước 2: ma trận C (2 × 2)
lam, V = np.linalg.eigh(C)           # Bước 3: trị riêng & vector riêng của C
thu_tu = np.argsort(lam)[::-1]       #         xếp λ từ LỚN đến nhỏ
lam, V = lam[thu_tu], V[:, thu_tu]
w = V[:, 0]                          # hướng trải rộng nhất
z = Xc @ w                           # Bước 4: chiếu mỗi bạn lên hướng đó → còn 1 con số

print("Trung bình:", X.mean(axis=0))
print("C =\n", C)
print("λ =", lam, " → giữ lại", round(lam[0] / lam.sum() * 100), "% thông tin với 1 trục")
print("Hướng w =", w.round(3))
print("Mỗi bạn còn 1 số z =", z.round(2))

# Vẽ: 5 bạn (đã trừ trung bình), trục 1 màu cam, vị trí sau khi chiếu là dấu x đỏ
plt.scatter(Xc[:, 0], Xc[:, 1], s=80)
plt.axline((0, 0), w, color="orange", label="trục 1 (λ = 9)")
plt.scatter(*(np.outer(z, w).T), marker="x", color="red", label="điểm sau khi chiếu")
plt.gca().set_aspect("equal"); plt.legend(); plt.show()Kết quả:
Trung bình: [6. 6.]
C =
 [[5. 4.]
 [4. 5.]]
λ = [9. 1.]  → giữ lại 90 % thông tin với 1 trục
Hướng w = [0.707 0.707]
Mỗi bạn còn 1 số z = [ 4.24 -4.24  0.    0.    0.  ]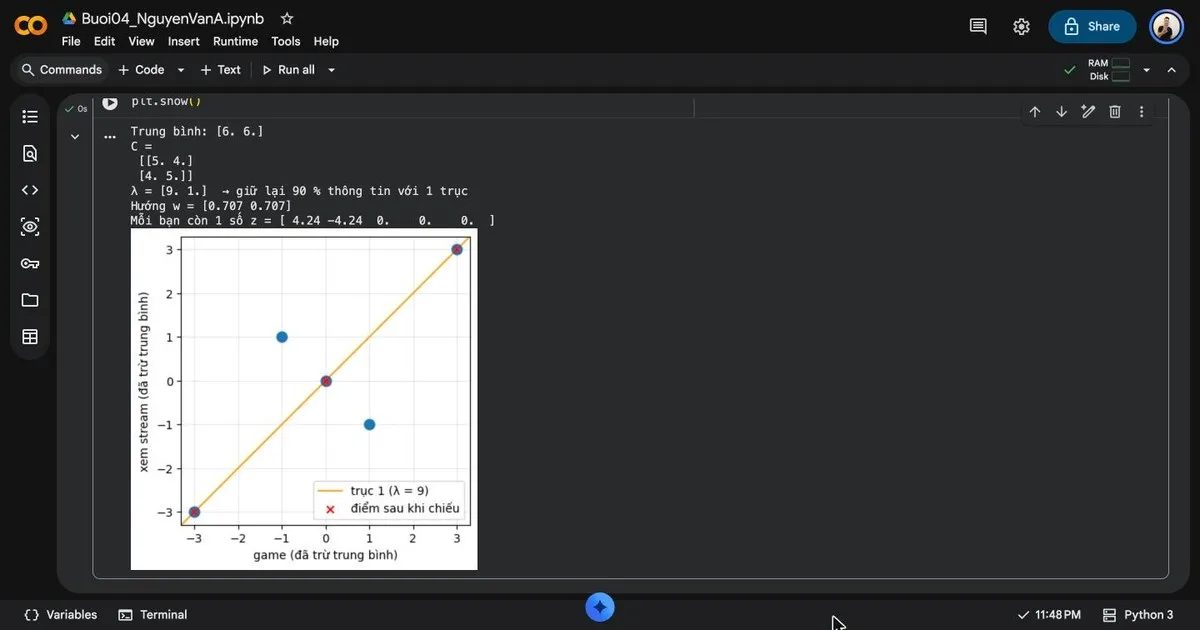
Tự kiểm tra: Chi [7, 5] và Dũng [5, 7] đều có z = 0. Vậy chỗ khác nhau của hai bạn nằm ở đâu?
Ở trục 2 — phần 10% thông tin bị bỏ đi. Theo trục "mức mê game", hai bạn bằng nhau; chỉ khi giữ thêm trục 2 mới thấy một bạn thiên về chơi, một bạn thiên về xem.
Tự viết PCA bằng NumPy: từ 3 chiều xuống 2 chiều
8 bạn (An, Bình, Chi, Dũng, Giang, Hà, Khoa, Linh), mỗi bạn 3 con số [giờ học, giờ chơi game, giờ lướt mạng xã hội] mỗi tuần — dữ liệu nằm sẵn trong khung code. Làm đúng 4 bước như trên để đưa về 2 con số mỗi bạn, vẽ bản đồ 2D, rồi so tỉ lệ thông tin giữ lại với thư viện scikit-learn.
Gợi ý: axis=0 là tính dọc theo từng cột; C có kích thước (3 × 8) @ (8 × 3) → 3 × 3; chiếu Z = Xc W (đọc: "Z bằng X c nhân W"), kích thước (8 × 3) @ (3 × 2) → (8 × 2).
# BÀI TẬP 2 — KHUNG CODE: điền vào chỗ ____
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

ten = ["An", "Bình", "Chi", "Dũng", "Giang", "Hà", "Khoa", "Linh"]
X = np.array([[25,  2,  5],
              [22,  4,  9],
              [ 6, 20, 14],
              [ 4, 24, 10],
              [12,  8, 20],
              [10,  6, 24],
              [20,  5,  4],
              [ 7, 22, 12]])     # [học, game, mạng xã hội]
n = len(X)

Xc = X - X.mean(axis=____)                 # 1. trừ trung bình TỪNG CỘT
C  = Xc.T @ ____ / (n - 1)                 # 2. ma trận C (3 × 3)
lam, V = np.linalg.eigh(C)                 # 3. trị riêng & vector riêng
thu_tu = np.argsort(lam)[::-1]             #    xếp λ từ lớn đến nhỏ
lam, V = lam[thu_tu], V[:, thu_tu]
W = V[:, :____]                            #    giữ 2 vector riêng đầu → W có kích thước 3 × 2
Z = ____ @ W                               # 4. chiếu: (8 × 3) @ (3 × 2) → (8 × 2)

print("λ =", lam.round(2))
print("Tỉ lệ thông tin giữ lại với 2 trục:", round(lam[:2].sum() / lam.sum(), 3))
print("Z (2 con số của mỗi bạn):\n", Z.round(2))

# So với thư viện: tỉ lệ phải giống hệt (dấu +/− của trục có thể bị ngược, không sao)
pca = PCA(n_components=2).fit(X)
print("sklearn:", pca.explained_variance_ratio_.sum().round(3))

# Vẽ bản đồ 8 bạn
plt.scatter(Z[:, 0], Z[:, 1])
for t, (a, b) in zip(ten, Z):
    plt.annotate(t, (a, b))
plt.show()
Xem đáp án
Xc = X - X.mean(axis=0)
C  = Xc.T @ Xc / (n - 1)
...
W = V[:, :2]
Z = Xc @ W
Kết quả:
λ = [142.63  50.17   1.04]
Tỉ lệ thông tin giữ lại với 2 trục: 0.995
Z (2 con số của mỗi bạn):
 [[-16.22  -3.89]
 [-11.82  -0.82]
 [ 11.33  -1.27]
 [ 14.48  -6.31]
 [  0.38   8.53]
 [  1.3   13.24]
 [-11.04  -5.4 ]
 [ 11.58  -4.07]]
sklearn: 0.995PCA tự viết cho tỉ lệ 0.995 — trùng thư viện. Trên bản đồ, An, Bình, Khoa (học nhiều) tụm bên trái; Chi, Dũng, Linh (chơi game nhiều) tụm bên phải; Giang, Hà (lướt mạng nhiều) nằm phía trên.
💡 Dấu của trục: vector riêng [0.7, 0.7] và [−0.7, −0.7] chỉ cùng một đường thẳng, nên PCA tự viết và thư viện có thể cho trục ngược dấu. Khi đó bản đồ chỉ bị lật gương — vị trí tương đối giữa các bạn không đổi, tỉ lệ giữ lại vẫn giống hệt.
Câu hỏi suy nghĩ: vì sao trị riêng thứ ba (1.04) gần như bằng 0? Trục 1 nói về điều gì?
Cộng 3 con số của từng bạn: tổng giờ của mọi người khá gần nhau (29–41 giờ), nên dữ liệu gần như nằm trên một mặt phẳng — chiều thứ ba hầu như không còn thông tin. Cột đầu của W có hai số lớn nhất ở học và game, trái dấu nhau: trục 1 là "học nhiều ↔ chơi game nhiều".
Mini-App: bản đồ 60 sinh viên từ 6 chiều xuống 2 chiều
Dữ liệu có 60 sinh viên, mỗi bạn 6 con số: giờ học, chơi game, mạng xã hội, làm thêm, thể thao, câu lạc bộ (CLB) mỗi tuần. Cột nhom chỉ để tô màu kiểm tra — PCA không nhìn vào nó. Ô %%writefile ghi file CSV lên máy Colab; đây là vài dòng đầu (ô đầy đủ 60 dòng có sẵn trong notebook):
%%writefile sinh_vien.csv
ma,hoc,game,mang_xa_hoi,lam_them,the_thao,clb,nhom
SV01,0,26,7,7,1,5,Game thủ
SV02,17,2,9,22,1,0,Đi làm thêm
SV03,26,0,6,7,0,2,Mọt sách
SV04,15,4,14,5,13,12,Năng nổ
...
Bước 1 — PCA 6 chiều → 2 chiều bằng thư viện
Thư viện làm cả 4 bước PCA trong hai dòng: PCA(n_components=2).fit(X) tìm 2 hướng trải rộng nhất, pca.transform(X) chiếu 60 bạn lên 2 hướng đó. Hai dòng if chỉ quy ước dấu của trục để bản đồ của ai chạy cũng giống nhau.
# BÀI TẬP 3 — Bước 1: đọc dữ liệu & PCA 6 chiều → 2 chiều
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

df = pd.read_csv("sinh_vien.csv")
COT = ["hoc", "game", "mang_xa_hoi", "lam_them", "the_thao", "clb"]
X = df[COT].values                      # ma trận 60 × 6
print("X.shape:", X.shape)

pca = PCA(n_components=2).fit(X)        # tìm 2 hướng trải rộng nhất
# PCA có thể trả trục bị ngược dấu (+/−). Quy ước: trục 1 dương về phía "game", trục 2 dương về phía "làm thêm"
if pca.components_[0, 1] < 0: pca.components_[0] *= -1
if pca.components_[1, 3] < 0: pca.components_[1] *= -1
Z = pca.transform(X)                    # mỗi bạn còn 2 con số → (60, 2)
print("Z.shape:", Z.shape)
print("Tỉ lệ giữ lại:", pca.explained_variance_ratio_.round(3), "→ tổng", pca.explained_variance_ratio_.sum().round(3))

# Mỗi trục là một vector 6 số: số càng lớn (âm hoặc dương) thì cột đó càng quyết định trục
display(pd.DataFrame(pca.components_.round(2), columns=COT, index=["Trục 1", "Trục 2"]))
Kết quả:
X.shape: (60, 6)
Z.shape: (60, 2)
Tỉ lệ giữ lại: [0.481 0.331] → tổng 0.812
         hoc  game  mang_xa_hoi  lam_them  the_thao   clb
Trục 1 -0.65  0.72         0.22     -0.06     -0.06 -0.00
Trục 2 -0.09 0.01 -0.16 0.84 -0.37 -0.36Hai trục giữ 48.1% + 33.1% = 81.2% thông tin. Đọc trục: trục 1 ≈ 0.72 × game − 0.65 × học → sang phải là chơi game nhiều, sang trái là học nhiều. Trục 2 ≈ 0.84 × làm thêm − 0.37 × thể thao − 0.36 × CLB → lên trên là làm thêm, xuống dưới là thể thao và CLB.
Bước 2 — Vẽ bản đồ
# BÀI TẬP 3 — Bước 2: vẽ bản đồ sinh viên 2D, tô màu theo nhóm
MAU = {"Mọt sách": "tab:blue", "Game thủ": "tab:red", "Đi làm thêm": "tab:green", "Năng nổ": "tab:orange"}

def ve_ban_do(diem_moi=None):
    fig, ax = plt.subplots(figsize=(6.5, 5))
    for nhom, mau in MAU.items():
        m = (df["nhom"] == nhom).values
        ax.scatter(Z[m, 0], Z[m, 1], c=mau, s=45, alpha=0.75, label=nhom)
    if diem_moi is not None:
        ax.scatter(*diem_moi, marker="*", s=500, c="black", label="Bạn")
    ax.axhline(0, color="gray", lw=0.5); ax.axvline(0, color="gray", lw=0.5)
    ax.set_xlabel("Trục 1:  ← học nhiều  ·  chơi game nhiều →")
    ax.set_ylabel("Trục 2:  ← thể thao, CLB  ·  làm thêm →")
    ax.set_title("Bản đồ 60 sinh viên (6 chiều → 2 chiều bằng PCA)")
    ax.legend(loc="best")
    return fig

ve_ban_do()
plt.show()
Bốn nhóm tự tách ra bốn góc: Mọt sách bên trái, Game thủ bên phải, Đi làm thêm phía trên, Năng nổ phía dưới — dù PCA không hề biết nhóm của ai.
Bước 3 — Đoán nhóm của bạn
Chiếu 6 con số của bạn lên cùng 2 trục để có vị trí trên bản đồ, rồi làm KNN như Bài 4 trong series: lấy 5 bạn gần nhất, nhóm nào xuất hiện nhiều nhất thì đoán bạn thuộc nhóm đó.
𝐳 = PCA(𝐱), d = ‖Z − 𝐳‖, lấy 5 bạn có d nhỏ nhất (đọc: "z là vị trí của x trên bản đồ"; "d là khoảng cách từ mỗi bạn tới z").
# BÀI TẬP 3 — Bước 3: KHUNG CODE đoán nhóm của bạn, điền vào chỗ ____
def doan_nhom(thoi_quen, k=5):
    z = pca.transform([____])[0]                    # 6 con số → 2 con số (cùng phép chiếu với 60 bạn)
    d = np.linalg.norm(____ - z, axis=1)            # khoảng cách tới từng bạn trên bản đồ
    idx = np.argsort(d)[:____]                      # k bạn gần nhất
    nhom = df["nhom"].iloc[idx].value_counts().index[0]   # nhóm xuất hiện nhiều nhất
    return z, nhom

toi = [20, 6, 10, 3, 8, 6]       # [học, game, mạng xã hội, làm thêm, thể thao, CLB] — sửa thành của bạn!
z, nhom = doan_nhom(toi)
print("Vị trí của bạn trên bản đồ:", z.round(2), " →  nhóm:", nhom)
ve_ban_do(z)
plt.show()
Xem đáp án
    z = pca.transform([thoi_quen])[0]     # ngoặc vuông: PCA cần một BẢNG, dù chỉ 1 hàng
    d = np.linalg.norm(Z - z, axis=1)     # khoảng cách trên bản đồ Z (không phải X)
    idx = np.argsort(d)[:k]               # KHÔNG đảo ngược — cần khoảng cách nhỏ nhất
Kết quả:
Vị trí của bạn trên bản đồ: [-6.17 -6.45] → nhóm: Năng nổNgôi sao đen nằm giữa nhóm Mọt sách và nhóm Năng nổ, gần Năng nổ hơn. Hãy sửa toi thành thói quen thật của bạn!
Nén ảnh bằng PCA
Gửi ảnh qua Zalo, ảnh bị nén cho nhẹ: mờ đi chút nhưng vẫn nhận ra. PCA nén ảnh theo tinh thần đó. Ảnh xám là ma trận 427 × 640, mỗi ô là độ sáng 0–255. Coi mỗi hàng ảnh (640 số) là một mẫu dữ liệu; PCA tìm k hướng chung, mỗi hàng chỉ còn k con số, rồi inverse_transform dựng lại ảnh.
Số cần lưu = 427·k + k·640 + 640 (đọc: 427·k — mỗi hàng còn k số; k·640 — k trục, mỗi trục 640 số; 640 — hàng trung bình). Với k = 20, ta chỉ lưu 21 980 số thay vì 273 280 (8%) mà vẫn giữ 91.6% thông tin.
# BÀI TẬP 3 — Bước 4: KHUNG CODE nén ảnh bằng PCA, điền vào chỗ ____
from sklearn.datasets import load_sample_image
anh_mau = load_sample_image("china.jpg").mean(axis=2)      # ảnh màu → ảnh xám
print("Ảnh là ma trận:", anh_mau.shape, "=", anh_mau.size, "con số")

def nen_anh(anh, k):
    pca_anh = PCA(n_components=____).fit(anh)               # giữ k trục
    Z_anh = pca_anh.transform(anh)                          # (số hàng × k)
    anh_moi = pca_anh.inverse_transform(____)               # dựng lại ảnh từ k trục
    giu_lai = pca_anh.explained_variance_ratio_.sum()       # tỉ lệ thông tin giữ lại
    so_luu = Z_anh.size + pca_anh.components_.size + pca_anh.mean_.size   # số con số cần lưu
    return np.clip(anh_moi, 0, 255), giu_lai, so_luu / anh.size

fig, axs = plt.subplots(1, 4, figsize=(16, 3.6))
axs[0].imshow(anh_mau, cmap="gray"); axs[0].set_title("Ảnh gốc (100%)")
for ax, k in zip(axs[1:], [5, 20, 50]):
    anh_moi, giu, ti_le_luu = nen_anh(anh_mau, k)
    ax.imshow(anh_moi, cmap="gray")
    ax.set_title(f"k = {k}: giữ {giu:.1%} · lưu {ti_le_luu:.1%}")
for ax in axs: ax.axis("off")
plt.show()
Xem đáp án
    pca_anh = PCA(n_components=k).fit(anh)
    ...
    anh_moi = pca_anh.inverse_transform(Z_anh)
Kết quả:
Ảnh là ma trận: (427, 640) = 273280 con số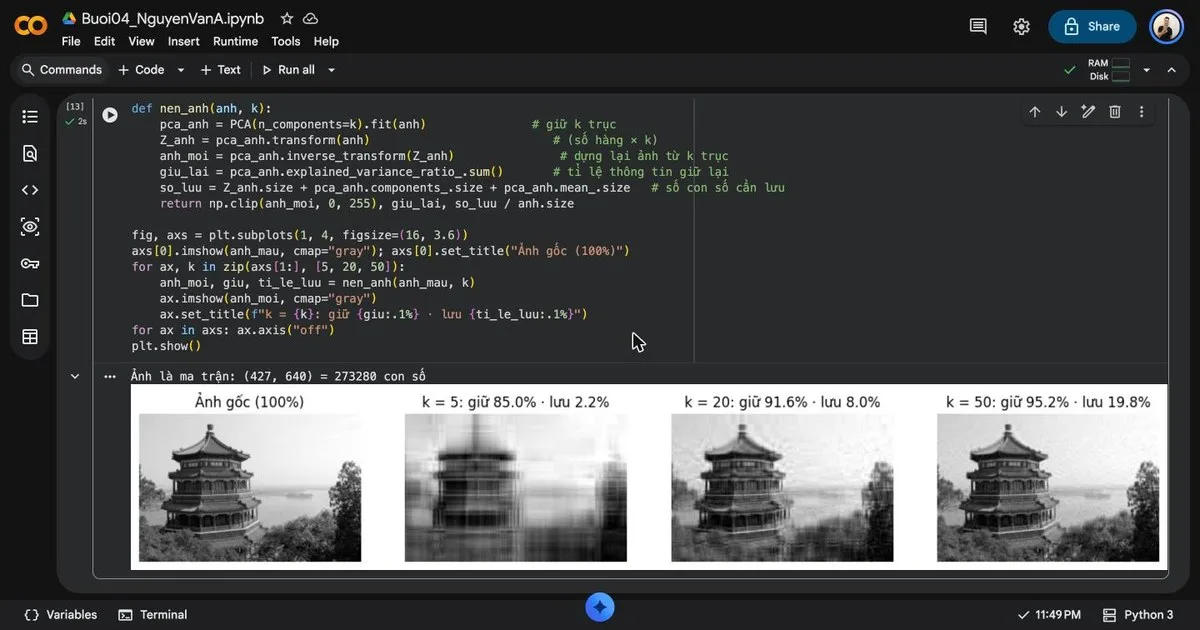
Đóng gói thành Web App bằng Gradio
Gộp hai chức năng vào một app hai tab bằng Gradio (thư viện làm giao diện web cho code Python). Mỗi tab là một gr.Interface: đầu vào là thanh trượt hoặc ảnh, đầu ra là biểu đồ hoặc ảnh kèm một dòng chữ.
# BÀI TẬP 3 — Bước 5: đóng gói thành Web App bằng Gradio
!pip install -q gradio
import gradio as gr
plt.imsave("anh_mau.png", anh_mau, cmap="gray")

def app_ban_do(hoc, game, mxh, lam_them, the_thao, clb):
    z, nhom = doan_nhom([hoc, game, mxh, lam_them, the_thao, clb])
    fig = ve_ban_do(z)
    plt.close(fig)
    return fig, f"Bạn thuộc nhóm: {nhom}   (toạ độ trên bản đồ: {z[0]:.1f}, {z[1]:.1f})"

def app_nen_anh(anh, k):
    if anh.ndim == 3:
        anh = anh[:, :, :3].mean(axis=2)                     # ảnh màu → ảnh xám
    anh_moi, giu, ti_le_luu = nen_anh(anh.astype(float), int(k))
    return anh_moi.astype(np.uint8), f"Giữ lại {giu:.1%} thông tin · chỉ cần lưu {ti_le_luu:.1%} số so với ảnh gốc"

o = lambda nhan, gt: gr.Slider(0, 40, value=gt, step=1, label=nhan)
tab1 = gr.Interface(
    fn=app_ban_do,
    inputs=[o("Học (giờ/tuần)", 20), o("Chơi game", 6), o("Mạng xã hội", 10),
            o("Làm thêm", 3), o("Thể thao", 8), o("Câu lạc bộ", 6)],
    outputs=[gr.Plot(label="Bản đồ sinh viên 2D"), gr.Textbox(label="Kết quả")],
    flagging_mode="never",
)
tab2 = gr.Interface(
    fn=app_nen_anh,
    inputs=[gr.Image(value="anh_mau.png", type="numpy", label="Ảnh (tải ảnh của bạn lên cũng được)"),
            gr.Slider(1, 100, value=20, step=1, label="k — số trục giữ lại")],
    outputs=[gr.Image(label="Ảnh sau khi nén"), gr.Textbox(label="Thống kê")],
    flagging_mode="never",
)
demo = gr.TabbedInterface([tab1, tab2], ["🗺️ Bản đồ sinh viên 2D", "🖼️ Nén ảnh bằng PCA"],
                          title="🧭 PCA thực chiến — Toán AI 2026")
demo.launch(share=True)
App hiện ngay dưới ô code, kèm link công khai …gradio.live (tồn tại tối đa 1 tuần) để gửi bạn bè. Tab bản đồ trông như ảnh đầu bài; tab nén ảnh cho bạn tải ảnh của mình lên và chọn k.
Tự kiểm tra. Notebook có sẵn một ô chạy 8 phép thử không cần giao diện. Bốn thói quen [30, 2, 5, 3, 2, 2], [6, 25, 14, 4, 2, 2], [10, 5, 6, 25, 1, 0], [12, 5, 10, 2, 14, 12] phải được đoán lần lượt là Mọt sách, Game thủ, Đi làm thêm, Năng nổ; tỉ lệ giữ lại của bản đồ là 0.812; ảnh k = 5 giữ 0.850, k = 20 giữ 0.916 và chỉ cần lưu 0.080 (lệch ở chữ số thứ tư tùy máy vẫn được).
Lỗi thường gặp
| Thông báo lỗi | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'pca' is not defined |
Chưa chạy Bước 1, hoặc máy Colab vừa khởi động lại | Chạy lần lượt ô %%writefile → Bước 1 → Bước 2 → Bước 3 |
FileNotFoundError: sinh_vien.csv |
Chưa chạy ô %%writefile |
Chạy lại ô %%writefile |
ValueError: Expected 2D array, got 1D array |
Quên ngoặc vuông trong pca.transform([thoi_quen]) |
Thêm ngoặc vuông: PCA cần một bảng |
| Đoán nhóm sai ở bảng tự kiểm tra | d tính với X thay vì Z, hoặc dùng [::-1] |
Dùng np.linalg.norm(Z - z, axis=1) và np.argsort(d)[:k] |
Tự luyện thêm
- Thử thói quen [12, 14, 8, 14, 2, 1] (vừa chơi game vừa đi làm thêm). App đoán nhóm nào? Ngôi sao nằm ở đâu trên bản đồ? Vì sao kết quả kiểu này cần thận trọng?
- Thêm trục thứ 3: đổi thành
PCA(n_components=3). Trục 3 giữ thêm bao nhiêu % thông tin? Nó nói về cột nào? - Nén ảnh màu: ảnh màu là 3 ma trận (đỏ, xanh lá, xanh dương). Nén từng ma trận bằng
nen_anhrồi ghép lại bằngnp.stack. - Tìm k nhỏ nhất để ảnh mẫu giữ được ít nhất 95% thông tin.
Tóm tắt
PCA = 4 bước: trừ trung bình → ma trận C → vector riêng của C xếp theo trị riêng giảm dần → chiếu lên k vector đầu. Trị riêng cho biết mỗi trục giữ bao nhiêu thông tin. Cùng công thức đó vừa vẽ bản đồ 6 chiều, vừa nén ảnh.
| Ký hiệu Toán | Cách đọc | Lệnh NumPy |
|---|---|---|
| x̄ | "x ngang" | X.mean(axis=0) |
| Xc = X − x̄ | "X c bằng X trừ x ngang" | Xc = X - X.mean(axis=0) |
| C = XcᵀXc / (n − 1) | "X c chuyển vị nhân X c, chia n trừ 1" | Xc.T @ Xc / (n - 1) |
| λ₁, 𝐰₁ | "lam-đa một", "vector w một" | lam[0], V[:, 0] (sau khi xếp bằng np.argsort(lam)[::-1]) |
| Z = Xc W | "Z bằng X c nhân W" | Xc @ V[:, :k] |
| (λ₁ + … + λₖ) / ∑ λ | "tổng k lam-đa đầu chia tổng các lam-đa" | pca.explained_variance_ratio_.sum() |
| 6 chiều → 2 chiều | — | PCA(n_components=2).fit(X).transform(X) |
| d = ‖Z − 𝐳‖ | "d bằng chuẩn của Z trừ z" | np.linalg.norm(Z - z, axis=1) |
Bài tiếp theo trong series: Đạo hàm, đạo hàm riêng & chain rule — đo xem đầu ra thay đổi bao nhiêu khi ta nhích đầu vào một chút, bước đầu tiên để hiểu vì sao mạng nơ-ron "tự học" được.
