Biến chữ thành vector bằng đếm từ (bag of words) và vì sao nó tìm sai
Trong bài này
Series · Bài 7/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
Ở bài trước, bạn đã so sánh "gu" đồ uống bằng độ tương tự cosine. Nhưng dữ liệu đời thực phần lớn là chữ: tên sản phẩm, bình luận Shopee, mô tả đồ án, CV xin việc. Máy tính chỉ làm việc được với số, vậy làm sao để nó biết "website bán quần áo" giống đồ án nào nhất?
Trong bài này, bạn sẽ biến câu chữ thành vector bằng cách đơn giản nhất là đếm từ, tự xây một "máy tìm đồ án" bằng NumPy, rồi cố tình làm nó tìm sai để hiểu vì sao các hệ thống AI hiện đại không dừng lại ở cách này.
Chuẩn bị
- Mở notebook Colab của bài này.
- Chọn File › Save a copy in Drive, rồi bấm Connect ở góc phải trên.
- Chạy lần lượt các ô A1–A4 trước (bài trước trong series) để có sẵn
numpyvà hàmcosine. Nếu bạn tạo notebook mới, chỉ cần dán đoạn dưới đây vào ô đầu tiên:
import numpy as np

def cosine(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
Nhắc nhanh: cos θ = (𝐚 · 𝐛) / (‖𝐚‖ · ‖𝐛‖) (đọc: "cô-sin tê-ta bằng a nhân vô hướng b, chia cho chuẩn a nhân chuẩn b"). Gần 1 là cùng hướng (giống nhau), bằng 0 là vuông góc (không liên quan).
💡 Notebook có sẵn ô Đáp án đã thu gọn. Hãy tự điền khung code trước rồi mới bấm Show code để đối chiếu.
Túi từ: biến câu thành vector bằng cách đếm
Cách đơn giản nhất để biến một câu thành số:
- Lập một danh sách từ, gọi là từ vựng (vocabulary).
- Với mỗi câu, đếm xem mỗi từ trong từ vựng xuất hiện mấy lần.
Mỗi câu khi đó trở thành một vector có độ dài bằng số từ trong từ vựng. Cách này có tên bag of words ("túi từ"): giống như bạn đổ hết chữ trong câu vào một cái túi rồi đếm, không quan tâm chữ nào đứng trước chữ nào.
Ký hiệu: vᵢ = số lần từ thứ i xuất hiện trong câu (đọc: "v i").
Ví dụ với 3 câu và từ vựng 8 từ:
| Câu | bán | quần | áo | giày | tư | vấn | tuyển | sinh |
|---|---|---|---|---|---|---|---|---|
| bán quần áo | 1 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
| bán giày | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| tư vấn tuyển sinh | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 1 |
| Câu hỏi "quần áo nữ" | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 0 |
Tính tay cosine giữa câu hỏi [0, 1, 1, 0, 0, 0, 0, 0] và "bán quần áo" [1, 1, 1, 0, 0, 0, 0, 0]:
- Tích vô hướng: 0×1 + 1×1 + 1×1 = 2.
- Độ dài câu hỏi: √(1² + 1²) = √2. Độ dài "bán quần áo": √(1² + 1² + 1²) = √3.
- cos = 2 / (√2 × √3) = 2 / 2.449 ≈ 0.816.
Hai câu còn lại không trùng từ nào với câu hỏi nên tích vô hướng bằng 0, cos = 0. Còn chữ "nữ" thì sao? Nó không có trong từ vựng, nên bị bỏ qua hoàn toàn. Ghi nhớ chi tiết này, nó sẽ quay lại "cắn" chúng ta ở phần sau.
Code: ma trận đếm từ bằng NumPy
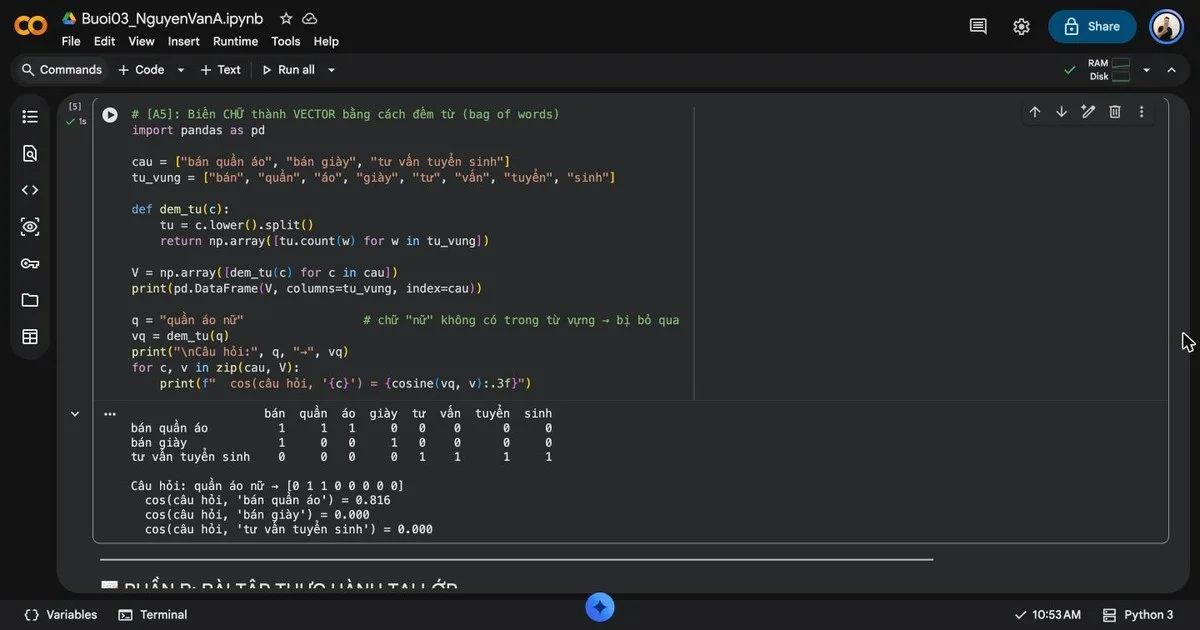
Hàm dem_tu viết thường câu, tách theo khoảng trắng, rồi đếm từng từ trong từ vựng. Xếp các vector của từng câu chồng lên nhau ta được một ma trận V: mỗi hàng là một câu, mỗi cột là một từ.
# [A5]: Biến CHỮ thành VECTOR bằng cách đếm từ (bag of words)
import pandas as pd

cau = ["bán quần áo", "bán giày", "tư vấn tuyển sinh"]
tu_vung = ["bán", "quần", "áo", "giày", "tư", "vấn", "tuyển", "sinh"]

def dem_tu(c):
    tu = c.lower().split()
    return np.array([tu.count(w) for w in tu_vung])

V = np.array([dem_tu(c) for c in cau])
print(pd.DataFrame(V, columns=tu_vung, index=cau))

q = "quần áo nữ"                 # chữ "nữ" không có trong từ vựng → bị bỏ qua
vq = dem_tu(q)
print("\nCâu hỏi:", q, "→", vq)
for c, v in zip(cau, V):
    print(f"  cos(câu hỏi, '{c}') = {cosine(vq, v):.3f}")
Kết quả:
                   bán  quần  áo  giày  tư  vấn  tuyển  sinh
bán quần áo          1     1   1     0   0    0      0     0
bán giày             1     0   0     1   0    0      0     0
tư vấn tuyển sinh    0     0   0     0   1    1      1     1

Câu hỏi: quần áo nữ → [0 1 1 0 0 0 0 0]
  cos(câu hỏi, 'bán quần áo') = 0.816
  cos(câu hỏi, 'bán giày') = 0.000
cos(câu hỏi, 'tư vấn tuyển sinh') = 0.000Kết quả khớp đúng với bảng tính tay. Một dòng [tu.count(w) for w in tu_vung] là đủ để biến chữ thành số.
💡 Tự kiểm tra: tìm "quần jean" thì cos với "bán quần áo" bằng bao nhiêu? Chỉ trùng chữ "quần", còn "jean" bị bỏ qua: 1 / (1 × √3) ≈ 0.577.
Xây máy tìm đồ án bằng đếm từ
Giờ làm thật. Bạn có 8 tên đồ án của sinh viên khóa trước. Nhiệm vụ: gõ một câu mô tả ý tưởng, máy trả về các đồ án giống nhất, xếp theo cosine từ lớn đến nhỏ. Các bước:
- Tạo từ vựng tự động: ghép 8 tên lại, viết thường, tách từ, bỏ trùng bằng
set, sắp xếp bằngsorted. - Hoàn thiện
dem_tu: đếm từng từ trongtu_vung. - Hoàn thiện
tim_kiem_dem_tu: biến câu hỏi thành vector, tính cosine với từng vector trongV. - Xếp hạng:
np.argsort(diem)trả về vị trí sắp từ nhỏ đến lớn; thêm[::-1]để đảo ngược, lấy cosine lớn nhất trước;[:k]lấy k kết quả đầu.
Hàm cosine lần này có thêm một dòng kiểm tra: nếu câu hỏi không chứa từ nào trong từ vựng, vector của nó toàn số 0, độ dài bằng 0, và phép chia sẽ hỏng. Khi đó ta trả về 0.
Thử với hai câu hỏi: "website bán quần áo" và "phần mềm ghi lại tiền tiêu vặt". Điền vào các chỗ ____:
# BÀI TẬP 2 — KHUNG CODE: điền vào chỗ ____
import numpy as np

do_an = [
    "Ứng dụng đặt đồ ăn trong căng tin",
    "Website bán quần áo thời trang",
    "Chatbot tư vấn tuyển sinh",
    "Phân tích cảm xúc bình luận Shopee",
    "App theo dõi chi tiêu cá nhân",
    "Ứng dụng tìm phòng trọ gần trường",
    "Sàn thương mại điện tử đồ công nghệ",
    "Phần mềm quản lý quán cà phê",
]

# 1. Từ vựng = tất cả các từ (viết thường) xuất hiện trong 8 tên
tu_vung = sorted(set(" ".join(do_an).lower().split()))
print("Số từ trong từ vựng:", len(tu_vung))

def dem_tu(c):
    tu = c.lower().split()
    return np.array([tu.count(w) for w in ____])

def cosine(a, b):
    if np.linalg.norm(a) == 0 or np.linalg.norm(b) == 0:   # vector toàn số 0 → không so được
        return 0.0
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

V = np.array([dem_tu(t) for t in do_an])      # 8 vector, mỗi vector dài len(tu_vung)

def tim_kiem_dem_tu(cau_hoi, k=3):
    vq = dem_tu(____)
    diem = np.array([cosine(vq, v) for v in ____])
    idx = np.argsort(diem)[::-1][:k]              # [::-1] đảo ngược → từ LỚN đến nhỏ
    print(f"🔎 '{cau_hoi}'")
    for i in idx:
        if diem[i] > 0:
            print(f"   {diem[i]:.3f}  {do_an[i]}")
    if diem[idx[0]] == 0:
        print("   (không có tên nào trùng chữ với câu hỏi)")

tim_kiem_dem_tu("website bán quần áo")
tim_kiem_dem_tu("phần mềm ghi lại tiền tiêu vặt")
Xem đáp án
def dem_tu(c):
    tu = c.lower().split()
    return np.array([tu.count(w) for w in tu_vung])

def tim_kiem_dem_tu(cau_hoi, k=3):
    vq = dem_tu(cau_hoi)
    diem = np.array([cosine(vq, v) for v in V])
    # ... phần còn lại giữ nguyên
Kết quả:
Số từ trong từ vựng: 52
🔎 'website bán quần áo'
   0.816  Website bán quần áo thời trang
🔎 'phần mềm ghi lại tiền tiêu vặt'
   0.436  Phần mềm quản lý quán cà phê
   0.218  App theo dõi chi tiêu cá nhân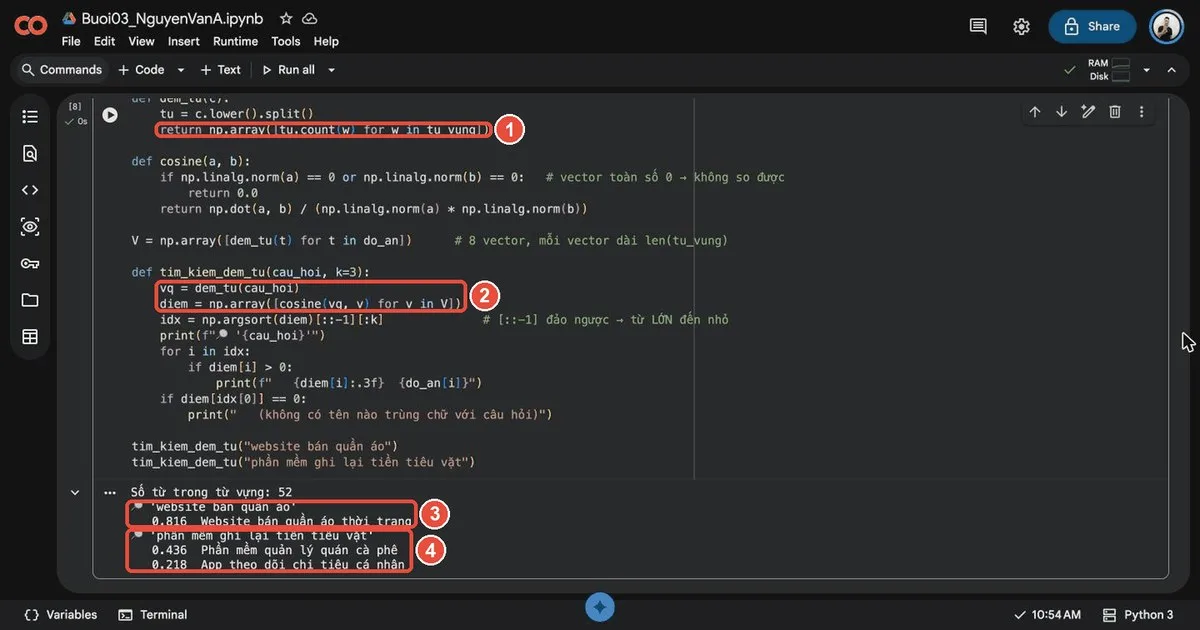
Câu thứ nhất: tuyệt vời, đúng ngay đồ án bán quần áo. Câu thứ hai: máy gợi ý phần mềm quản lý quán cà phê, trong khi đồ án đúng nhất rõ ràng là "App theo dõi chi tiêu cá nhân", chỉ được xếp thứ hai với 0.218. Có gì đó không ổn.
Mổ xẻ: vì sao máy tìm sai?
Hãy tính tay để thấy máy "nghĩ" gì. Câu hỏi "phần mềm ghi lại tiền tiêu vặt" có 7 chữ, nhưng chỉ 3 chữ có trong từ vựng: phần, mềm, tiêu. Bốn chữ "ghi", "lại", "tiền", "vặt" bị bỏ qua như chữ "nữ" lúc nãy. Vậy vector câu hỏi có ba số 1, độ dài √3.
| Tên đồ án (7 chữ, độ dài √7) | Chữ trùng | Tính tay cosine |
|---|---|---|
| Phần mềm quản lý quán cà phê | phần, mềm | 2 / (√3 × √7) = 2 / 4.583 ≈ 0.436 |
| App theo dõi chi tiêu cá nhân | tiêu | 1 / (√3 × √7) = 1 / 4.583 ≈ 0.218 |
Máy không hề "hiểu" câu hỏi. Nó chỉ đếm số chữ trùng. "Phần mềm" trùng 2 chữ nên thắng, dù quán cà phê chẳng liên quan gì đến tiền tiêu vặt. Còn "tiền tiêu vặt" và "chi tiêu" là cùng một ý, nhưng khác chữ nên gần như bị coi là không liên quan.
Thử thêm câu "đặt lịch đi bác sĩ". Bạn đoán máy trả về gì?
Xem đáp án
Chỉ có chữ "đặt" nằm trong từ vựng (nhờ tên "Ứng dụng đặt đồ ăn trong căng tin"). Máy trả về đồ án đặt đồ ăn với cos = 1 / (1 × √8) ≈ 0.354. Đặt lịch khám bệnh và đặt đồ ăn trùng chữ "đặt" nhưng là hai chuyện khác nhau. Trong 8 tên này cũng không có đồ án nào về khám bệnh, nên câu trả lời đúng lẽ ra phải là "không tìm thấy".
Tóm lại, đếm từ có bốn điểm yếu chí mạng:
- Chỉ thấy chữ, không thấy nghĩa. "Tiền tiêu vặt" và "chi tiêu", "canteen" và "căng tin", "nhà thuê" và "phòng trọ" đều bị coi là khác nhau.
- Trùng chữ nhưng khác nghĩa vẫn được điểm. "Đặt lịch" và "đặt đồ ăn", "phần mềm ghi tiền" và "phần mềm quản lý quán".
- Từ ngoài từ vựng bị bỏ qua. Người dùng gõ chữ gì mới là máy "điếc".
- Mất thứ tự và cắt vụn từ ghép. Tách theo khoảng trắng nên "phần mềm" thành "phần" + "mềm", "cà phê" thành "cà" + "phê". Và vì đổ hết vào "túi", "chó cắn người" với "người cắn chó" có cùng một vector.
Cosine không có lỗi gì ở đây. Lỗi nằm ở cách ta biến chữ thành vector. Nếu có cách biến câu thành vector sao cho hai câu cùng nghĩa thì vector cùng hướng, dù khác chữ, thì vẫn công thức cosine đó sẽ tìm đúng. Đó chính là việc của embedding (nhúng) ở bài sau.
Lỗi thường gặp
| Thông báo lỗi / hiện tượng | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'cosine' is not defined |
Chưa chạy ô định nghĩa hàm cosine |
Chạy lại ô có def cosine |
| Kết quả là đồ án KÉM giống nhất | Quên [::-1] nên lấy cosine nhỏ nhất |
Dùng np.argsort(diem)[::-1][:k] |
Tự luyện thêm
- In ra
tu_vungvà vectordem_tu("phần mềm ghi lại tiền tiêu vặt"). Đếm xem có đúng 3 số 1 như phần mổ xẻ ở trên không. - Thử câu "app quản lý chi tiêu". Lần này máy có tìm đúng không? Vì sao? Tính tay cosine trước khi chạy.
- Thêm 3 tên đồ án mới vào danh sách
do_an(ví dụ của lớp bạn), chạy lại và quan sát từ vựng tăng lên bao nhiêu từ. - Thêm ngưỡng: nếu cosine lớn nhất nhỏ hơn 0.4 thì in "Không tìm thấy đồ án phù hợp". Câu "đặt lịch đi bác sĩ" giờ cho kết quả gì?
Xem đáp án bài 2
"app quản lý chi tiêu" có 5 chữ, cả 5 đều nằm trong từ vựng, nên độ dài vector câu hỏi là √5. Nó trùng 3 chữ app, chi, tiêu với "App theo dõi chi tiêu cá nhân": cos = 3 / (√5 × √7) ≈ 0.507, đứng đầu. "Phần mềm quản lý quán cà phê" trùng 2 chữ quản, lý: 2 / (√5 × √7) ≈ 0.338. Lần này tìm đúng, vì câu hỏi tình cờ dùng đúng chữ trong tên đồ án.
Tóm tắt
- Máy tính chỉ làm việc với số; đếm từ (bag of words) là cách đơn giản nhất để biến một câu thành vector.
- Từ vựng tạo bằng
sorted(set(" ".join(...).lower().split())); mỗi câu thành một vector đếm, cả tập câu thành ma trậnV. - Tìm kiếm = cosine giữa vector câu hỏi và từng vector tài liệu, rồi
np.argsort(diem)[::-1][:k]lấy k kết quả lớn nhất. - Cosine luôn cần bảo vệ trường hợp vector toàn số 0.
- Đếm từ chỉ thấy chữ, không thấy nghĩa: khác chữ cùng nghĩa thì bỏ sót, trùng chữ khác nghĩa thì gợi ý sai.
| Ký hiệu Toán | Cách đọc | Lệnh NumPy |
|---|---|---|
| vᵢ = số lần từ i xuất hiện | "v i" | [tu.count(w) for w in tu_vung] |
| 𝐕 (mỗi hàng là một câu) | "ma trận V" | np.array([dem_tu(t) for t in do_an]) |
| cos θ = 𝐚·𝐛 / (‖𝐚‖‖𝐛‖) | "cô-sin tê-ta bằng a nhân vô hướng b chia chuẩn a nhân chuẩn b" | np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)) |
| ‖𝐚‖ = 0 | "chuẩn của a bằng không" (vector toàn số 0) | np.linalg.norm(a) == 0 |
| Top-k lớn nhất | "tóp ca": k phần tử có cos lớn nhất | np.argsort(diem)[::-1][:k] |
Bài tiếp theo trong series: mình sẽ thay đếm từ bằng một mô hình embedding biến mỗi câu thành 384 con số theo nghĩa, sửa đúng câu hỏi vừa tìm sai, rồi xây Web App tìm đồ án theo nghĩa, so khớp CV với JD thực tập và tạo prompt RAG cho ChatGPT.
