Khoảng cách Euclid, chuẩn hóa Min-Max và KNN tính tay: gợi ý phòng trọ
Trong bài này
- Chuẩn bị
- Mỗi phòng trọ là một vector
- Khoảng cách Euclid (Ơ-clít): đường chim bay
- Khoảng cách Manhattan (Man-hát-tân): đi theo ô bàn cờ
- Code NumPy
- Đổi đơn vị, máy chọn sai: vì sao phải chuẩn hóa
- Một ví dụ "đau ví"
- Chuẩn hóa Min-Max: đưa mọi cột về cùng thang 0 đến 1
- KNN tính tay: "ngưu tầm ngưu"
- Ý tưởng
- Tính tay với 6 máy
- Code NumPy: không cần vòng for
- Thực hành: gợi ý phòng trọ, có và không chuẩn hóa
- Đề bài
- Khung code: điền vào chỗ ____
- Vì sao phòng H bị loại sau khi chuẩn hóa?
- Lỗi thường gặp
- Tự luyện thêm
- Tóm tắt
Series · Bài 4/12 Toán AI thực chiến: học Toán cho AI bằng code Python
- Ký hiệu Toán → NumPy & công thức 1 nơ-ron
- Ảnh là ma trận & Web App chấm điểm CV
- Hàm số & Sigmoid
- Khoảng cách, chuẩn hóa & KNN
- Mini-App định giá laptop cũ
- Vector, tích vô hướng & cosine
- Chữ thành vector bằng đếm từ
- Embedding, tìm kiếm ngữ nghĩa & RAG
- Nhân ma trận, vector riêng & trị riêng
- PCA: bản đồ sinh viên 2D & nén ảnh
- Đạo hàm, đạo hàm riêng & chain rule
- Lan truyền ngược: nơ-ron tự sửa sai
Lướt nhóm cho thuê phòng, bạn thấy hàng chục phòng trọ. Phòng nào "giống" yêu cầu của mình nhất? Bạn nhìn là biết, nhưng máy tính thì không hiểu chữ "giống". Nó chỉ biết làm một việc: đo khoảng cách giữa hai dãy số.
Trong bài này, mình sẽ cùng bạn đo khoảng cách Euclid và Manhattan bằng NumPy, tận mắt thấy chuyện chỉ đổi đơn vị mà máy chọn sai phòng, sửa nó bằng chuẩn hóa Min-Max, rồi tự cài thuật toán KNN (ca-en-en) bằng tay và bằng code để gợi ý phòng trọ.
Chuẩn bị
Code của bài nằm trong notebook Colab (cô-láp): mở notebook trên Google Colab. Bài này dùng các ô A3, A4, A5 và Bài tập 2.
- Bấm link, đăng nhập Google, chọn File › Save a copy in Drive để có bản sao của riêng bạn.
- Bấm Connect ở góc phải trên, thấy dấu ✓ xanh là sẵn sàng.
- Chạy ô A1 trước (ô này có
import numpy as np), rồi mới chạy A3, A4, A5. Nếu bạn dùng notebook mới, chỉ cần thêmimport numpy as npvào đầu.
💡 Notebook có sẵn ô đáp án (tên bắt đầu bằng 🔑). Hãy tự gõ khung code và điền chỗ trống trước rồi mới mở ra đối chiếu.
Mỗi phòng trọ là một vector
Lấy hai phòng trọ: phòng A giá 3 triệu, cách trường 2 km; phòng B giá 3,5 triệu, cách trường 5 km. Viết mỗi phòng thành một dãy số [giá (triệu), km đến trường]:
𝐚 = [3.0, 2.0], 𝐛 = [3.5, 5.0]
(đọc: "vector a", "vector b"; chữ in đậm để nhắc đây là vector (véc-tơ), không phải một số)
Ta gọi ai (đọc: "a i") là phần tử thứ i của 𝐚: a1 = 3.0 là giá, a2 = 2.0 là số km. Hai phòng "giống nhau" đến đâu? Ta đo khoảng cách giữa hai vector: càng nhỏ càng giống.
Khoảng cách Euclid (Ơ-clít): đường chim bay
d(𝐚, 𝐛) = √∑(ai − bi)²
(đọc: "d của a, b bằng căn của tổng bình phương a i trừ b i")
Đọc từ trong ra ngoài: trừ từng cặp phần tử, bình phương từng hiệu, cộng tất cả lại (∑ đọc là "xích-ma hoa", nghĩa là "tổng"), cuối cùng lấy căn √. Với 2 phần tử, đây chính là định lý Py-ta-go quen thuộc: cạnh huyền của tam giác vuông.
Tính tay: d(𝐚, 𝐛) = √((3.0 − 3.5)² + (2 − 5)²) = √(0.25 + 9) = √9.25 ≈ 3.041.
Khoảng cách Manhattan (Man-hát-tân): đi theo ô bàn cờ
d1(𝐚, 𝐛) = ∑|ai − bi|
(đọc: "d một của a, b bằng tổng trị tuyệt đối a i trừ b i")
Dấu |…| là trị tuyệt đối: bỏ dấu trừ đi. Tên Manhattan đến từ khu phố ở New York có đường kẻ ô vuông như bàn cờ: bạn không thể đi chéo xuyên tòa nhà, phải đi dọc rồi đi ngang.
Tính tay: d1(𝐚, 𝐛) = |−0.5| + |−3| = 0.5 + 3 = 3.5. Lớn hơn Euclid một chút, hợp lý vì đường chim bay luôn ngắn nhất.
Code NumPy
# [A3]: Khoảng cách giữa 2 phòng trọ  — mỗi phòng là 1 vector [giá (triệu), km đến trường]
A = np.array([3.0, 2.0])
B = np.array([3.5, 5.0])

d_euclid    = np.sqrt(np.sum((A - B) ** 2))   # √∑(aᵢ − bᵢ)²
d_manhattan = np.sum(np.abs(A - B))           # ∑|aᵢ − bᵢ|

print("Khoảng cách Euclid    :", round(d_euclid, 3))
print("Kiểm tra np.linalg.norm:", round(np.linalg.norm(A - B), 3))
print("Khoảng cách Manhattan :", d_manhattan)
Kết quả:
Khoảng cách Euclid    : 3.041
Kiểm tra np.linalg.norm: 3.041
Khoảng cách Manhattan : 3.5
Hai con số khớp với phần tính tay. Dòng giữa dùng np.linalg.norm, hàm tính độ dài của một vector, ký hiệu ‖𝐯‖ (đọc: "chuẩn của v"). Khoảng cách Euclid giữa 𝐚 và 𝐛 chính là độ dài của vector hiệu 𝐚 − 𝐛, nên np.linalg.norm(A - B) là cách viết tắt rất hay dùng.
Đổi đơn vị, máy chọn sai: vì sao phải chuẩn hóa
Một ví dụ "đau ví"
Bạn muốn phòng 3 triệu, cách trường 1 km. Có hai lựa chọn:
- Phòng A: 3,1 triệu (rẻ hơn chút) nhưng xa tận 9 km.
- Phòng B: 3,3 triệu, cách trường 1,2 km.
Ai cũng thấy B hợp hơn: đắt hơn 200 nghìn nhưng đỡ 8 km đi lại mỗi ngày. Giờ thử để máy chọn, một lần ghi giá bằng đồng, một lần bằng triệu:
# [A4]: Vì sao phải CHUẨN HÓA? — đổi đơn vị là đổi luôn kết quả!
# Bạn muốn: phòng 3 triệu, cách trường 1 km
# Phòng A: 3,1 triệu nhưng cách 9 km   |   Phòng B: 3,3 triệu, cách 1,2 km
q_dong  = np.array([3_000_000, 1.0]);  A_dong  = np.array([3_100_000, 9.0]);  B_dong  = np.array([3_300_000, 1.2])
q_trieu = np.array([3.0, 1.0]);        A_trieu = np.array([3.1, 9.0]);        B_trieu = np.array([3.3, 1.2])

print("Giá tính bằng ĐỒNG : d(q,A) =", round(np.linalg.norm(q_dong - A_dong), 1),
      "  d(q,B) =", round(np.linalg.norm(q_dong - B_dong), 1))
print("Giá tính bằng TRIỆU: d(q,A) =", round(np.linalg.norm(q_trieu - A_trieu), 2),
      "  d(q,B) =", round(np.linalg.norm(q_trieu - B_trieu), 2))

# Chuẩn hóa Min-Max: x' = (x − min) / (max − min)  →  mọi cột về đoạn [0, 1]
def chuan_hoa(X):
    return (X - X.min(axis=0)) / (X.max(axis=0) - X.min(axis=0))

X_dong  = np.array([q_dong, A_dong, B_dong])
X_trieu = np.array([q_trieu, A_trieu, B_trieu])
print("\nSau chuẩn hóa (đơn vị đồng):\n",  chuan_hoa(X_dong).round(3))
print("Sau chuẩn hóa (đơn vị triệu):\n", chuan_hoa(X_trieu).round(3))
Kết quả:
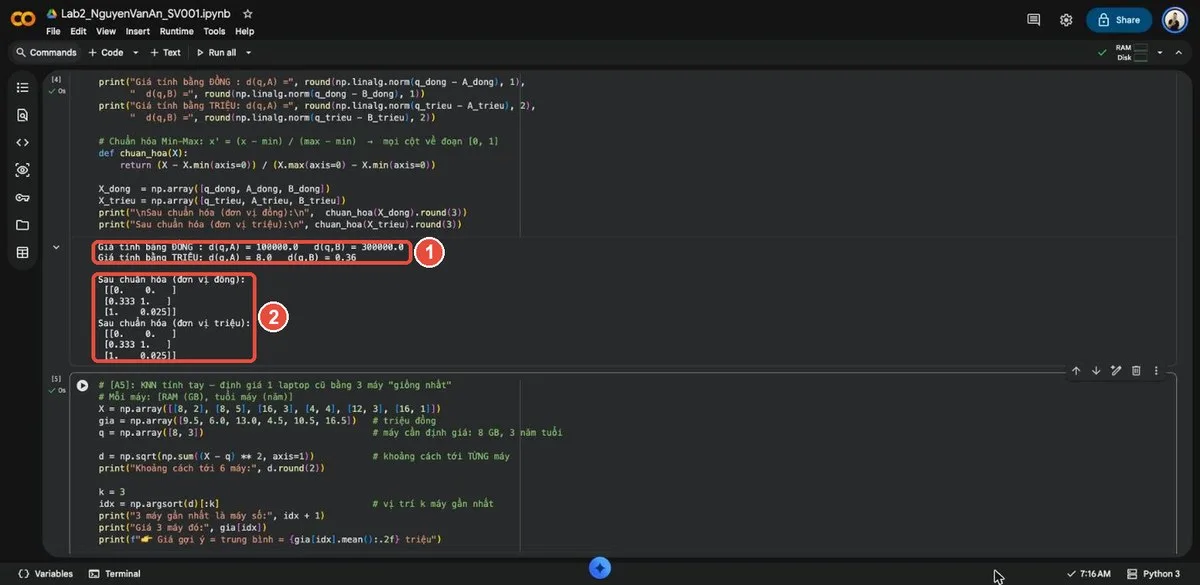
Giá tính bằng ĐỒNG : d(q,A) = 100000.0   d(q,B) = 300000.0
Giá tính bằng TRIỆU: d(q,A) = 8.0   d(q,B) = 0.36

Sau chuẩn hóa (đơn vị đồng):
 [[0.    0.   ]
 [0.333 1.   ]
 [1.    0.025]]
Sau chuẩn hóa (đơn vị triệu):
 [[0.    0.   ]
 [0.333 1.   ]
 [1.    0.025]]
Hai dòng đầu là vấn đề. Ghi giá bằng đồng, chênh lệch giá là cả trăm nghìn, còn chênh lệch km chỉ vài đơn vị. Khoảng cách gần như chỉ phản ánh giá, nên d(q, A) nhỏ hơn và máy chọn nhầm phòng A, xa 9 km. Đổi sang triệu thì máy chọn đúng B. Cùng ba căn phòng, chỉ đổi đơn vị mà đổi luôn kết quả.
Chuẩn hóa Min-Max: đưa mọi cột về cùng thang 0 đến 1
x' = (x − min) / (max − min)
(đọc: "x phẩy bằng x trừ min, chia cho max trừ min")
Với mỗi cột, giá trị nhỏ nhất thành 0, lớn nhất thành 1, còn lại nằm ở giữa theo đúng tỉ lệ. Tính tay cột giá (đơn vị triệu): ba số 3.0, 3.1, 3.3 có min = 3.0, max = 3.3.
- q: (3.0 − 3.0) / (3.3 − 3.0) = 0
- A: (3.1 − 3.0) / 0.3 = 0.1 / 0.3 ≈ 0.333
- B: (3.3 − 3.0) / 0.3 = 1
Cột km: 1.0, 9.0, 1.2 có min = 1, max = 9, nên B thành (1.2 − 1) / 8 = 0.025. Tất cả khớp với bảng in ra. Và điều quan trọng nhất: hai bảng sau chuẩn hóa giống hệt nhau, dù một bảng ghi giá bằng đồng, một bảng bằng triệu. Đổi đơn vị không còn ảnh hưởng gì nữa.
Trong code, X.min(axis=0) nghĩa là lấy min theo từng cột (đi dọc xuống), nên mỗi cột được chuẩn hóa riêng bằng min, max của chính nó.
KNN tính tay: "ngưu tầm ngưu"
Ý tưởng
Muốn bán laptop (láp-tóp) cũ mà không biết hét giá bao nhiêu? Bạn lên nhóm mua bán, tìm 3 máy giống máy mình nhất, rồi lấy trung bình giá của chúng. Đó chính là thuật toán KNN, viết tắt của k-Nearest Neighbors: k láng giềng gần nhất. "Giống nhất" ở đây nghĩa là "khoảng cách nhỏ nhất", đúng thứ bạn vừa học.
ŷ = (1/k) ∑ yi, với i chạy trên k máy gần nhất
(đọc: "y mũ bằng một phần k nhân tổng y i")
Ở đây yi là giá của máy thứ i, còn ŷ ("y mũ") là giá dự đoán. Cộng k giá lại rồi chia k, tức là lấy trung bình.
Tính tay với 6 máy
Máy cần định giá: 8 GB RAM, 3 năm tuổi. Mỗi máy là vector [RAM (GB), tuổi máy (năm)]:
| Máy | RAM (GB) | Tuổi (năm) | Giá (triệu) | Khoảng cách tới (8 GB, 3 năm) |
|---|---|---|---|---|
| 1 | 8 | 2 | 9.5 | √(0² + 1²) = 1 |
| 2 | 8 | 5 | 6.0 | √(0² + 2²) = 2 |
| 3 | 16 | 3 | 13.0 | √(8² + 0²) = 8 |
| 4 | 4 | 4 | 4.5 | √(4² + 1²) ≈ 4.12 |
| 5 | 12 | 3 | 10.5 | √(4² + 0²) = 4 |
| 6 | 16 | 1 | 16.5 | √(8² + 2²) ≈ 8.25 |
Ba khoảng cách nhỏ nhất là 1, 2, 4, tức máy 1, 2 và 5. Giá gợi ý = (9.5 + 6.0 + 10.5) / 3 = 26 / 3 ≈ 8.67 triệu.
Code NumPy: không cần vòng for
# [A5]: KNN tính tay — định giá 1 laptop cũ bằng 3 máy "giống nhất"
# Mỗi máy: [RAM (GB), tuổi máy (năm)]
X = np.array([[8, 2], [8, 5], [16, 3], [4, 4], [12, 3], [16, 1]])
gia = np.array([9.5, 6.0, 13.0, 4.5, 10.5, 16.5])   # triệu đồng
q = np.array([8, 3])                                # máy cần định giá: 8 GB, 3 năm tuổi

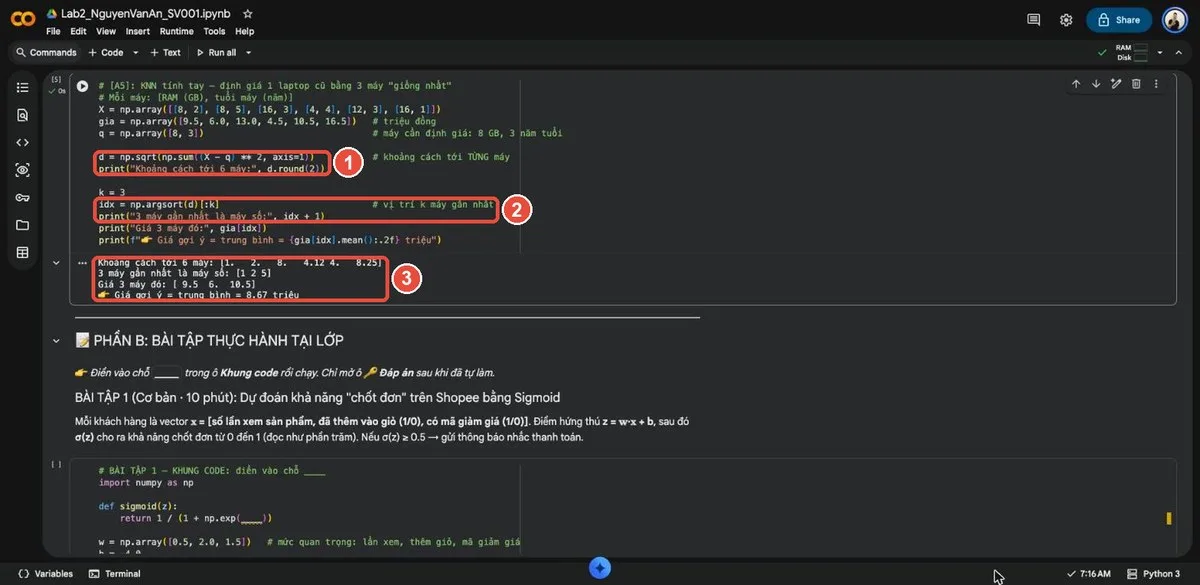
d = np.sqrt(np.sum((X - q) ** 2, axis=1))           # khoảng cách tới TỪNG máy
print("Khoảng cách tới 6 máy:", d.round(2))

k = 3
idx = np.argsort(d)[:k]                             # vị trí k máy gần nhất
print("3 máy gần nhất là máy số:", idx + 1)
print("Giá 3 máy đó:", gia[idx])
print(f"👉 Giá gợi ý = trung bình = {gia[idx].mean():.2f} triệu")
Kết quả:
Khoảng cách tới 6 máy: [1.   2.   8.   4.12 4.   8.25]
3 máy gần nhất là máy số: [1 2 5]
Giá 3 máy đó: [ 9.5  6.  10.5]
👉 Giá gợi ý = trung bình = 8.67 triệu
Ba điểm đáng chú ý trong đoạn code ngắn này:
X - q: X có 6 hàng, q chỉ có 2 số. NumPy tự trừ q vào từng hàng của X, nên tính được khoảng cách tới cả 6 máy một lúc.axis=1: cộng theo từng hàng (đi ngang), mỗi máy ra một khoảng cách. Ngược vớiaxis=0(theo cột) ở phần chuẩn hóa.np.argsort(d)không trả về khoảng cách đã sắp xếp mà trả về vị trí của chúng theo thứ tự từ nhỏ đến lớn;[:k]lấy k vị trí đầu. Python đếm từ 0 nên mình inidx + 1cho khớp số thứ tự máy.
Tự kiểm tra: đổi k = 1 thì giá gợi ý là bao nhiêu? (Đáp án: 9.5 triệu, vì chỉ lấy đúng máy 1.)
💡 Ở ví dụ 6 máy này, mình chưa chuẩn hóa để bạn dễ tính tay. Với dữ liệu thật có nhiều cột đơn vị khác nhau, luôn chuẩn hóa trước khi đo khoảng cách. Bài tập dưới đây cho bạn thấy rõ vì sao.
Thực hành: gợi ý phòng trọ, có và không chuẩn hóa
Đề bài
Bạn cần phòng khoảng 2,7 triệu/tháng, cách trường 1,5 km, rộng 20 m². Có 8 phòng trên nhóm cho thuê. Hãy tìm 3 phòng giống yêu cầu nhất, trước và sau khi chuẩn hóa, rồi so sánh.
| Phòng | Giá (triệu) | Km đến trường | Diện tích (m²) |
|---|---|---|---|
| A | 2.7 | 1.0 | 17 |
| B | 2.9 | 1.2 | 24 |
| C | 2.2 | 3.5 | 15 |
| D | 4.5 | 1.2 | 30 |
| E | 2.6 | 2.0 | 20 |
| F | 3.0 | 4.0 | 28 |
| G | 1.8 | 6.0 | 14 |
| H | 3.6 | 1.5 | 21 |
Khung code: điền vào chỗ ____
- Tính khoảng cách chưa chuẩn hóa
d_thotừ từng phòng tới q. - Chuẩn hóa Min-Max cả bảng X và cả q bằng cùng
x_min,x_maxcủa bảng. - Dùng
np.argsort(...)[:3]lấy 3 phòng gần nhất cho cả hai cách. - So sánh hai danh sách và thử giải thích vì sao chúng khác nhau.
# BÀI TẬP 2 — KHUNG CODE: điền vào chỗ ____
import numpy as np
import pandas as pd

ten_phong = ["A", "B", "C", "D", "E", "F", "G", "H"]
X = np.array([
    [2.7, 1.0, 17], [2.9, 1.2, 24], [2.2, 3.5, 15], [4.5, 1.2, 30],
    [2.6, 2.0, 20], [3.0, 4.0, 28], [1.8, 6.0, 14], [3.6, 1.5, 21],
])
q = np.array([2.7, 1.5, 20])          # phòng mong muốn

# 1. Khoảng cách CHƯA chuẩn hóa
d_tho = np.sqrt(np.sum((X - ____) ** 2, axis=1))

# 2. Chuẩn hóa Min-Max — dùng CÙNG min, max của bảng cho cả q
x_min, x_max = X.min(axis=0), X.max(axis=0)
X_cc = (X - ____) / (____ - ____)
q_cc = (q - x_min) / (x_max - x_min)
d_cc = np.sqrt(np.sum((X_cc - q_cc) ** 2, axis=1))

# 3. Lấy 3 phòng gần nhất
top_tho = np.argsort(d_tho)[:3]
top_cc  = np.argsort(____)[:3]

bang = pd.DataFrame(X, columns=["Giá (tr)", "Km", "m²"], index=ten_phong)
bang["d chưa chuẩn hóa"] = d_tho.round(2)
bang["d đã chuẩn hóa"] = d_cc.round(2)
print(bang)
print("\nTop 3 CHƯA chuẩn hóa:", [ten_phong[i] for i in top_tho])
print("Top 3 ĐÃ chuẩn hóa  :", [ten_phong[i] for i in top_cc])
Xem đáp án
Ba dòng có chỗ trống, điền xong như sau:
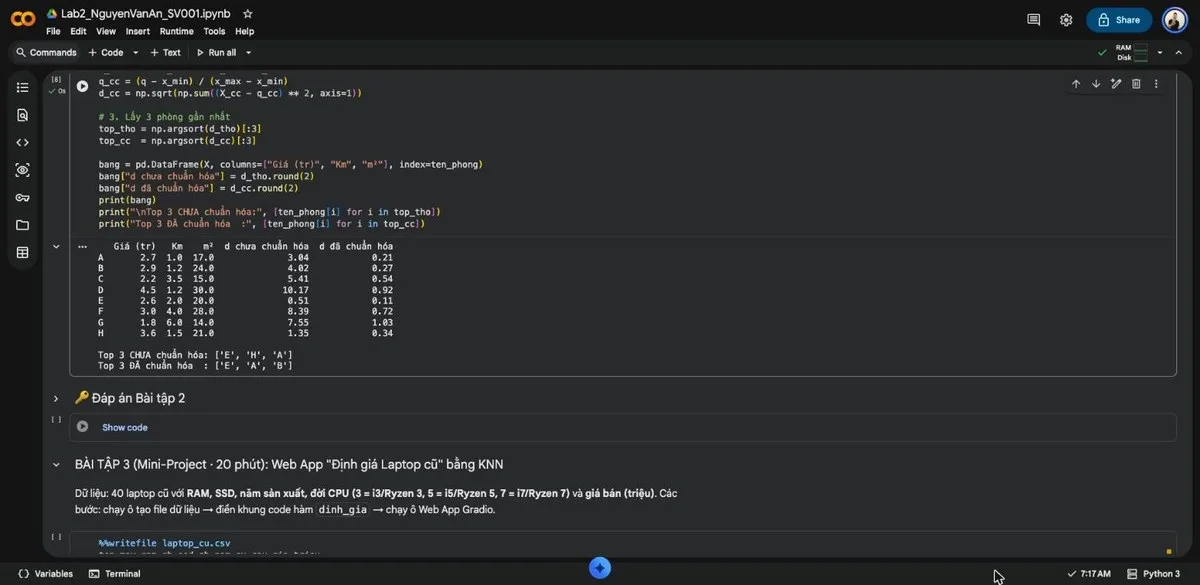
d_tho = np.sqrt(np.sum((X - q) ** 2, axis=1))
X_cc = (X - x_min) / (x_max - x_min)
top_cc  = np.argsort(d_cc)[:3]
Kết quả:
   Giá (tr)   Km    m²  d chưa chuẩn hóa  d đã chuẩn hóa
A       2.7  1.0  17.0              3.04            0.21
B       2.9  1.2  24.0              4.02            0.27
C       2.2  3.5  15.0              5.41            0.54
D       4.5  1.2  30.0             10.17            0.92
E       2.6  2.0  20.0              0.51            0.11
F       3.0  4.0  28.0              8.39            0.72
G       1.8  6.0  14.0              7.55            1.03
H       3.6  1.5  21.0              1.35            0.34

Top 3 CHƯA chuẩn hóa: ['E', 'H', 'A']
Top 3 ĐÃ chuẩn hóa : ['E', 'A', 'B']Vì sao phòng H bị loại sau khi chuẩn hóa?
Chưa chuẩn hóa, cột diện tích có số lớn (14 đến 30) nên lấn át hai cột còn lại. Phòng H chỉ chênh 1 m² so với yêu cầu nên trông rất "giống", dù đắt hơn tận 900 nghìn mỗi tháng.
Sau chuẩn hóa, mọi chênh lệch được đo bằng "phần của cả khoảng". Giá trong bảng chạy từ 1,8 đến 4,5 triệu, tức khoảng giá rộng 2,7 triệu. Chênh 0,9 triệu = 0,9 / 2,7 = 1/3 cả khoảng giá, một chênh lệch lớn. Trong khi đó chênh 1 m² chỉ là 1/16 khoảng diện tích (14 đến 30). Tính tay khoảng cách đã chuẩn hóa của H: √((1/3)² + 0² + (1/16)²) ≈ √(0.111 + 0.004) ≈ 0.34, khớp bảng. Vì vậy H tụt xuống thứ 4, còn B (giá sát, gần trường) lên top 3.
💡 Nhớ chuẩn hóa q bằng min, max của bảng, đừng chuẩn hóa q riêng. q chỉ là một dòng, nếu tự lấy min, max của chính nó theo cột thì max = min, phép chia thành 0/0 và cho ra
nan. Kể cả khi không lỗi, dùng min, max khác nhau cho q và cho bảng cũng giống như đo hai thứ bằng hai cây thước khác nhau.
Lỗi thường gặp
| Thông báo lỗi | Nguyên nhân | Cách xử lý |
|---|---|---|
NameError: name '____' is not defined |
Còn chỗ trống chưa điền | Tìm ____ trong ô và điền đủ |
NameError: name 'np' is not defined |
Chưa chạy ô import | Chạy ô có import numpy as np trước (ô A1) |
ValueError: operands could not be broadcast |
Vector q khác số phần tử với số cột của X | Kiểm tra .shape: q phải có đúng số cột của X |
Tự luyện thêm
- Coi trọng giá hơn: nếu bạn rất để ý tiền phòng, hãy nhân cột giá đã chuẩn hóa với 2 trước khi tính khoảng cách. Top 3 thay đổi thế nào? Gợi ý: tạo
trong_so = np.array([2, 1, 1])rồi tính khoảng cách trên(X_cc - q_cc) * trong_so. - Đổi sang Manhattan: thay khoảng cách Euclid bằng
np.sum(np.abs(X_cc - q_cc), axis=1). Top 3 có giống Euclid không?
Tóm tắt
- Máy đo "độ giống" bằng khoảng cách giữa hai vector: Euclid (đường chim bay) hoặc Manhattan (đi theo ô bàn cờ). Càng nhỏ càng giống.
- Các cột có đơn vị khác nhau thì cột số to sẽ lấn át. Chuẩn hóa Min-Max đưa mọi cột về đoạn [0, 1] để công bằng.
- KNN: tìm k điểm gần nhất rồi lấy trung bình giá trị của chúng. Trong NumPy chỉ cần
np.argsort(d)[:k]và.mean().
| Ký hiệu Toán | Cách đọc | Lệnh NumPy |
|---|---|---|
| 𝐚 = [3.0, 2.0] | "vector a" | a = np.array([3.0, 2.0]) |
| ai | "a i" (phần tử thứ i) | a[i] (Python đếm từ 0) |
| d(𝐚, 𝐛) = √∑(ai − bi)² | "d của a, b bằng căn của tổng bình phương a i trừ b i" | np.sqrt(np.sum((a - b) ** 2)) |
| d1(𝐚, 𝐛) = ∑|ai − bi| | "d một của a, b bằng tổng trị tuyệt đối a i trừ b i" | np.sum(np.abs(a - b)) |
| ‖𝐯‖ | "chuẩn của v" (độ dài của v) | np.linalg.norm(v) |
| x' = (x − min) / (max − min) | "x phẩy bằng x trừ min, chia cho max trừ min" | (X - X.min(axis=0)) / (X.max(axis=0) - X.min(axis=0)) |
| ŷ = (1/k) ∑ yi | "y mũ bằng một phần k nhân tổng y i" | y[np.argsort(d)[:k]].mean() |
Bài tiếp theo trong series: Mini-App định giá laptop cũ bằng KNN. Từ 6 máy tính tay, mình sẽ chuyển sang 40 laptop thật với 4 thông số, tự viết hàm định giá và đóng gói thành Web App có link gửi bạn bè dùng thử.
