LoRA là gì trong AI? Tự fine-tune model nhỏ bằng Python trên CPU (2026)
Trong bài này
- Fine-tune là gì, LoRA là gì?
- Cần chuẩn bị
- Bước 1: Cài thư viện
- Bước 2: Chọn model nền và xem nó có những lớp nào
- Bước 3: Thử model gốc trước khi fine-tune
- Bước 4: Chuẩn bị dữ liệu huấn luyện
- Bước 5: Cấu hình LoRA và huấn luyện
- Bước 6: Hỏi lại model đã gắn LoRA
- Bước 7: Adapter nằm ở đâu, dùng lại thế nào
- Lỗi thường gặp
- Target modules not found in the base model
- Chỉ chọn q_proj, v_proj nên LoRA gần như không tác động
- Cảnh báo "falling back to its reference PyTorch implementation"
- Mong fine-tune sửa được kiến thức sai
- Câu hỏi thường gặp
- Nên dùng fine-tune hay RAG?
- Cần bao nhiêu ví dụ?
- Có gộp adapter vào model được không?
- Không có GPU thì fine-tune được model lớn không?
- Nguồn tham khảo
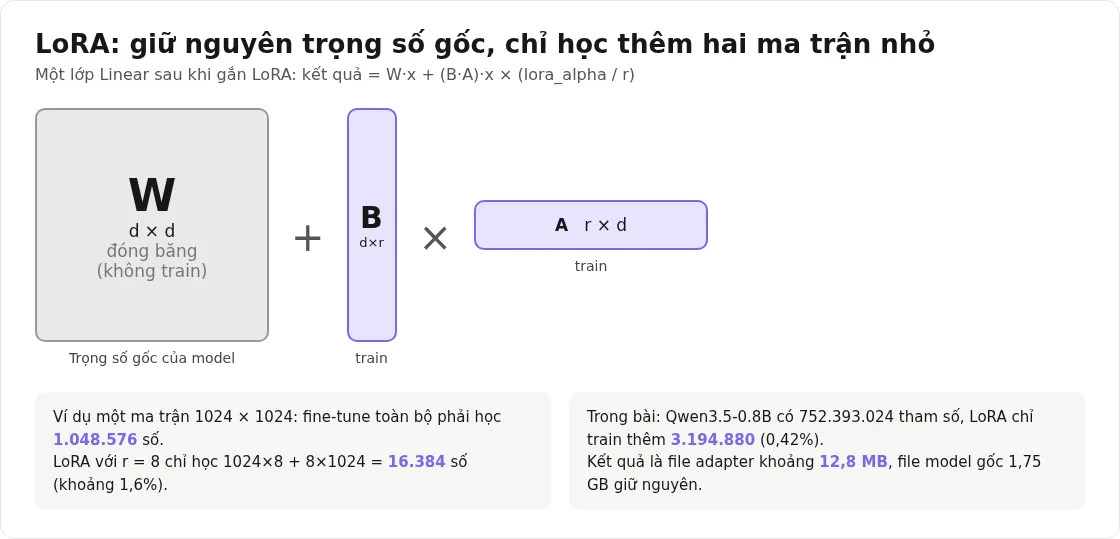
Khi tìm "LoRA là gì", các bạn sẽ gặp hai thứ khác nhau: LoRa (sóng radio trong IoT) và LoRA trong AI (Low-Rank Adaptation), một cách fine-tune model ngôn ngữ mà chỉ cần huấn luyện một phần rất nhỏ tham số. Bài này nói về cái thứ hai. Mình sẽ giải thích fine-tune và LoRA là gì, rồi cùng các bạn tự fine-tune model Qwen3.5-0.8B để nó giải thích lỗi lập trình bằng tiếng Việt theo đúng mẫu 3 dòng: Lỗi / Nguyên nhân / Cách sửa.
Toàn bộ chạy bằng CPU, không cần GPU, không cần API key. Phần huấn luyện mất khoảng 9 phút rưỡi trên 4 nhân CPU. Bài dùng peft 0.21.3 và trl 1.18.0 (cả hai lên PyPI ngày 13/11/2026), thử nghiệm ngày 15/11/2026.
Fine-tune là gì, LoRA là gì?
Fine-tune (tinh chỉnh) là huấn luyện thêm một model đã có sẵn bằng dữ liệu của mình để nó làm tốt một việc cụ thể. Fine-tune toàn bộ nghĩa là cập nhật mọi trọng số, rất tốn bộ nhớ. LoRA giữ nguyên (đóng băng) trọng số gốc và chỉ học thêm hai ma trận nhỏ A và B gắn vào một số lớp. Tài liệu PEFT mô tả đúng như vậy: các cập nhật trọng số được biểu diễn bằng hai ma trận nhỏ, còn ma trận gốc "remains frozen".
Cần chuẩn bị
- Python 3.10 trở lên (mình dùng 3.12), RAM trống khoảng 6 GB, ổ cứng trống khoảng 5 GB (model 1,75 GB và thư viện).
- Biết chạy model bằng transformers. Nếu chưa, các bạn đọc trước bài Hugging Face là gì.
- Khoảng 30–40 phút, phần lớn là chờ tải model và chờ huấn luyện.
Bước 1: Cài thư viện
Tạo môi trường ảo, cài PyTorch bản CPU, rồi cài transformers (chạy model), peft (LoRA), trl (trình huấn luyện SFTTrainer) và datasets.
python -m venv .venv && source .venv/bin/activate
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install transformers peft trl accelerate datasets jinja2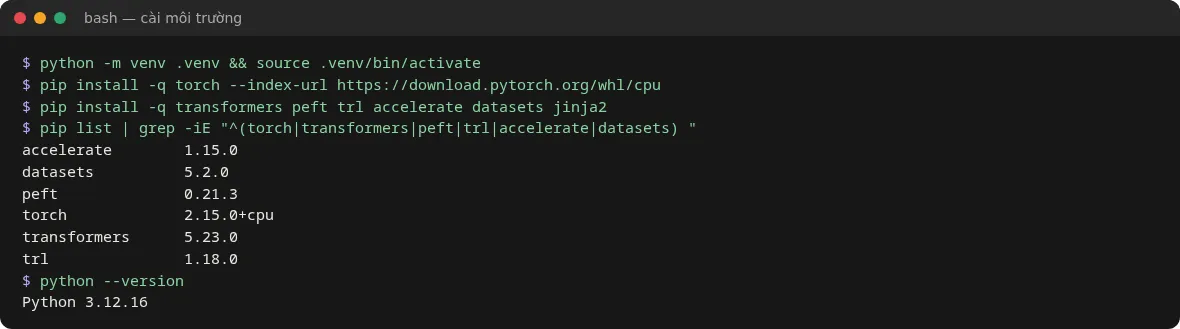
Bước 2: Chọn model nền và xem nó có những lớp nào
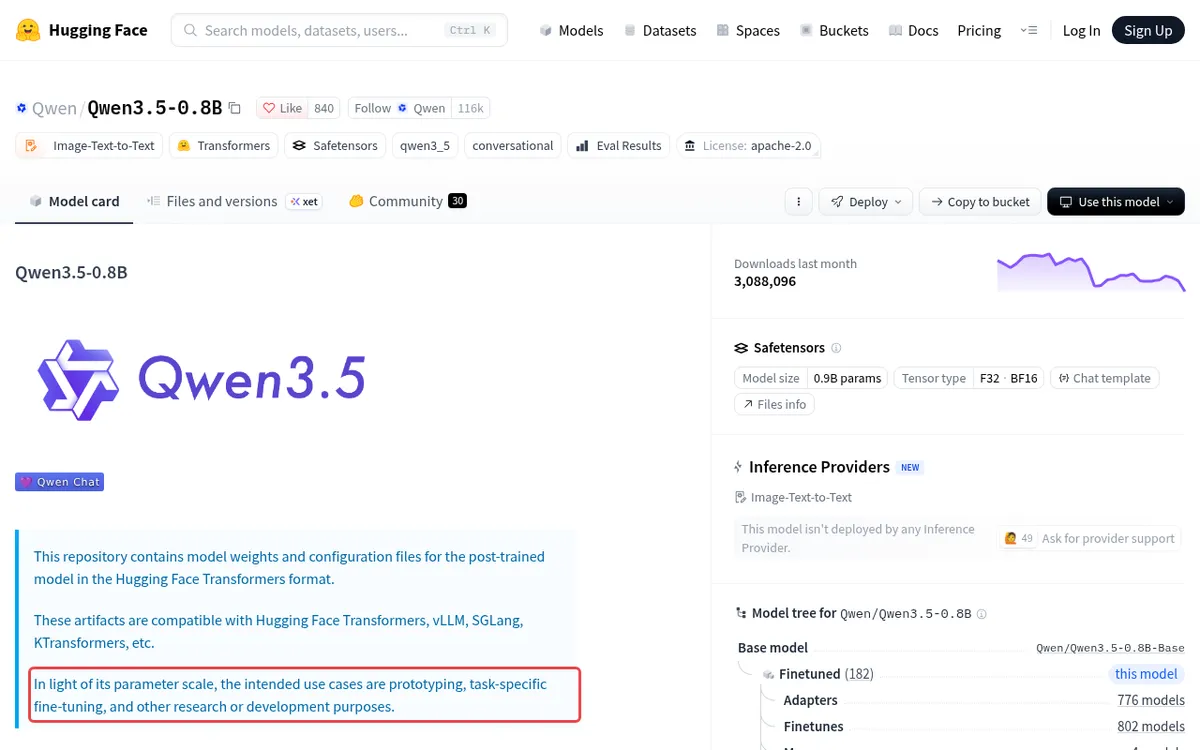
Mình chọn Qwen/Qwen3.5-0.8B: nhỏ, giấy phép Apache 2.0, tải không cần đăng nhập. Chính model card ghi model này dành cho "prototyping, task-specific fine-tuning", tức là hợp để tập fine-tune.
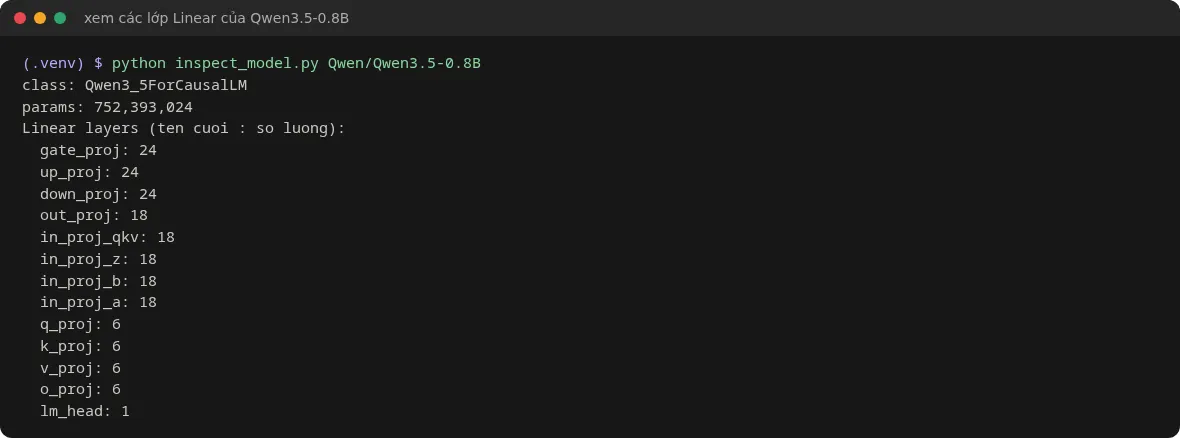
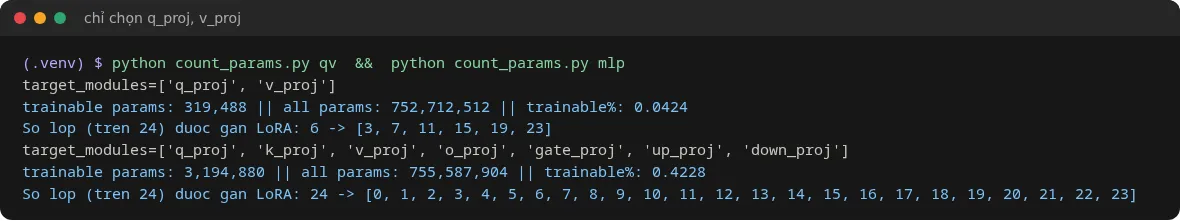
LoRA được gắn vào các lớp Linear, nên trước khi cấu hình, mình liệt kê tên các lớp này bằng một script nhỏ (inspect_model.py). Kết quả cho thấy model có 752.393.024 tham số, 24 khối. Đáng chú ý: q_proj, v_proj chỉ có ở 6 khối, còn 18 khối kia dùng linear attention với tên khác (in_proj_qkv, out_proj…). Các lớp MLP gate_proj, up_proj, down_proj thì có ở cả 24 khối.
Bước 3: Thử model gốc trước khi fine-tune
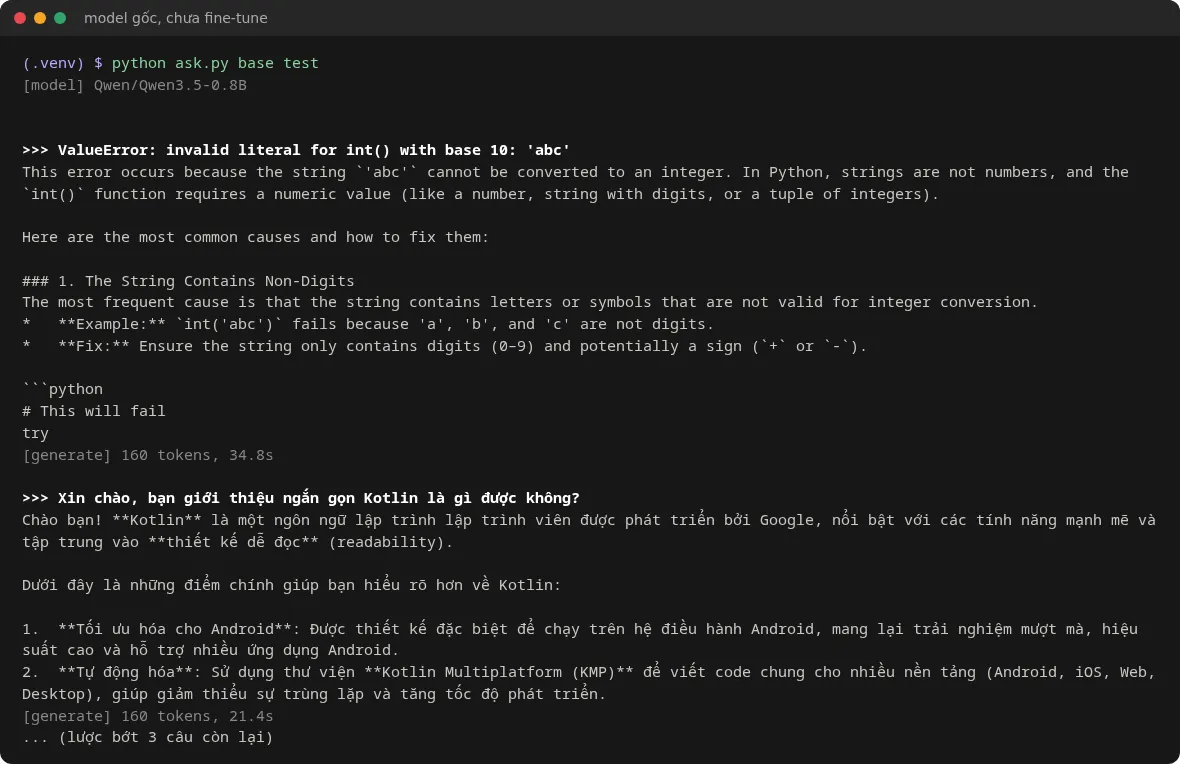
Luôn đo trước để biết fine-tune có đáng không. Mình hỏi model gốc 4 thông báo lỗi và 1 câu hỏi thường (không có trong dữ liệu huấn luyện). Model gốc trả lời bằng tiếng Anh, dài, kiểu Markdown, câu nào cũng chạm giới hạn 160 token mà chưa xong.
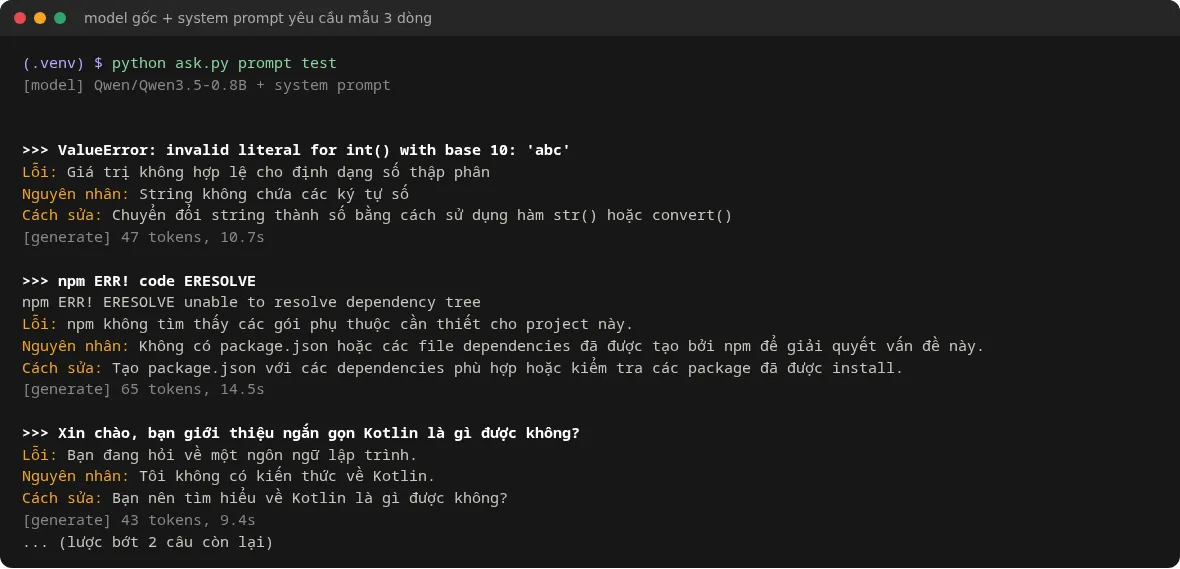
Cách rẻ nhất là thêm system prompt yêu cầu đúng 3 dòng. Model làm theo mẫu, nhưng nội dung yếu (lỗi int('abc') lại khuyên "dùng str()"), và nó ép cả câu hỏi về Kotlin vào mẫu lỗi: "Nguyên nhân: Tôi không có kiến thức về Kotlin."
Bước 4: Chuẩn bị dữ liệu huấn luyện
Mình tự viết 40 cặp "thông báo lỗi → giải thích 3 dòng", gồm lỗi Android/Kotlin, PHP/Laravel, Python, Node.js, SQL và Git. Dữ liệu ở dạng prompt-completion. Theo tài liệu TRL, với dạng này SFTTrainer mặc định chỉ tính loss trên phần completion (câu trả lời), không học lại câu hỏi.
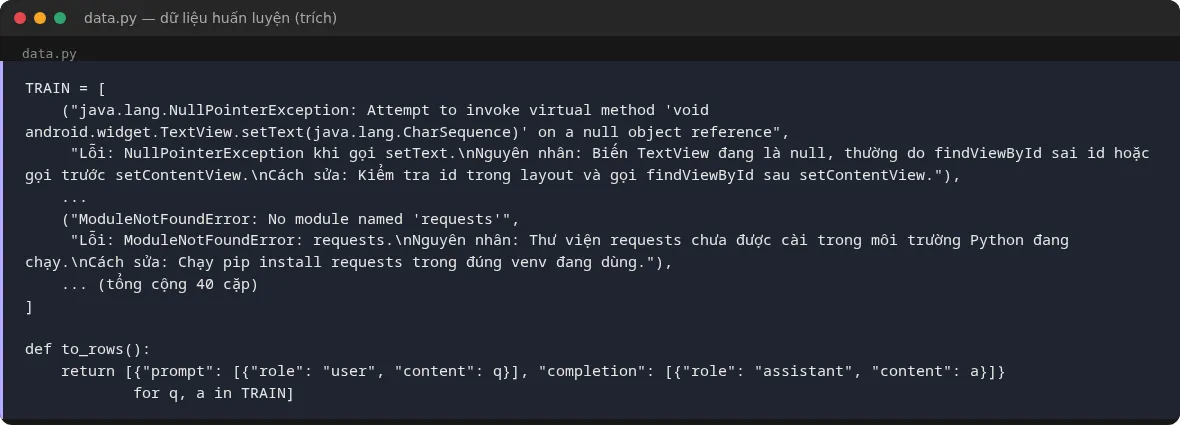
Chất lượng dữ liệu quyết định kết quả: câu trả lời mẫu phải đúng và cùng một định dạng. 4 lỗi dùng để kiểm tra mình để riêng trong TEST, model không được thấy khi huấn luyện.
Bước 5: Cấu hình LoRA và huấn luyện
Mình gắn LoRA vào cả lớp attention và MLP, r=8, lora_alpha=16, học 3 epoch với learning rate 2e-4, batch 4. Phần chính của train_lora.py:
lora = LoraConfig(r=8, lora_alpha=16, lora_dropout=0.05, task_type="CAUSAL_LM",
                  target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                                  "gate_proj", "up_proj", "down_proj"])
args = SFTConfig(output_dir="lora-loi-3-dong-mlp", num_train_epochs=3,
                 per_device_train_batch_size=4, learning_rate=2e-4,
                 logging_steps=5, save_strategy="no", use_cpu=True, max_length=256)
trainer = SFTTrainer(model=model, args=args, train_dataset=dataset,
                     processing_class=tok, peft_config=lora)
trainer.train()
trainer.save_model(args.output_dir)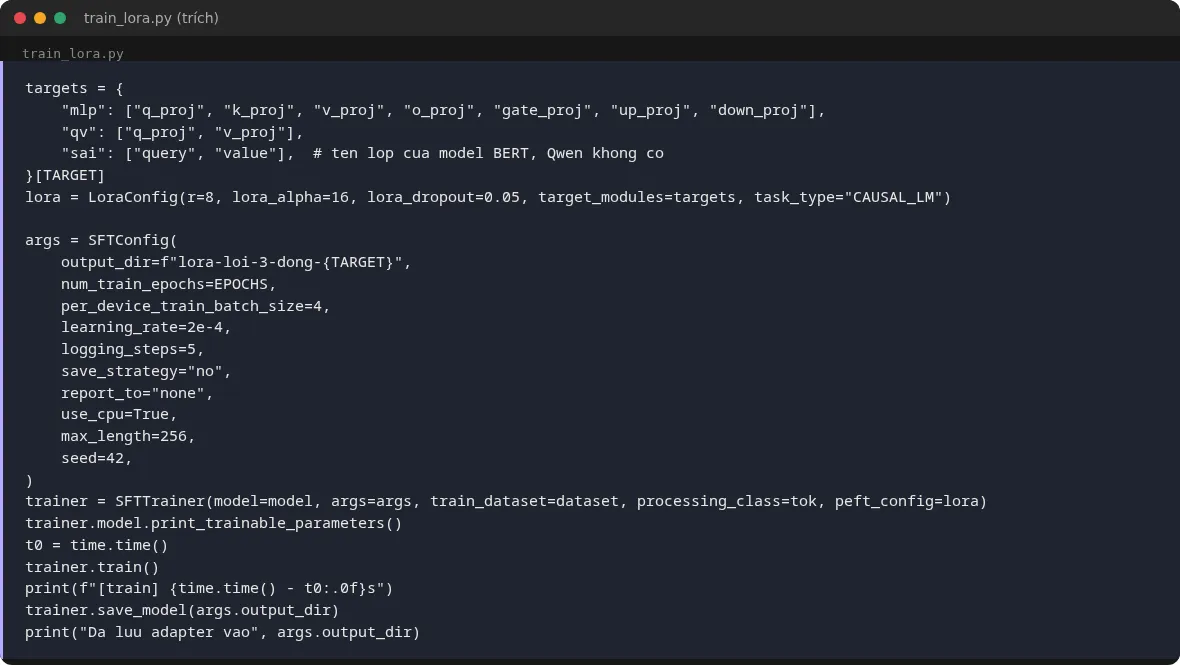
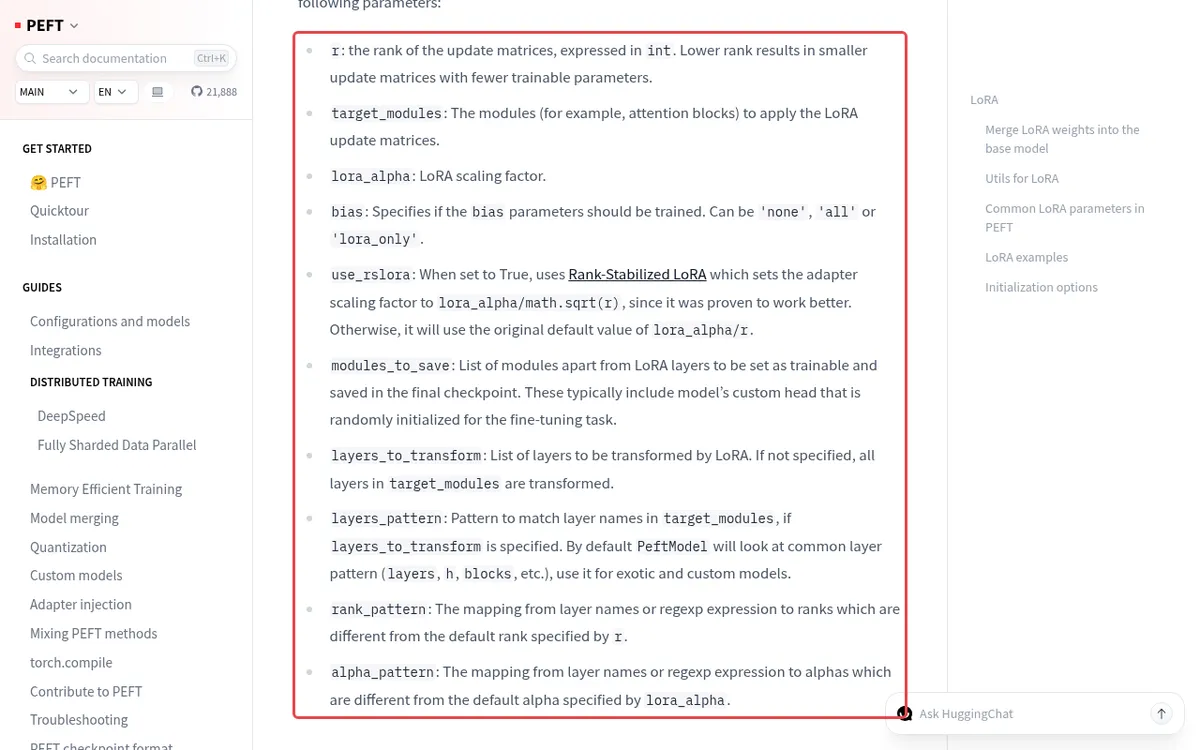
Ý nghĩa từng tham số các bạn xem trong tài liệu PEFT: r là hạng của hai ma trận (càng nhỏ càng ít tham số), lora_alpha là hệ số nhân, target_modules là các lớp được gắn LoRA.
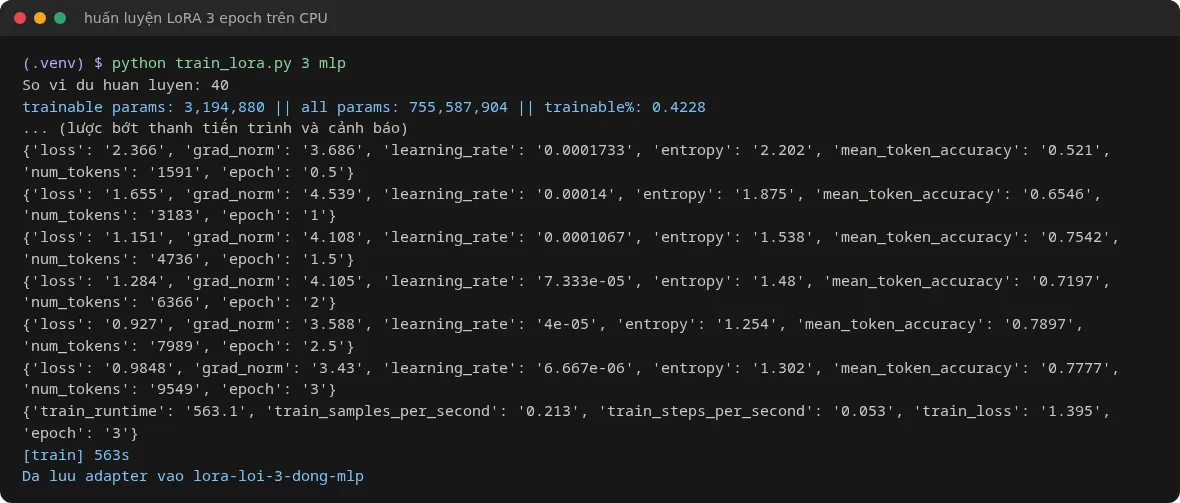
Chạy python train_lora.py 3 mlp. Dòng đầu cho biết chỉ có 3.194.880 tham số được huấn luyện (0,42%). Loss giảm từ 2,366 xuống khoảng 0,98, toàn bộ 30 bước mất 563 giây.
Bước 6: Hỏi lại model đã gắn LoRA
Script ask.py nạp model gốc rồi gắn adapter bằng PeftModel.from_pretrained(model, "lora-loi-3-dong-mlp"). Với 4 lỗi chưa từng thấy, model trả lời bằng tiếng Việt, đúng 3 dòng, chỉ 34–41 token. Điểm quan trọng: câu hỏi về Kotlin không bị ép vào mẫu lỗi như khi dùng system prompt.
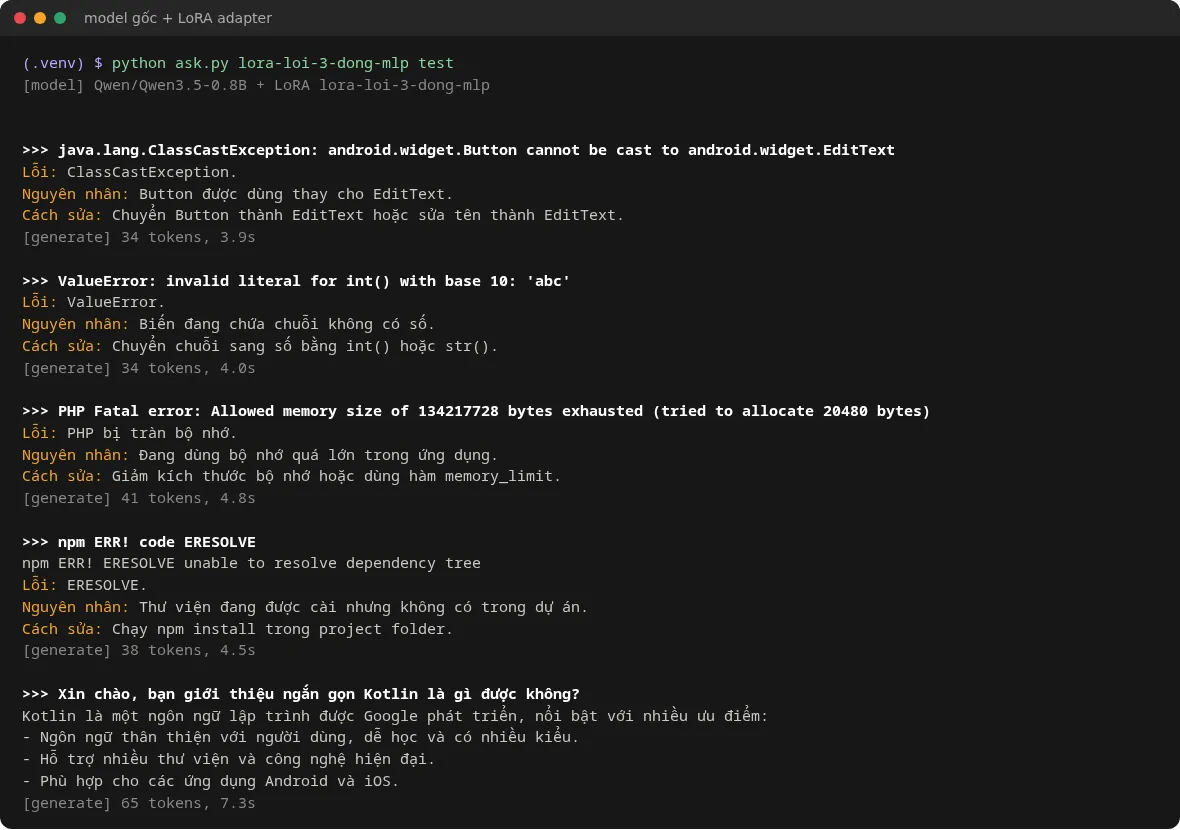
Nhưng các bạn đọc kỹ nội dung: với lỗi ERESOLVE, nguyên nhân thật thường là xung đột phiên bản giữa các gói (peer dependency), không phải "thư viện không có trong dự án". memory_limit là một thiết lập trong php.ini, không phải "hàm". Cả model gốc lẫn model đã fine-tune đều nói Kotlin "do Google phát triển", trong khi Kotlin do JetBrains phát triển. 40 ví dụ đủ dạy model cách trả lời, nhưng không làm nó biết thêm.
Bước 7: Adapter nằm ở đâu, dùng lại thế nào
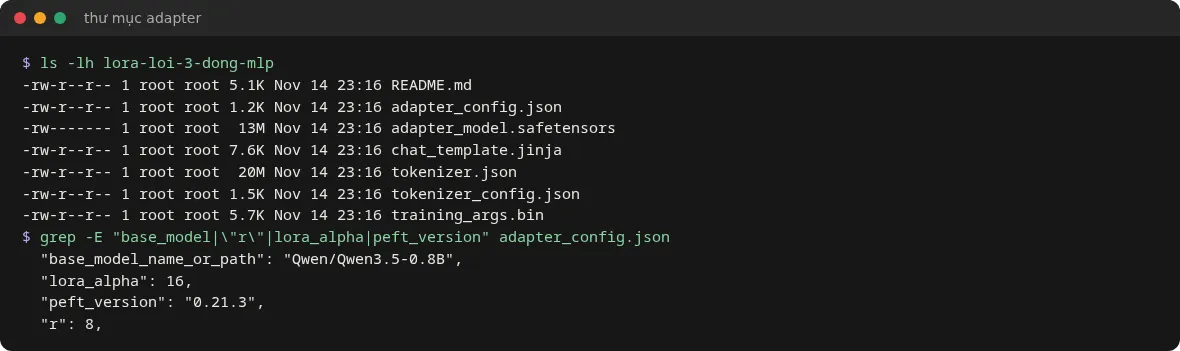
Kết quả huấn luyện là thư mục lora-loi-3-dong-mlp. File quan trọng là adapter_model.safetensors (12,8 MB) và adapter_config.json (ghi model gốc, r, lora_alpha), so với file model gốc 1,75 GB. Có thể giữ nhiều adapter cho nhiều việc khác nhau trên cùng một model gốc.
Lỗi thường gặp
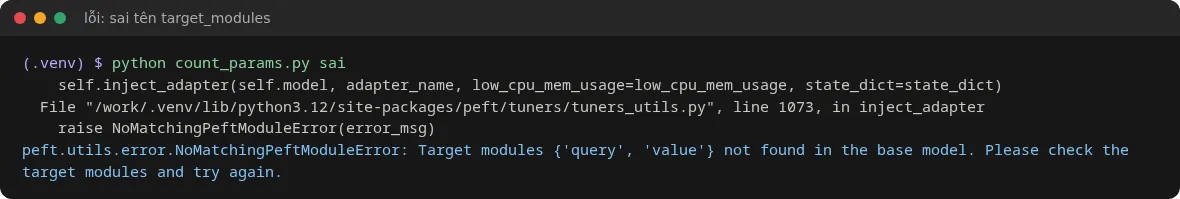
Target modules not found in the base model
Nhiều hướng dẫn cũ viết target_modules=["query", "value"]. Đó là tên lớp của BERT, Qwen không có, nên PEFT báo NoMatchingPeftModuleError. Cách sửa: in tên lớp như Bước 2 rồi chọn đúng tên, hoặc dùng target_modules="all-linear".
Chỉ chọn q_proj, v_proj nên LoRA gần như không tác động
Công thức ["q_proj", "v_proj"] không báo lỗi, nhưng với Qwen3.5-0.8B nó chỉ gắn vào 6/24 khối và chỉ có 319.488 tham số để học, ít hơn 10 lần so với cấu hình trong bài. Với model kiến trúc lai như Qwen3.5, nên thêm các lớp MLP.
Cảnh báo "falling back to its reference PyTorch implementation"
Khi chạy Qwen3.5 trên CPU, transformers báo thiếu causal_conv1d và flash-linear-attention. Chính cảnh báo nói là kết quả vẫn đúng, chỉ chậm hơn. Mọi số liệu trong bài đều chạy ở chế độ này.
Mong fine-tune sửa được kiến thức sai
Như Bước 6 cho thấy, model vẫn nói sai vài chỗ. Muốn model trả lời đúng theo tài liệu thì dùng RAG, còn fine-tune dùng để cố định giọng văn, định dạng, ngôn ngữ trả lời.
Câu hỏi thường gặp
Nên dùng fine-tune hay RAG?
Muốn model trả lời theo tài liệu hay dữ liệu luôn thay đổi (quy chế, giá, lịch học) thì dùng RAG. Muốn model luôn trả lời theo một định dạng, giọng văn hoặc ngôn ngữ cố định thì fine-tune. Hai cách có thể dùng chung.
Cần bao nhiêu ví dụ?
Trong bài, 40 ví dụ viết tay đã đủ để model theo đúng mẫu với lỗi mới. Để nội dung đáng tin hơn thì cần nhiều ví dụ hơn và phải kiểm tra từng câu trả lời mẫu, vì model sẽ học theo cả chỗ sai trong dữ liệu.
Có gộp adapter vào model được không?
Được. PEFT có hàm merge_and_unload() để gộp adapter vào model gốc thành một model độc lập. Tài liệu PEFT ghi rằng sau khi gộp, LoRA không làm chậm lúc chạy.
Không có GPU thì fine-tune được model lớn không?
Với CPU, các bạn nên dừng ở model khoảng 1 tỷ tham số và dữ liệu nhỏ như bài này: 30 bước đã mất hơn 9 phút. Model lớn hơn nên dùng GPU, kết hợp lượng tử hóa (QLoRA).
Nguồn tham khảo
- PEFT: LoRA conceptual guide
- TRL: SFT Trainer
- Hu và cộng sự (2021), LoRA: Low-Rank Adaptation of Large Language Models
- Model card Qwen/Qwen3.5-0.8B
- peft trên PyPI và trl trên PyPI
Ảnh chụp và thử nghiệm ngày 15/11/2026.