Token là gì trong AI? Đếm token tiếng Việt bằng Python (2026)
Trong bài này
- Token là gì?
- Cần chuẩn bị
- Bước 1: Mở Tokenizer Playground
- Bước 2: Dán một đoạn văn tiếng Việt
- Bước 3: So với cùng nội dung bằng tiếng Anh
- Bước 4: Xem token ID
- Bước 5: Cài tiktoken và transformers
- Bước 6: Đếm token bằng Python
- Bước 7: So sánh ba tokenizer và thử bỏ dấu
- Bước 8: Context window và những token các bạn không thấy
- Bước 9: Đối chiếu với tài liệu chính thức
- Lỗi thường gặp
- Văn bản tiếng Việt "nhìn giống nhau" nhưng tốn gấp đôi token
- KeyError khi dùng tiktoken cho Claude hoặc Gemini
- ImportError: apply_chat_template requires jinja2
- ModuleNotFoundError: No module named 'tiktoken'
- Câu hỏi thường gặp
- 1 token bằng bao nhiêu chữ tiếng Việt?
- Có nên viết prompt bằng tiếng Anh cho đỡ tốn token?
- Context window lớn thì cứ dán cả tài liệu vào là được?
- Đếm token trên trang web có giống trong Python không?
- Nguồn tham khảo
Dùng ChatGPT, Gemini hay Claude, các bạn sẽ gặp chữ "token" ở khắp nơi: giới hạn sử dụng, giá API tính theo triệu token, lỗi "prompt is too long". Bài này giải thích token là gì, rồi cùng các bạn tự đếm token của một đoạn văn tiếng Việt trên trang web và bằng Python. Đọc xong, các bạn sẽ biết vì sao tiếng Việt tốn token hơn tiếng Anh, context window là gì, và các lỗi hay gặp.
Mọi kết quả trong bài mình chạy thật ngày 13/11/2026, trên CPU, không cần GPU, không tài khoản, không API key. Phiên bản dùng: Python 3.12, tiktoken 0.14.0, transformers 5.22.2, tokenizers 0.23.3. Làm theo hết bài mất khoảng 20–30 phút.
Token là gì?
Model ngôn ngữ không đọc chữ trực tiếp. Trước khi văn bản đi vào model, một chương trình gọi là tokenizer cắt văn bản thành các mảnh nhỏ gọi là token, rồi đổi mỗi token thành một con số (token ID). Model chỉ làm việc với dãy số đó. Khi trả lời, model sinh ra từng token một, và tokenizer ghép chúng lại thành chữ cho các bạn đọc.
Một token có thể là một từ, một phần của từ, một dấu câu, thậm chí một phần của một ký tự. Mỗi họ model có tokenizer riêng, nên cùng một câu sẽ cho số token khác nhau trên ChatGPT, Gemini, Claude hay model mã nguồn mở. Số token quyết định tiền (API tính phí theo token), tốc độ và độ dài tối đa model đọc được một lần, tức là context window. Kể cả model chạy offline bằng Ollama cũng làm việc với token.
Cần chuẩn bị
- Một trình duyệt bất kỳ cho Bước 1–4. Không cần đăng nhập.
- Python 3.11 trở lên cho Bước 5–8 (
transformers5.x yêu cầu Python 3.11 trở lên). Máy Windows, macOS hay Linux đều được, không cần GPU. - Khoảng 300 MB ổ cứng cho môi trường ảo. Bài này chỉ tải file tokenizer, không tải trọng số model.
- Nếu chưa quen Hugging Face, các bạn đọc trước bài Hugging Face là gì.
Bước 1: Mở Tokenizer Playground
Các bạn mở trang huggingface.co/spaces/Xenova/the-tokenizer-playground. Trang chạy tokenizer ngay trong trình duyệt, không cần tài khoản. Mình giữ tokenizer mặc định gpt-4 / gpt-3.5-turbo / text-embedding-ada-002, tức bộ mã hóa cl100k_base sẽ dùng lại trong Python.
Bước 2: Dán một đoạn văn tiếng Việt
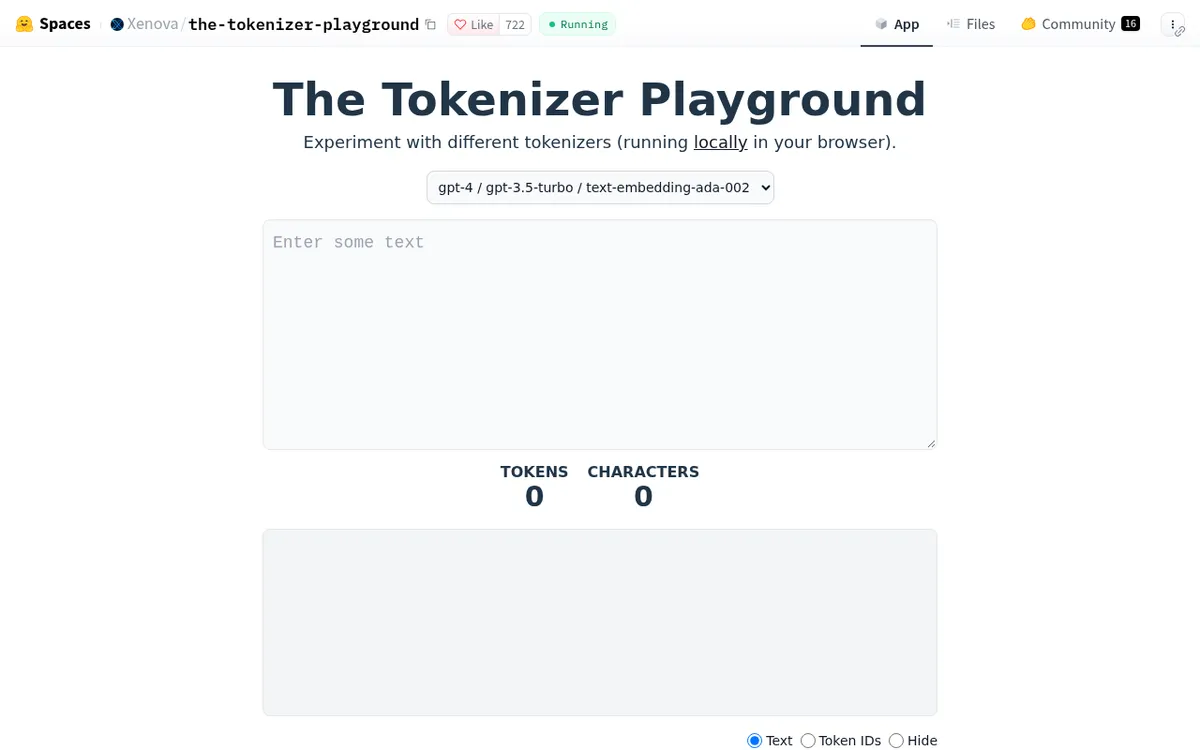
Mình dán một đoạn văn tiếng Việt dài 280 ký tự, giải thích chính khái niệm token. Trang báo 118 token và tô màu từng token. Các bạn để ý: nhiều chữ bị cắt làm hai, ba token ("nhỏ" và "viết" mỗi chữ 2 token, "sẽ" tới 3 token), và có chỗ hiện ký tự lỗi như "s��" ở chữ "sẽ". Lý do là chữ "ẽ" chiếm 3 byte trong UTF-8, và tokenizer này cắt ngay giữa các byte của một ký tự.
Bước 3: So với cùng nội dung bằng tiếng Anh
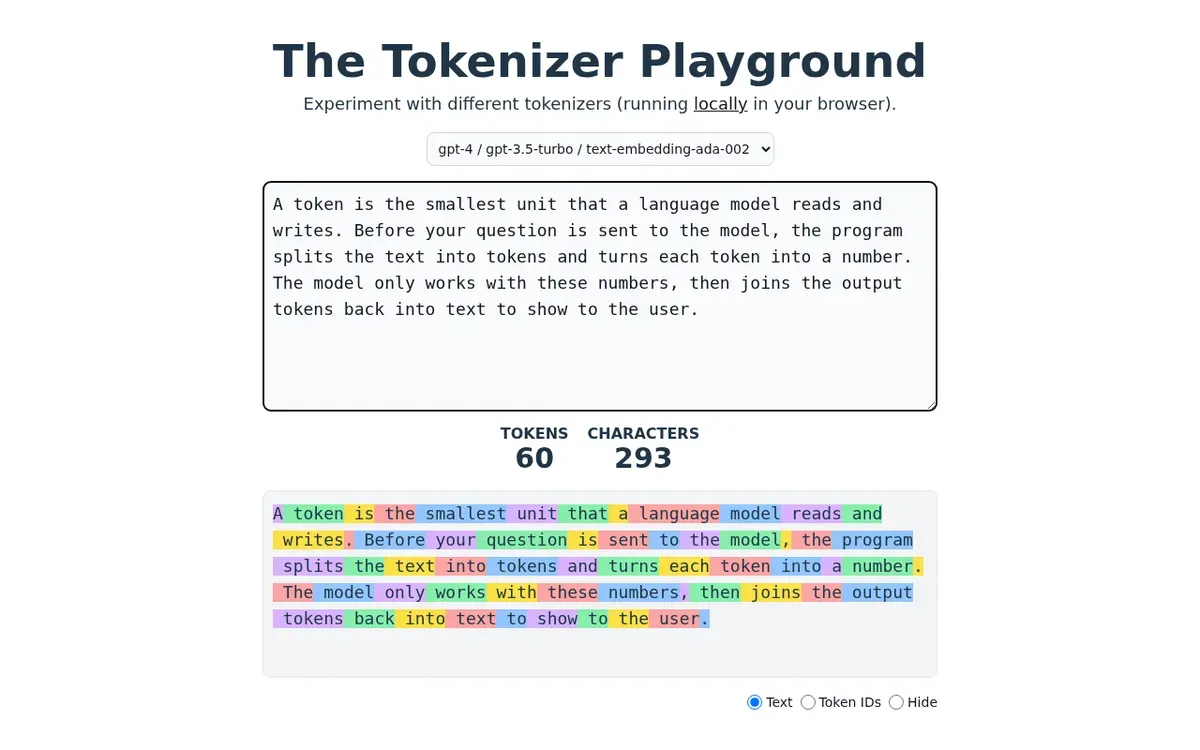
Giờ mình dán bản dịch tiếng Anh của đúng đoạn đó, dài 293 ký tự, tức là còn dài hơn bản tiếng Việt. Kết quả chỉ 60 token, gần như mỗi từ một token. Với tokenizer này, cùng một ý mà tiếng Việt tốn gần gấp đôi.
Bước 4: Xem token ID
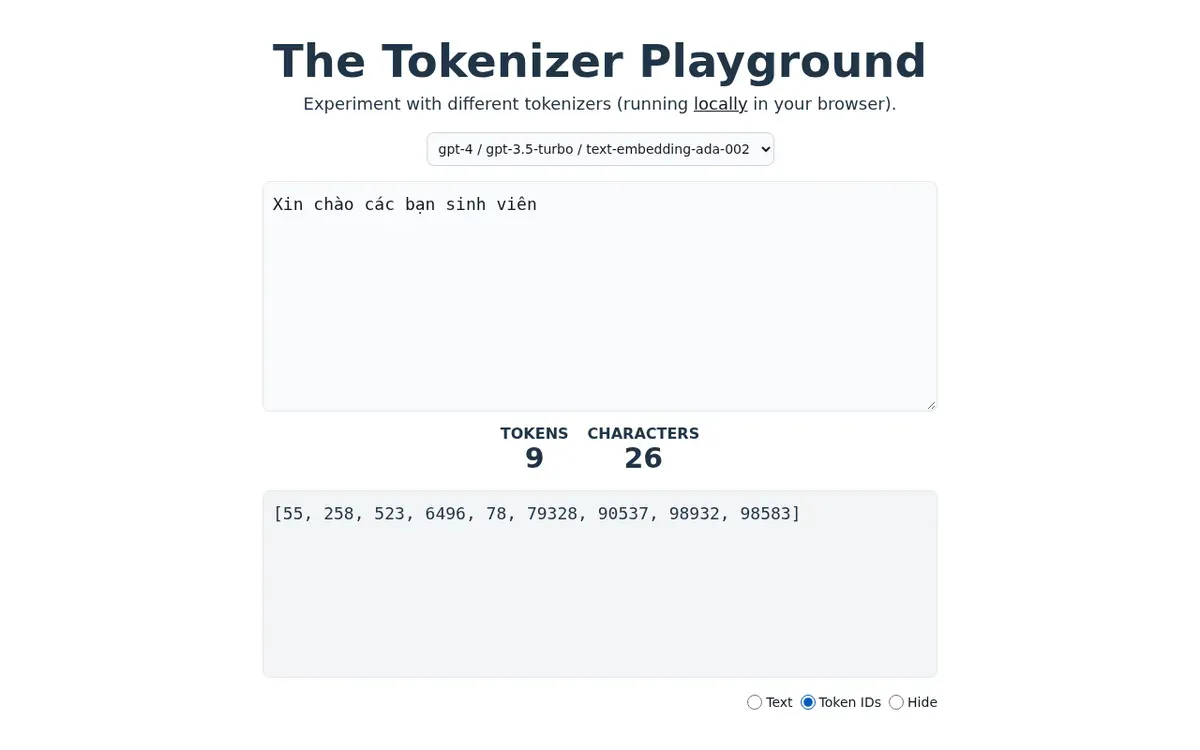
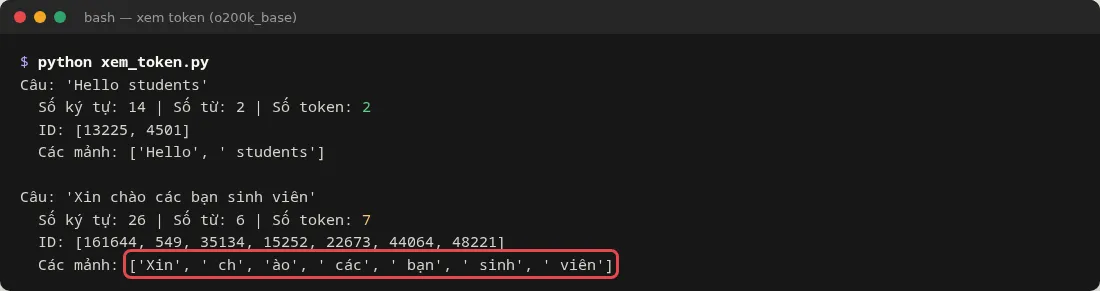
Chọn Token IDs ở góc dưới bên phải để xem dãy số model thật sự nhận. Câu "Xin chào các bạn sinh viên" (6 từ) thành 9 con số.
Bước 5: Cài tiktoken và transformers
Muốn đếm hàng loạt hoặc đưa vào chương trình thì dùng Python. tiktoken là thư viện tokenizer của OpenAI, transformers tải tokenizer của model mã nguồn mở trên Hugging Face. Không cần PyTorch.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install tiktoken transformers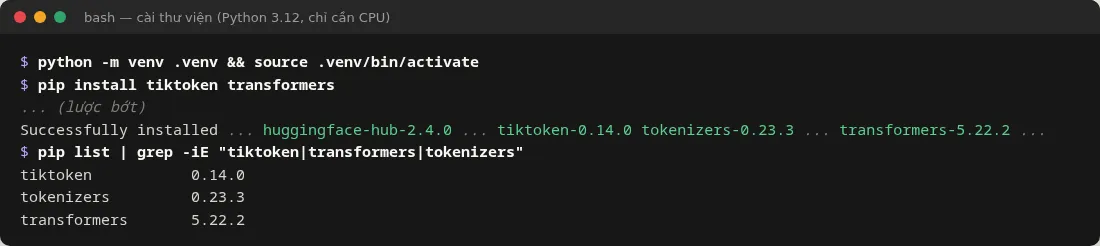
Bước 6: Đếm token bằng Python
File xem_token.py dùng bộ mã hóa o200k_base. Theo bảng ánh xạ trong tiktoken 0.14.0, GPT-4o và GPT-5 đều dùng bộ này (GPT-4 dùng cl100k_base như ở trang web).
import tiktoken

enc = tiktoken.get_encoding("o200k_base")

for cau in ["Hello students", "Xin chào các bạn sinh viên"]:
    ids = enc.encode(cau)
    print(f"Câu: {cau!r}")
    print(f"  Số ký tự: {len(cau)} | Số từ: {len(cau.split())} | Số token: {len(ids)}")
    print(f"  ID: {ids}")
    manh = [enc.decode_single_token_bytes(i).decode("utf-8", errors="replace") for i in ids]
    print(f"  Các mảnh: {manh}")
Với tokenizer mới, câu tiếng Việt còn 7 token thay vì 9, chỉ "chào" bị tách đôi.
Bước 7: So sánh ba tokenizer và thử bỏ dấu
File so_sanh.py đếm cùng một đoạn văn bằng ba tokenizer: cl100k_base, o200k_base và tokenizer của model mở Qwen/Qwen3.5-0.8B. Mình thử thêm bản tiếng Việt không dấu, vì nhiều bạn nghĩ bỏ dấu sẽ tiết kiệm token.
import unicodedata
import tiktoken
from transformers import AutoTokenizer

def bo_dau(s):
    s = s.replace("đ", "d").replace("Đ", "D")
    return "".join(c for c in unicodedata.normalize("NFD", s) if not unicodedata.combining(c))

qwen = AutoTokenizer.from_pretrained("Qwen/Qwen3.5-0.8B")   # chỉ tải file tokenizer
o200 = tiktoken.get_encoding("o200k_base")
print(len(o200.encode(VI)), len(qwen.encode(VI)))           # VI là đoạn văn tiếng Việt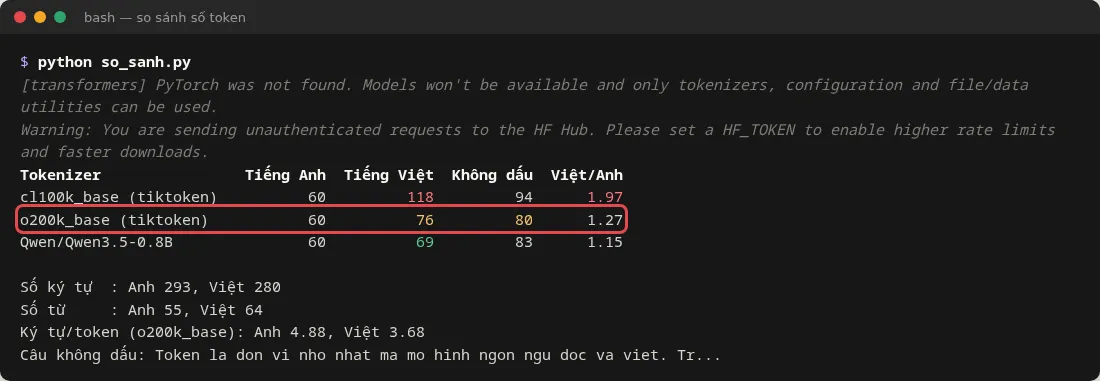
Kết quả này đáng nhớ:
- Tiếng Anh ra 60 token với cả ba. Tiếng Việt chênh nhiều: 118 (cl100k_base, khớp với trang web ở Bước 2), 76 (o200k_base), 69 (Qwen3.5).
- Tokenizer mới đỡ thiệt cho tiếng Việt hơn. Với o200k_base, một token tiếng Việt trung bình 3,68 ký tự, tiếng Anh 4,88.
- Bỏ dấu không tiết kiệm token với tokenizer mới: o200k_base tăng từ 76 lên 80, Qwen3.5 từ 69 lên 83. Chỉ cl100k_base giảm (118 xuống 94). Bỏ dấu còn làm câu mơ hồ.
Bước 8: Context window và những token các bạn không thấy
Context window là số token tối đa model xử lý được trong một lần, gồm cả câu hỏi, lịch sử trò chuyện và câu trả lời. File context_window.py đọc giới hạn này từ config.json của Qwen3.5-0.8B, xem prompt thật sự gửi vào model, rồi thử cắt văn bản ở 20 token.
from transformers import AutoConfig, AutoTokenizer

cfg = AutoConfig.from_pretrained("Qwen/Qwen3.5-0.8B")
print(getattr(cfg, "text_config", cfg).max_position_embeddings)

tok = AutoTokenizer.from_pretrained("Qwen/Qwen3.5-0.8B")
messages = [{"role": "system", "content": "Bạn là trợ giảng môn Android."},
            {"role": "user", "content": "Xin chào"}]
prompt = tok.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
print(len(tok.encode(prompt)))

ids = tok(VI, truncation=True, max_length=20)["input_ids"]
print(tok.decode(ids))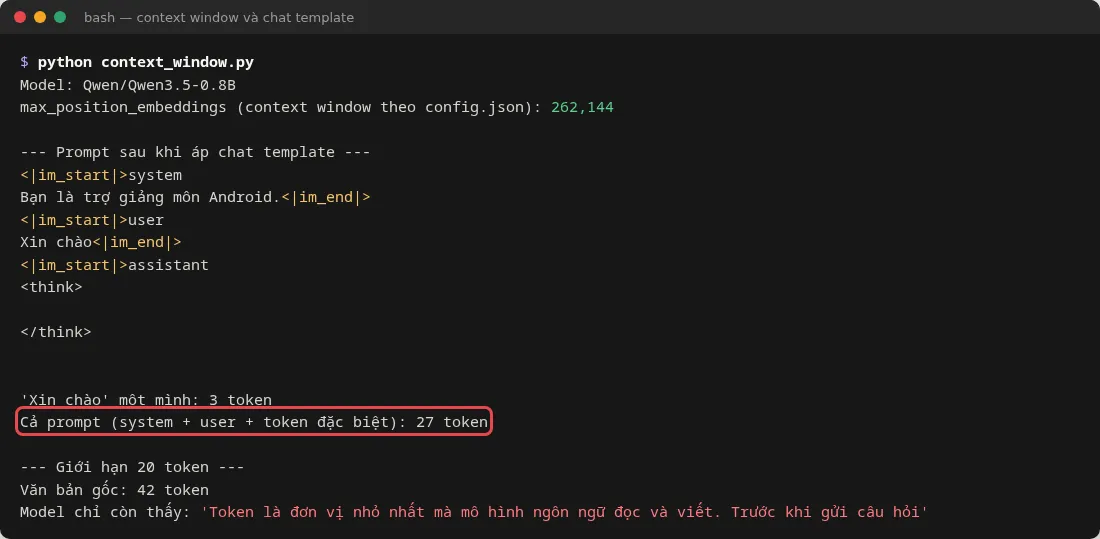
Ba điều rút ra từ kết quả:
- Theo config.json, Qwen3.5-0.8B có context window 262.144 token.
- Gõ "Xin chào" (3 token) nhưng model nhận 27 token, vì có thêm system prompt và token đặc biệt như
<|im_start|>. Ứng dụng chat còn gửi lại lịch sử mỗi lượt, nên trò chuyện càng dài càng tốn token. - Khi bị cắt bớt, phần thừa biến mất hoàn toàn: model chỉ thấy đến "... Trước khi gửi câu hỏi".
Bước 9: Đối chiếu với tài liệu chính thức
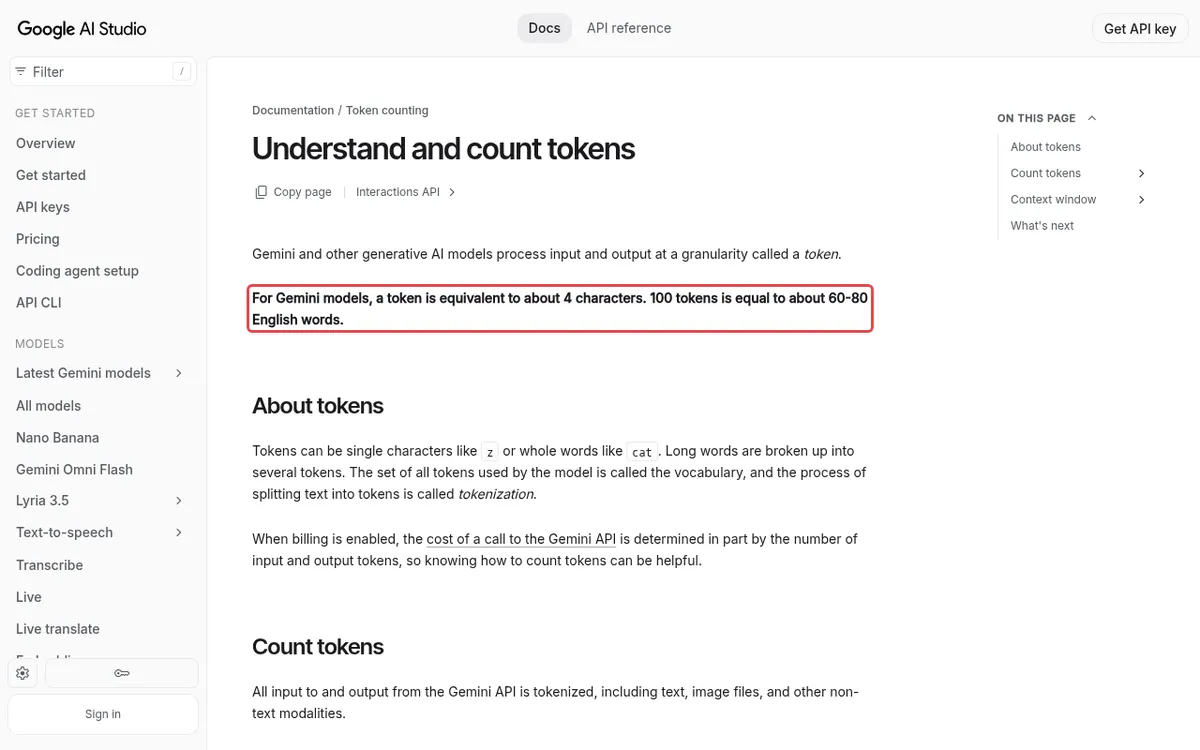
Tài liệu Gemini API ghi: với model Gemini, một token khoảng 4 ký tự, 100 token khoảng 60–80 từ tiếng Anh. Bước 7 cho thấy tiếng Việt cần nhiều token hơn cho cùng số ký tự.
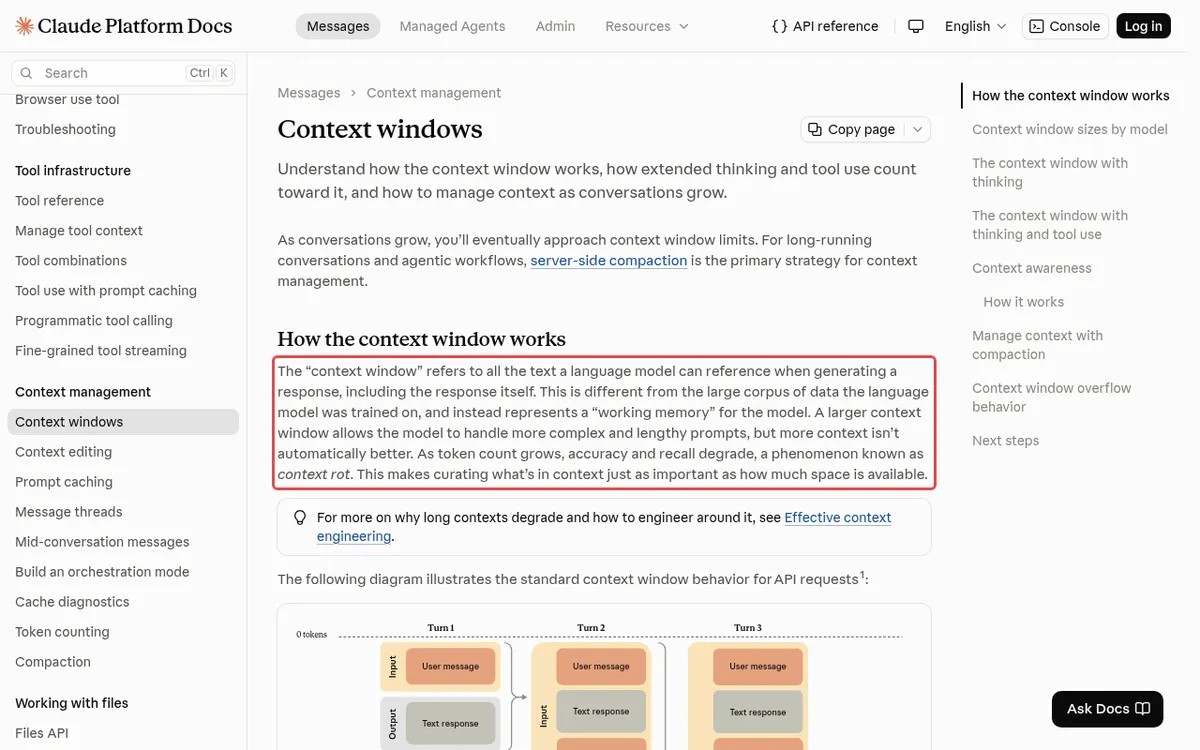
Trang "Context windows" của Claude định nghĩa context window là toàn bộ văn bản model tham chiếu được khi sinh câu trả lời, kể cả chính câu trả lời, như một "bộ nhớ làm việc". Context dài hơn không tự động tốt hơn: token càng nhiều thì độ chính xác càng giảm (context rot). Theo trang này ngày 13/11/2026, nhiều model Claude hiện có context window 1 triệu token, một số model cũ là 200 nghìn. Đầu vào vượt giới hạn thì API trả lỗi 400 "prompt is too long".
Lỗi thường gặp
Văn bản tiếng Việt "nhìn giống nhau" nhưng tốn gấp đôi token
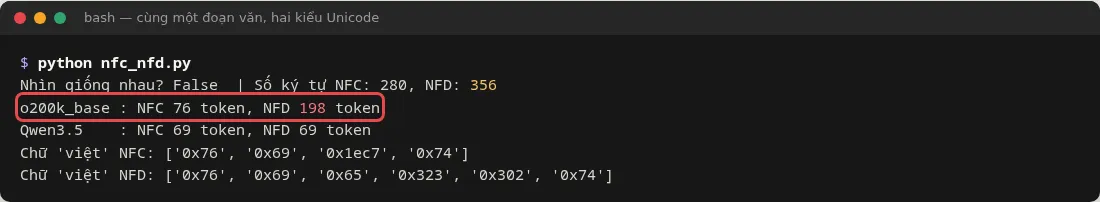
Chữ tiếng Việt có hai cách mã hóa Unicode: dựng sẵn (NFC, "ệ" là một ký tự) và tổ hợp (NFD, "ệ" là chữ "e" cộng hai dấu). Văn bản copy từ một số nguồn có thể ở dạng NFD. Cùng đoạn văn, o200k_base đếm 76 token với NFC nhưng 198 token với NFD. Tokenizer Qwen tự chuẩn hóa nên vẫn là 69. Cách sửa: unicodedata.normalize("NFC", text) trước khi gửi.
KeyError khi dùng tiktoken cho Claude hoặc Gemini
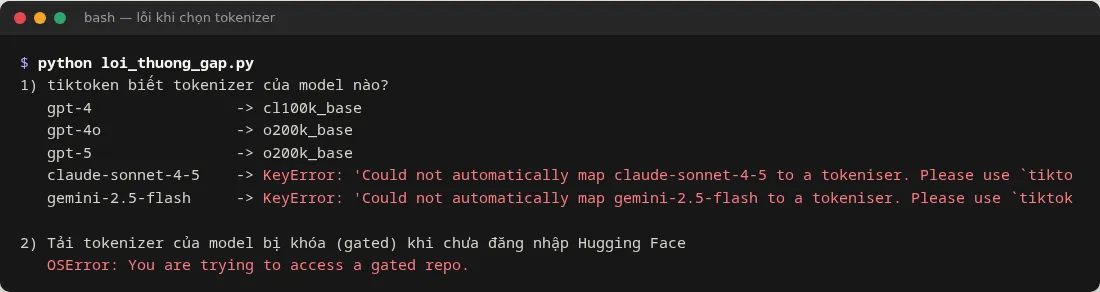
tiktoken.encoding_for_model() chỉ biết model của OpenAI, với claude-sonnet-4-5 hay gemini-2.5-flash nó báo KeyError. Muốn số chính xác cho Claude hay Gemini thì dùng API đếm token của từng hãng (cần API key). Muốn ước lượng nhanh thì dùng o200k_base, nhưng đó chỉ là con số gần đúng. Ô "Claude" trong Playground là tokenizer đăng từ năm 2024, chưa chắc khớp với model Claude hiện tại.
Lỗi thứ hai trong ảnh: model bị khóa (gated) như meta-llama/Llama-3.2-1B thì chưa đăng nhập và được duyệt quyền sẽ không tải được cả file tokenizer. Hãy chọn model không khóa như Qwen.
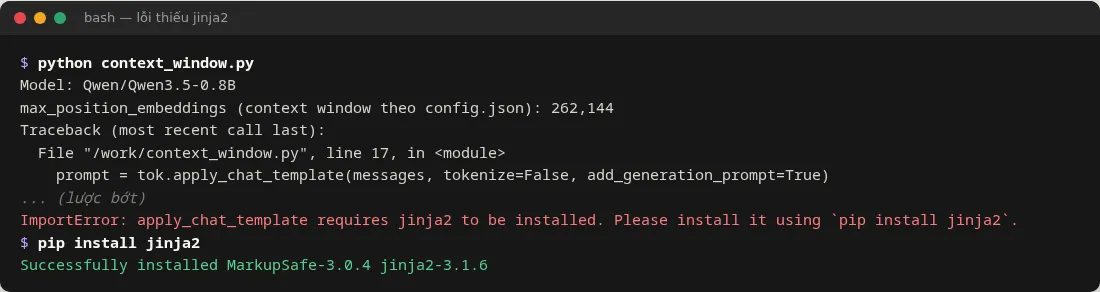
ImportError: apply_chat_template requires jinja2
Mình gặp lỗi này thật ở Bước 8: cài transformers không kèm jinja2, thư viện dựng chat template. Chạy pip install jinja2 là xong.
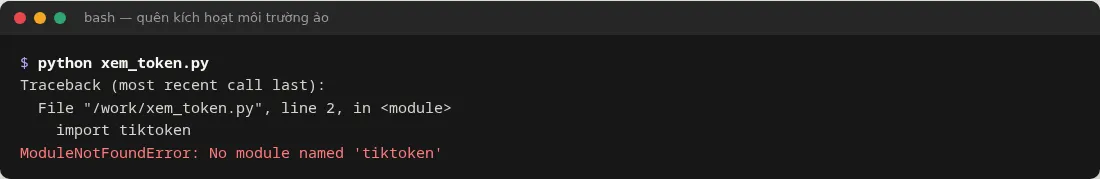
ModuleNotFoundError: No module named 'tiktoken'
Đã cài rồi mà vẫn báo thiếu thư viện thì gần như chắc chắn các bạn đang chạy Python ngoài môi trường ảo. Mở terminal mới thì phải chạy lại source .venv/bin/activate (Windows: .venv\Scripts\activate), thấy chữ (.venv) ở đầu dòng rồi mới chạy script.
Câu hỏi thường gặp
1 token bằng bao nhiêu chữ tiếng Việt?
Không có con số cố định, vì phụ thuộc tokenizer. Trong thử nghiệm của mình, đoạn văn 64 từ tiếng Việt ra 76 token với o200k_base (khoảng 1,2 token mỗi từ), 69 token với Qwen3.5 và 118 token với cl100k_base. Muốn biết chính xác cho văn bản của mình thì đếm bằng tokenizer của đúng model đó.
Có nên viết prompt bằng tiếng Anh cho đỡ tốn token?
Với tokenizer mới, chênh lệch chỉ còn khoảng 15–30% trong thử nghiệm này, không đáng nếu tiếng Anh làm các bạn diễn đạt kém đi. Nên làm hơn: viết tiếng Việt có dấu chuẩn NFC, bỏ phần thừa trong prompt, mở cuộc trò chuyện mới khi đổi chủ đề.
Context window lớn thì cứ dán cả tài liệu vào là được?
Tài liệu của Claude nói rõ context dài hơn không tự động tốt hơn, độ chính xác giảm khi số token tăng. Với tài liệu dài, cách tốt hơn là chỉ đưa phần liên quan vào, đó chính là ý tưởng của RAG.
Đếm token trên trang web có giống trong Python không?
Giống, nếu chọn cùng tokenizer. Trang Playground với ô "gpt-4" cho 118 và 60 token, đúng bằng kết quả cl100k_base trong Python ở Bước 7.
Nguồn tham khảo
- The Tokenizer Playground (Hugging Face Spaces)
- tiktoken trên GitHub và trên PyPI
- Transformers – Tokenizer và Chat templates
- Model card Qwen/Qwen3.5-0.8B
- Gemini API – Understand and count tokens
- Claude Docs – Context windows và Token counting
- Python – unicodedata (NFC, NFD)
Ảnh chụp và thử nghiệm ngày 13/11/2026.