RAG là gì? Tự làm chatbot hỏi đáp tài liệu bằng Python (2026)
Trong bài này
- RAG là gì?
- Cần chuẩn bị
- Bước 1: Cài thư viện
- Bước 2: Chuẩn bị tài liệu và thử hỏi khi chưa có RAG
- Bước 3: Chọn model embedding hỗ trợ tiếng Việt
- Bước 4: Cắt tài liệu và lưu vào ChromaDB
- Bước 5: Tìm đoạn liên quan nhất (chữ R)
- Bước 6: Ghép tài liệu vào prompt và hỏi lại (chữ A và G)
- Lỗi thường gặp
- RuntimeError: operator torchvision::nms does not exist
- Dùng embedding mặc định của ChromaDB cho tiếng Việt
- Tìm đúng đoạn nhưng model nhỏ vẫn trả lời sai
- Hỏi điều tài liệu không có
- Câu hỏi thường gặp
- RAG khác fine-tune như thế nào?
- Có cần GPU hay API key không?
- Dùng tài liệu PDF hoặc Word được không?
- Vì sao phải thêm "query: " và "passage: "?
- Học tiếp gì sau bài này?
- Nguồn tham khảo
Các bạn hỏi ChatGPT hay một model AI về quy định của môn học mình đang học, nó vẫn trả lời rất tự tin, nhưng thường là đoán. Lý do là model chưa bao giờ đọc tài liệu của lớp các bạn. RAG là cách giải quyết chuyện này: trước khi trả lời, chương trình tìm đúng đoạn tài liệu liên quan rồi đưa cho model đọc. Trong bài này, mình giải thích RAG là gì, rồi cùng các bạn tự làm một chatbot nhỏ bằng Python để hỏi đáp một sổ tay môn học tiếng Việt.
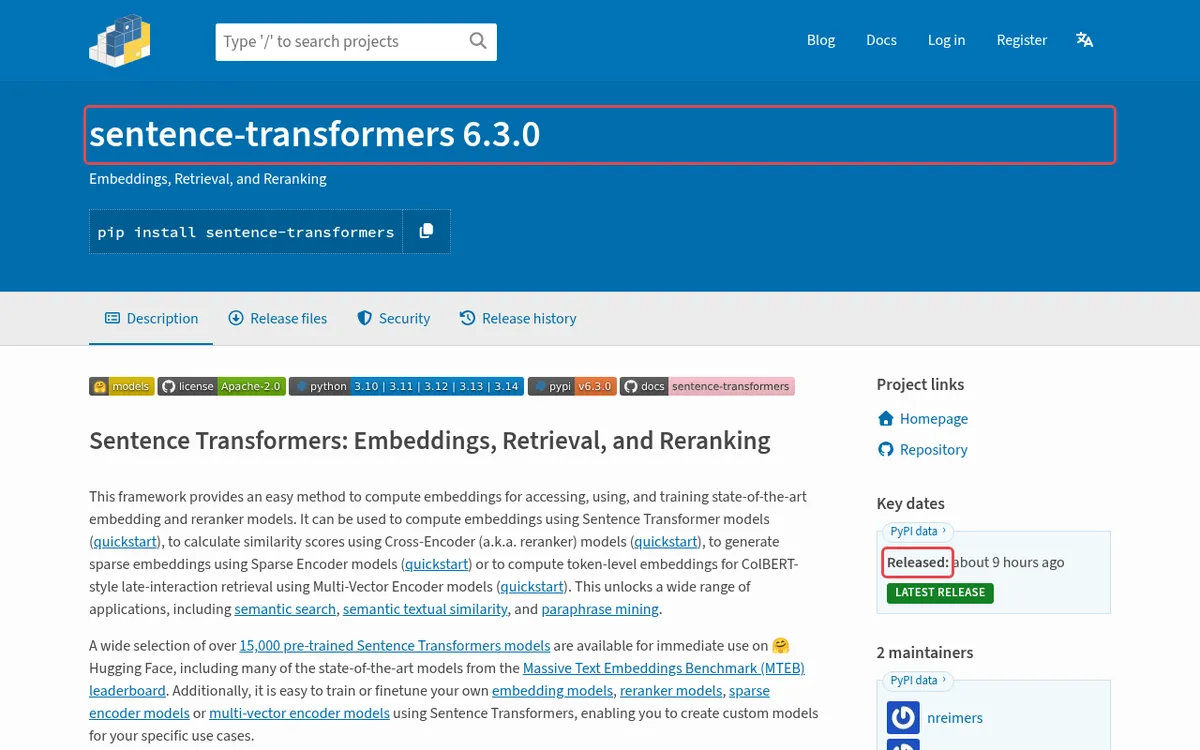
Mọi lệnh và kết quả trong bài mình chạy thật ngày 12/11/2026 trên CPU 4 nhân, không GPU, không tài khoản, không API key. Phiên bản dùng: Python 3.12, sentence-transformers 6.3.0 (phát hành 11/11/2026), chromadb 1.5.9, transformers 5.22.2 và PyTorch 2.15 bản CPU. Làm theo hết bài mất khoảng 30–45 phút, phần lớn là thời gian tải thư viện và model.
RAG là gì?
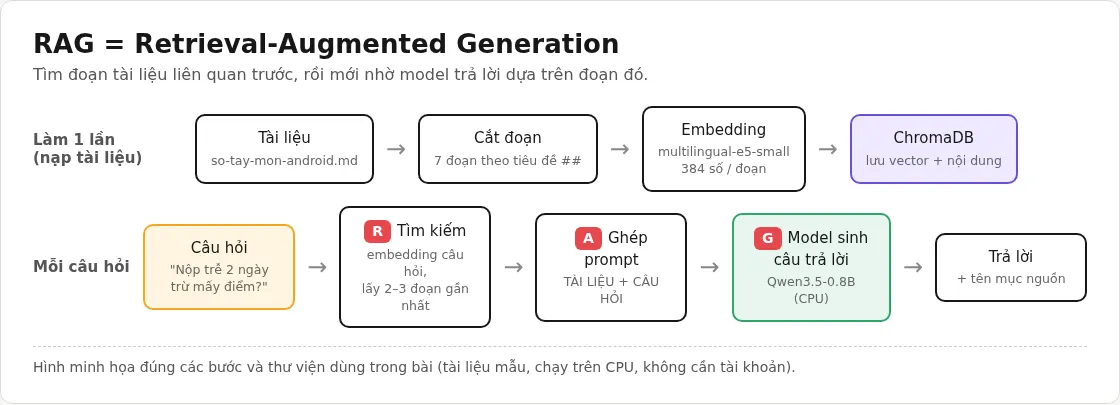
RAG viết tắt của Retrieval-Augmented Generation, tạm dịch là "sinh câu trả lời có bổ sung phần tìm kiếm". Tên gọi đã nói đủ ba bước:
- R – Retrieval (tìm kiếm): từ câu hỏi, tìm ra vài đoạn tài liệu liên quan nhất.
- A – Augmented (bổ sung): ghép các đoạn đó vào prompt, kèm câu hỏi.
- G – Generation (sinh): model ngôn ngữ đọc prompt và viết câu trả lời.
Để tìm "đoạn liên quan" theo nghĩa chứ không chỉ theo từ khóa, người ta dùng embedding: một model nhỏ biến mỗi câu thành một dãy số (vector). Hai câu có nghĩa gần nhau thì hai vector cũng gần nhau. Các vector được lưu trong một vector database, ở bài này là ChromaDB. Hình dưới là toàn bộ luồng mình sẽ làm.
Cần chuẩn bị
- Máy Windows, macOS hoặc Linux, RAM từ 8 GB trở lên. Không cần GPU.
- Python 3.11 trở lên (
transformers5.x yêu cầu Python >= 3.11). - Khoảng 5 GB ổ cứng trống. Môi trường ảo của mình sau khi cài nặng 1,8 GB, phần còn lại là model.
- Biết chạy lệnh trong terminal và đọc code Python cơ bản. Nếu chưa quen Hugging Face, các bạn đọc trước bài Hugging Face là gì.
Bước 1: Cài thư viện
Thư viện chính để tạo embedding là sentence-transformers. Bản 6.3.0 vừa lên PyPI ngày 11/11/2026, chủ yếu thêm tính năng huấn luyện mới, cách dùng cơ bản trong bài không đổi.
Tạo môi trường ảo, cài PyTorch bản CPU cùng lúc với torchvision từ trang tải của PyTorch, rồi mới cài các thư viện còn lại. Trên Windows thì lệnh kích hoạt là .venv\Scripts\activate.
python -m venv .venv
source .venv/bin/activate
pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
pip install sentence-transformers chromadb transformers accelerate pillow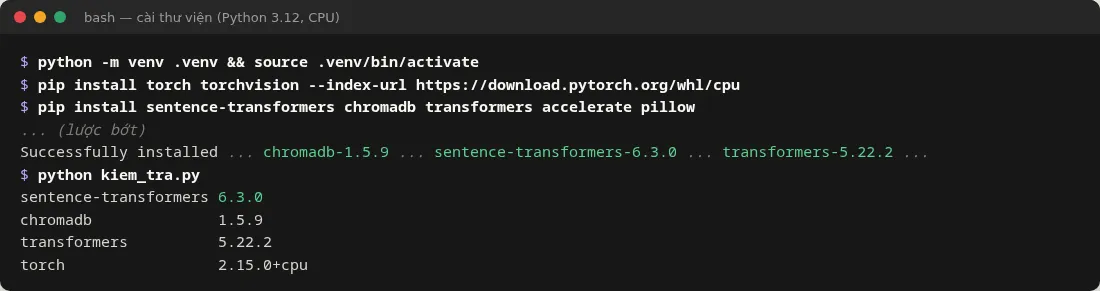
Bước 2: Chuẩn bị tài liệu và thử hỏi khi chưa có RAG
Mình viết một file tai_lieu/so-tay-mon-android.md gồm 7 mục: thông tin chung, cách tính điểm, hạn nộp assignment, điểm danh, quy định dùng AI, phần mềm và phúc khảo. Đây là tài liệu mẫu, các con số do mình đặt ra để thử nghiệm, không phải quy chế của trường nào. Các bạn có thể thay bằng đề cương môn của mình.
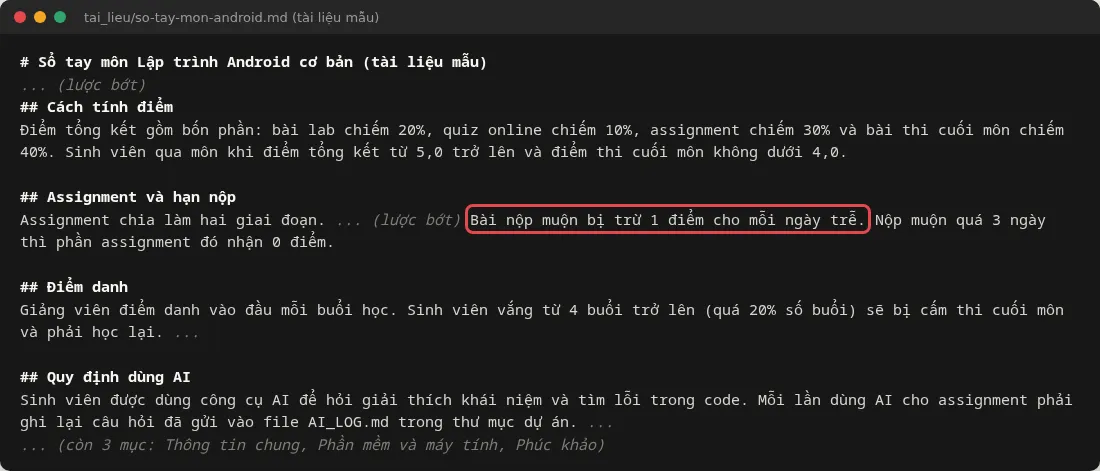
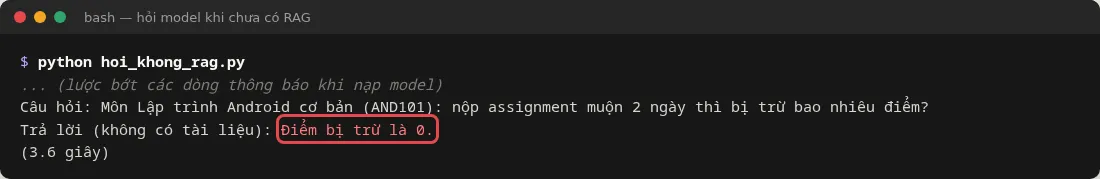
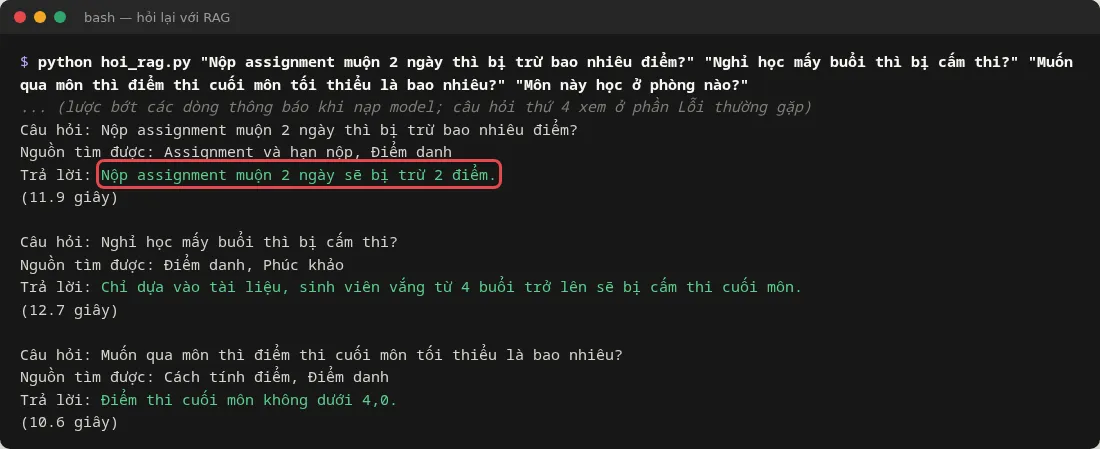
Trước khi làm RAG, mình hỏi thẳng model Qwen3.5-0.8B: "nộp assignment muộn 2 ngày thì bị trừ bao nhiêu điểm?". Model trả lời "Điểm bị trừ là 0." Theo tài liệu thì đúng phải là 2 điểm. Model không biết tài liệu này nên đoán, và đoán sai.
Bước 3: Chọn model embedding hỗ trợ tiếng Việt
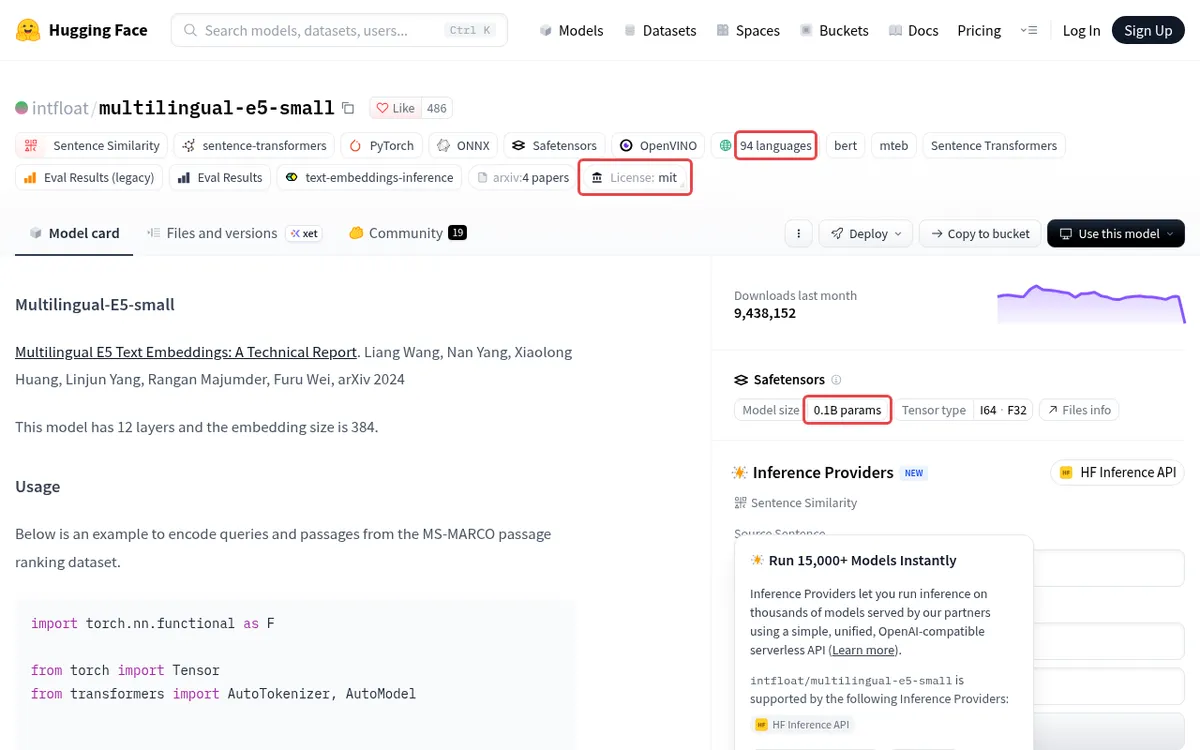
Mình chọn intfloat/multilingual-e5-small trên Hugging Face: khoảng 0,1 tỉ tham số nên chạy nhanh trên CPU, hỗ trợ 94 ngôn ngữ (danh sách có vi), giấy phép MIT. Model card ghi rõ một điểm dễ quên: câu hỏi phải bắt đầu bằng query: và đoạn tài liệu phải bắt đầu bằng passage: .
Thử nhanh với một câu hỏi và ba câu ngắn:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("intfloat/multilingual-e5-small")
vec_hoi = model.encode("query: nộp bài trễ hạn thì sao?", normalize_embeddings=True)
vec_doan = model.encode([
    "passage: Bài nộp muộn bị trừ 1 điểm cho mỗi ngày trễ.",
    "passage: Sinh viên vắng từ 4 buổi trở lên sẽ bị cấm thi.",
    "passage: Máy tính nên có tối thiểu 8 GB RAM.",
], normalize_embeddings=True)
print(model.similarity(vec_hoi, vec_doan))
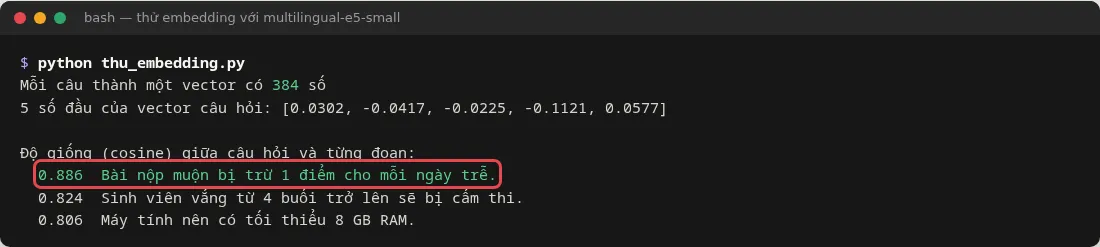
Mỗi câu thành một vector 384 số. Câu "nộp muộn bị trừ 1 điểm" giống câu hỏi nhất (0,886), dù câu hỏi dùng chữ "trễ hạn" chứ không phải "muộn". Đó là tìm theo nghĩa. Các bạn để ý điểm của e5 thường dồn vào khoảng 0,8–0,9, nên hãy so thứ tự chứ đừng nhìn con số tuyệt đối.
Bước 4: Cắt tài liệu và lưu vào ChromaDB
Tài liệu được cắt theo tiêu đề ##, mỗi mục là một đoạn. Mình tự tính embedding rồi đưa vào ChromaDB bằng PersistentClient, để dữ liệu nằm trong thư mục chroma_db và lần sau không phải tính lại.
import chromadb
from sentence_transformers import SentenceTransformer

text = open("tai_lieu/so-tay-mon-android.md", encoding="utf-8").read()
doan = []
for phan in text.split("\n## ")[1:]:
    tieu_de, _, noi_dung = phan.partition("\n")
    doan.append({"tieu_de": tieu_de.strip(), "noi_dung": noi_dung.strip()})

model = SentenceTransformer("intfloat/multilingual-e5-small")
vectors = model.encode(
    [f"passage: {d['tieu_de']}. {d['noi_dung']}" for d in doan], normalize_embeddings=True
)

client = chromadb.PersistentClient(path="chroma_db")
col = client.get_or_create_collection("so_tay_android", metadata={"hnsw:space": "cosine"})
col.upsert(
    ids=[f"doan-{i}" for i in range(len(doan))],
    embeddings=vectors.tolist(),
    documents=[d["noi_dung"] for d in doan],
    metadatas=[{"tieu_de": d["tieu_de"]} for d in doan],
)
print("Số đoạn trong collection:", col.count())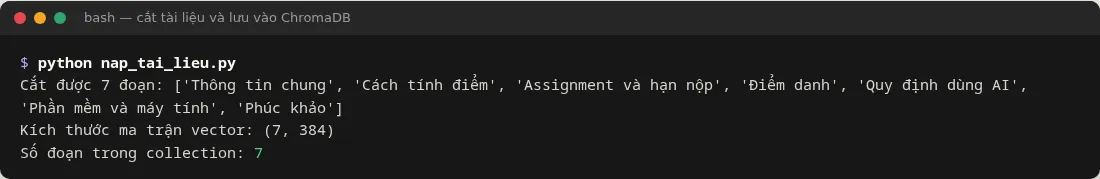
Bước 5: Tìm đoạn liên quan nhất (chữ R)
Khi có câu hỏi, mình tạo embedding cho câu hỏi (nhớ tiền tố query: ) rồi gọi col.query với query_embeddings. ChromaDB trả về các đoạn có khoảng cách nhỏ nhất. Khoảng cách cosine càng nhỏ thì càng giống.
vec = model.encode(f"query: {cau_hoi}", normalize_embeddings=True)
kq = col.query(query_embeddings=[vec.tolist()], n_results=3)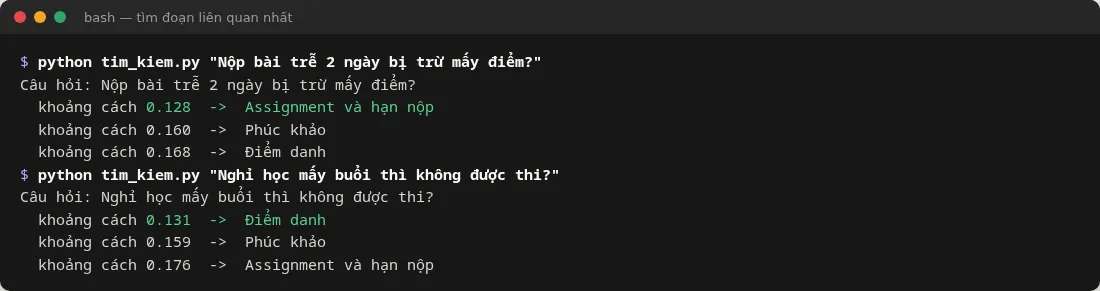
Bước 6: Ghép tài liệu vào prompt và hỏi lại (chữ A và G)
Bước cuối ghép các đoạn tìm được vào prompt, yêu cầu model chỉ dựa vào tài liệu, rồi gọi Qwen3.5-0.8B. Phần chính của hoi_rag.py:
prompt = (
    "Chỉ dựa vào TÀI LIỆU bên dưới để trả lời câu hỏi, ngắn gọn, bằng tiếng Việt. "
    "Nếu tài liệu không có thông tin thì trả lời: Tài liệu không nói về việc này.\n\n"
    f"TÀI LIỆU:\n{ngu_canh}\n\nCÂU HỎI: {cau_hoi}"
)
messages = [{"role": "user", "content": [{"type": "text", "text": prompt}]}]
inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt"
).to(llm.device)
out = llm.generate(**inputs, max_new_tokens=120, do_sample=False)
Lần này cả ba câu đều đúng với tài liệu: nộp muộn 2 ngày bị trừ 2 điểm, vắng từ 4 buổi bị cấm thi, điểm thi cuối môn không dưới 4,0. Mỗi câu mất khoảng 11–13 giây trên CPU 4 nhân. Mình cho script in kèm tên mục nguồn, để người đọc tự mở tài liệu ra kiểm tra.
Lỗi thường gặp
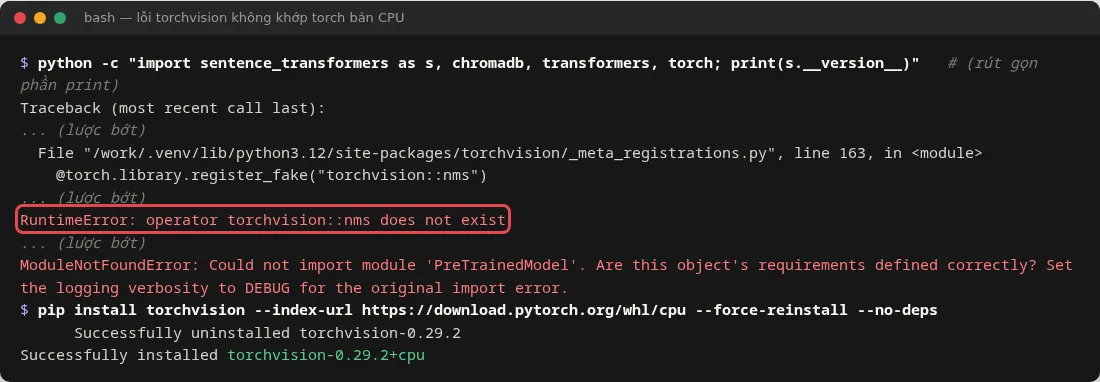
RuntimeError: operator torchvision::nms does not exist
Mình gặp lỗi này ở lần cài đầu: cài PyTorch bản CPU trước, sau đó pip install lấy torchvision từ PyPI, hai bản không khớp nhau. Lỗi hiện ra khi import sentence_transformers hoặc transformers. Cách sửa là cài lại torchvision từ đúng trang CPU của PyTorch, hoặc cài torch và torchvision trong cùng một lệnh như ở bước 1.
Dùng embedding mặc định của ChromaDB cho tiếng Việt
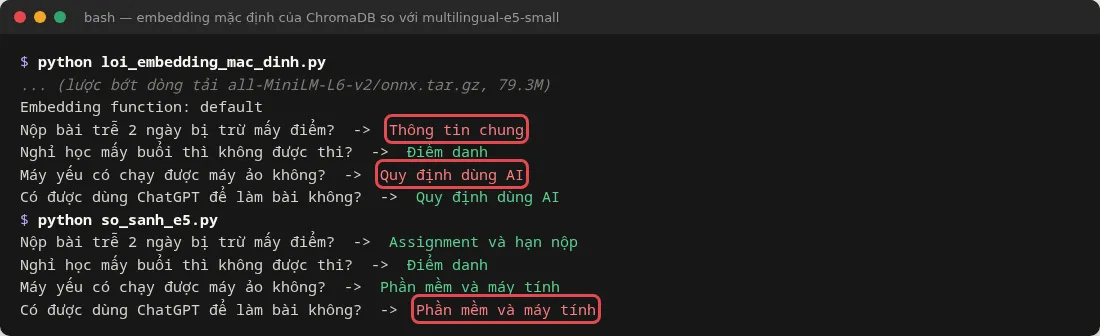
Nếu không truyền embedding, ChromaDB tự tải model all-MiniLM-L6-v2 (file onnx khoảng 79 MB). Mình thử 4 câu hỏi: model mặc định tìm sai 2 câu, ví dụ hỏi "nộp bài trễ" lại ra mục "Thông tin chung". Với multilingual-e5-small, 3/4 câu đúng ở vị trí đầu. Câu còn lại ("dùng ChatGPT") e5 xếp mục "Quy định dùng AI" ở vị trí thứ hai. Vì vậy các bạn nên chọn model embedding có hỗ trợ tiếng Việt và lấy 2–3 đoạn chứ đừng chỉ lấy 1.
Tìm đúng đoạn nhưng model nhỏ vẫn trả lời sai
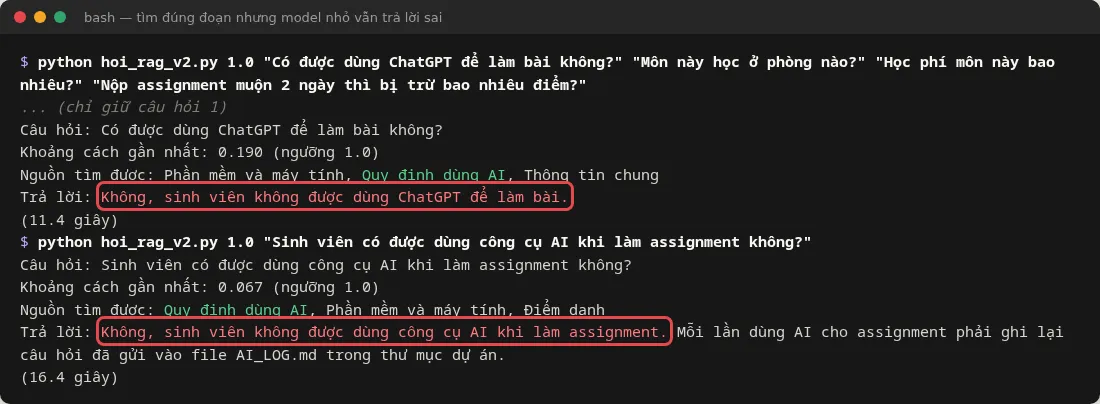
Đây là lỗi quan trọng nhất. Mình hỏi "có được dùng ChatGPT để làm bài không?", mục "Quy định dùng AI" đã nằm trong các đoạn tìm được, nhưng Qwen3.5-0.8B vẫn trả lời "Không". Đổi câu hỏi cho sát chữ trong tài liệu ("công cụ AI") thì model vẫn nói "Không", rồi câu sau lại nhắc quy định ghi AI_LOG.md, tự mâu thuẫn. Tài liệu thật ra cho phép dùng AI nếu ghi lại câu hỏi. Model dưới 1 tỉ tham số đọc hiểu các câu có điều kiện còn kém. Muốn chạy thật thì nên dùng model lớn hơn, ví dụ chạy qua Ollama (mình chưa thử model lớn hơn trong bài này), và luôn hiển thị đoạn nguồn để người dùng kiểm tra.
Hỏi điều tài liệu không có
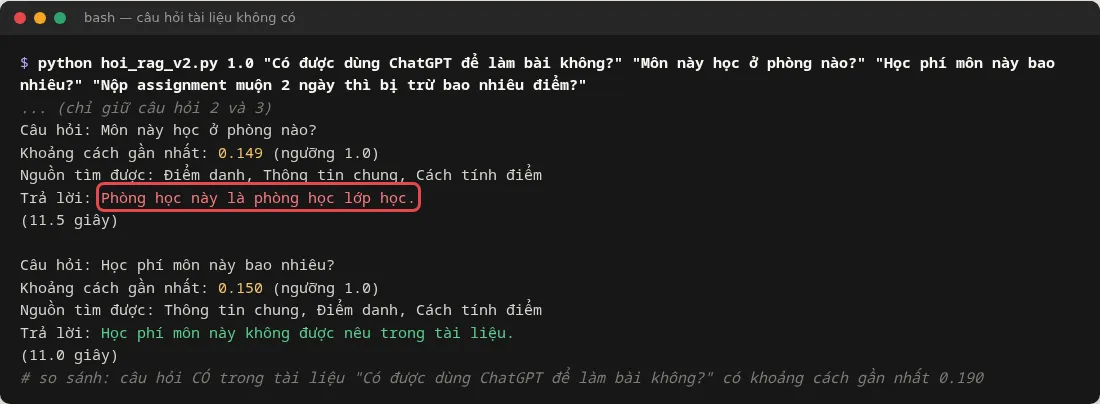
Với câu "học phí bao nhiêu", model trả lời đúng là tài liệu không nêu. Với câu "học ở phòng nào", model lại viết một câu vô nghĩa. Mình đã thử chặn bằng ngưỡng khoảng cách nhưng không được. Hai câu hỏi ngoài tài liệu có khoảng cách 0,149–0,150, còn câu "dùng ChatGPT" có trong tài liệu lại là 0,190. Với e5-small và tài liệu này, ngưỡng khoảng cách không tách được hai trường hợp. Cách an toàn hơn là in nguồn kèm câu trả lời và dặn người dùng kiểm tra lại.
Câu hỏi thường gặp
RAG khác fine-tune như thế nào?
Fine-tune là huấn luyện thêm để thay đổi trọng số của model, tốn thời gian và cần GPU. RAG không đụng vào model, chỉ đưa thêm tài liệu vào prompt mỗi lần hỏi. Khi tài liệu thay đổi, các bạn chỉ cần nạp lại vào ChromaDB.
Có cần GPU hay API key không?
Không. Toàn bộ bài này chạy trên CPU 4 nhân, không đăng nhập Hugging Face. Đổi lại là chậm: khoảng 11–13 giây cho mỗi câu trả lời với Qwen3.5-0.8B.
Dùng tài liệu PDF hoặc Word được không?
Được, nhưng phải chuyển sang văn bản thuần trước rồi mới cắt đoạn. Bài này mình chỉ thử với file Markdown. Với tài liệu dài, nên cắt đoạn vài trăm từ và giữ tiêu đề mục trong metadata như ở bước 4.
Vì sao phải thêm "query: " và "passage: "?
Model card của multilingual-e5 yêu cầu như vậy với bài toán tìm kiếm câu hỏi – đoạn văn, vì model được huấn luyện theo đúng định dạng đó. Model embedding khác có thể không cần, các bạn đọc model card của model mình chọn.
Học tiếp gì sau bài này?
Các bạn có thể bọc hàm tìm kiếm thành một tool cho AI agent bằng MCP server, hoặc thử model embedding và model sinh lớn hơn rồi so sánh kết quả với bộ câu hỏi trong bài.
Nguồn tham khảo
- sentence-transformers trên PyPI và ghi chú phát hành v6.3.0
- Tài liệu Sentence Transformers
- Model card intfloat/multilingual-e5-small
- ChromaDB – Getting Started
- Model card Qwen/Qwen3.5-0.8B
- PyTorch – Get Started (cài bản CPU)
- Lewis và cộng sự (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Ảnh chụp và thử nghiệm ngày 12/11/2026.