Function calling là gì? Cho model AI gọi hàm Python chạy trên CPU (2026)
Trong bài này
- Cần chuẩn bị
- Bước 1: Hiểu function calling là gì
- Bước 2: Nắm quy trình 4 bước (model không tự chạy hàm)
- Bước 3: Chọn model nhỏ chuyên gọi hàm: BotPsy-0.8B
- Bước 4: Cài môi trường Python
- Bước 5: Viết hàm Python làm "công cụ"
- Bước 6: Xem prompt mà model thật sự nhìn thấy
- Bước 7: Chạy model, đọc lời gọi hàm và gửi kết quả lại
- Bước 8: Thử câu hỏi có nhiều tham số và câu hỏi không cần công cụ
- Bước 9: Vòng lặp agent: gọi nhiều hàm rồi mới trả lời
- Lỗi thường gặp
- Hỏi bằng tiếng Việt, model truyền tham số sai
- Model thường không gọi hàm, chỉ xin lỗi
- Cảnh báo "falling back to its reference PyTorch implementation"
- Câu hỏi thường gặp
- Function calling khác MCP thế nào?
- Model có tự chạy code của mình không?
- Dùng ChatGPT, Gemini, Claude API thì có khác không?
- Có dùng BotPsy-0.8B cho đồ án được không?
- Máy không có GPU chạy có nổi không?
- Nguồn tham khảo
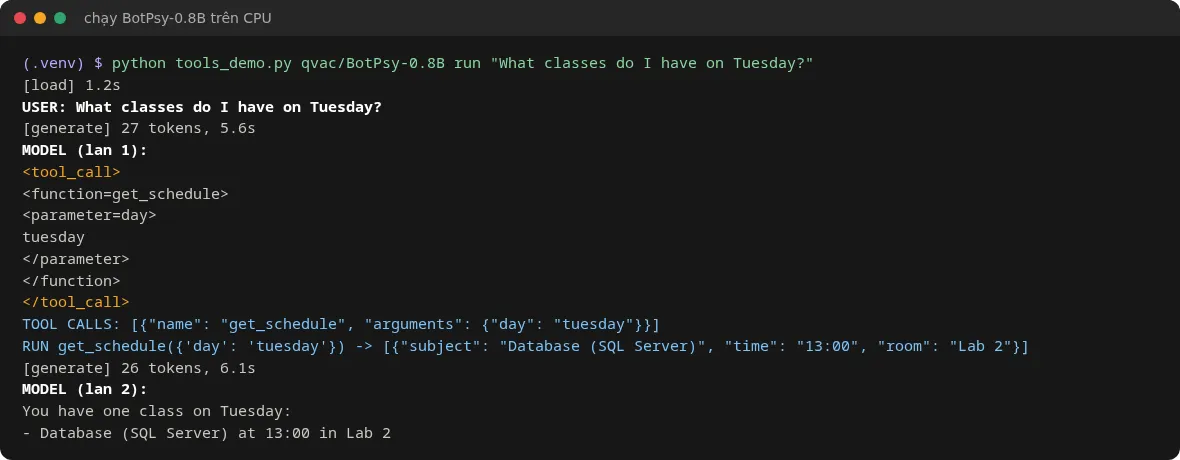
Khi các bạn thấy ChatGPT tra thời tiết, Claude Code sửa file hay Gemini đặt lịch họp, phía sau đều là một cơ chế gọi là function calling (còn gọi là tool calling, tool use). Trong bài này mình giải thích function calling là gì, rồi cùng các bạn tự làm một "trợ lý sinh viên" nhỏ: model AI đọc câu hỏi, tự quyết định gọi hàm Python nào, chương trình chạy hàm, rồi model trả lời dựa trên kết quả.
Toàn bộ chạy bằng CPU, không cần API key, không cần GPU, dùng model BotPsy-0.8B vừa được đăng lên Hugging Face ngày 10/11/2026. Làm theo mất khoảng 20–30 phút (phần lớn là thời gian tải 1,7 GB model). Bài áp dụng cho transformers 5.23 và PyTorch 2.15, thử nghiệm ngày 14/11/2026.
Cần chuẩn bị
- Máy có Python 3.10 trở lên (mình dùng 3.12), RAM trống khoảng 4 GB và 5 GB ổ cứng.
- Biết viết hàm Python cơ bản và biết JSON là gì.
- Nên đọc trước bài Token là gì trong AI và Hugging Face là gì nếu các bạn chưa từng chạy model bằng transformers.
Bước 1: Hiểu function calling là gì
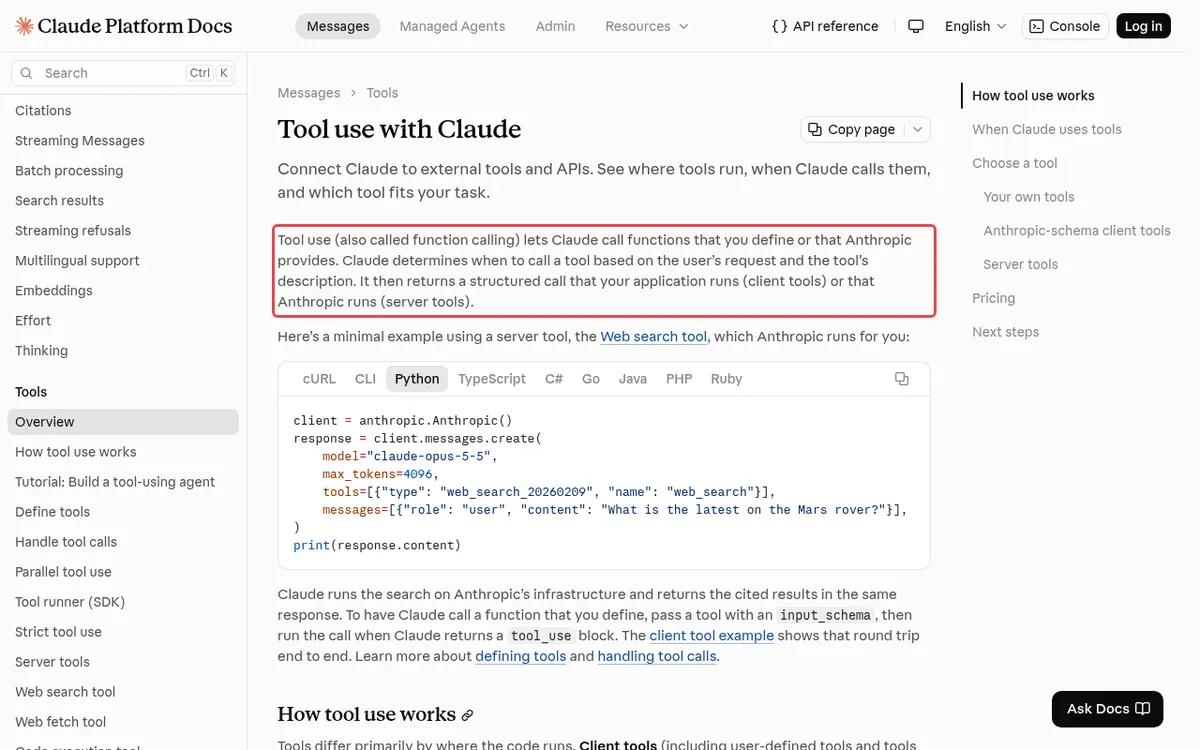
Model ngôn ngữ chỉ sinh ra chữ, nó không tự đọc được lịch học hay database của các bạn. Function calling là cách mình mô tả cho model biết có những hàm nào (tên, công dụng, tham số). Khi cần dữ liệu, model sinh ra một "lời gọi hàm" có cấu trúc gồm tên hàm và giá trị tham số, thay vì bịa câu trả lời. Tài liệu của Claude cũng định nghĩa như vậy.
Bước 2: Nắm quy trình 4 bước (model không tự chạy hàm)
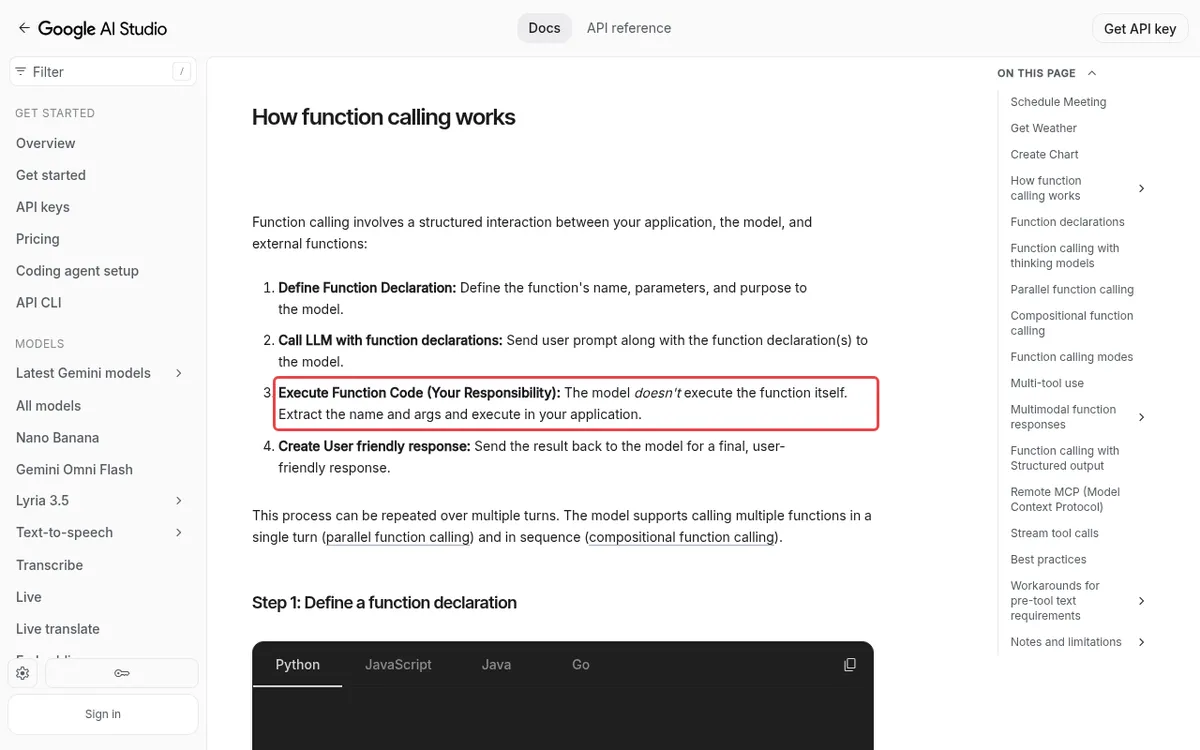
Tài liệu Gemini API mô tả quy trình gồm 4 bước: khai báo hàm, gửi câu hỏi kèm khai báo cho model, chương trình của mình chạy hàm, rồi gửi kết quả lại để model viết câu trả lời. Điểm quan trọng nhất mà nhiều bạn hiểu nhầm: model không tự chạy code. Nó chỉ nói "hãy gọi hàm X với tham số Y", còn việc chạy là trách nhiệm của code các bạn viết.
Bước 3: Chọn model nhỏ chuyên gọi hàm: BotPsy-0.8B
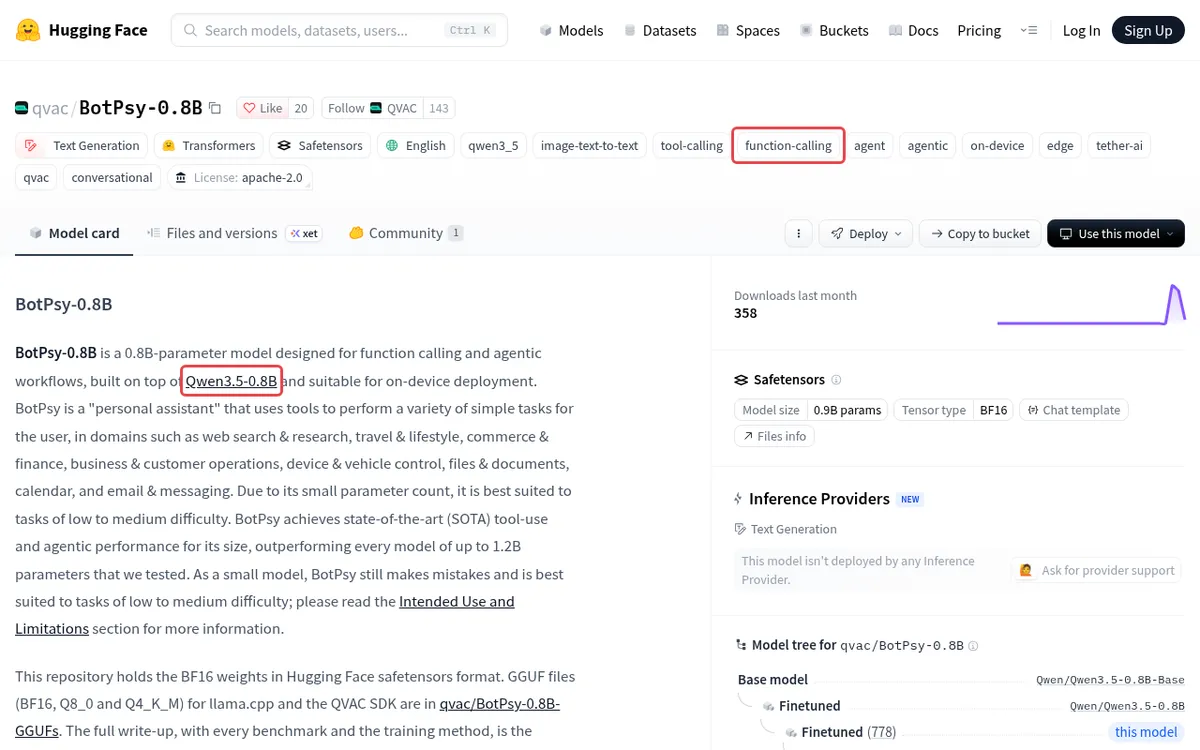
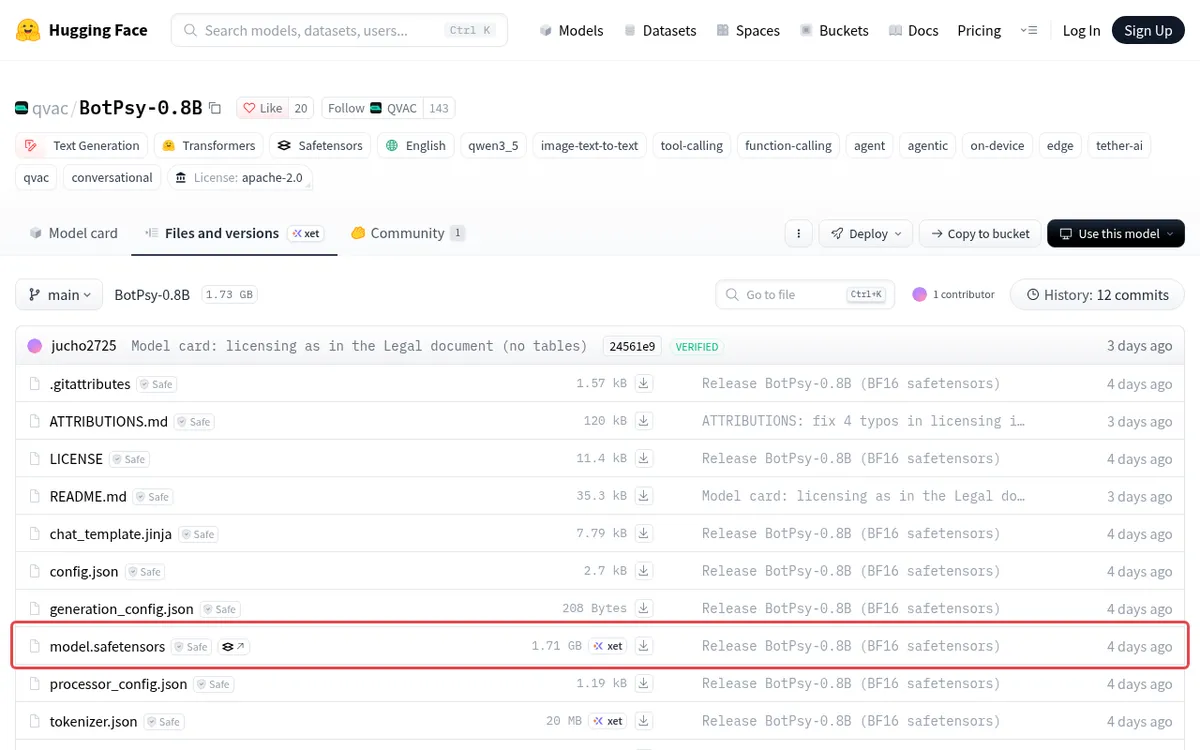
Các model lớn như GPT, Gemini, Claude đều gọi hàm rất tốt nhưng cần tài khoản và API key. Để học cơ chế, mình dùng qvac/BotPsy-0.8B của Tether AI Research: model 0,8 tỷ tham số, tinh chỉnh từ Qwen3.5-0.8B riêng cho function calling, giấy phép Apache 2.0, không cần đăng nhập để tải. Theo model card, điểm BFCL v4 (một bộ đo khả năng gọi hàm) là 44,0 so với 23,4 của model gốc. Đây là số do nhóm phát triển tự công bố, nên các bạn coi là tham khảo.
Ở tab Files and versions, file trọng số model.safetensors nặng 1,71 GB. Lần chạy đầu transformers sẽ tự tải về thư mục cache.
Bước 4: Cài môi trường Python
Mình cài bản PyTorch cho CPU (nhẹ hơn bản có CUDA rất nhiều) rồi cài transformers. Model dựa trên Qwen3.5 nên cần transformers từ bản 5.19 trở lên, theo model card.
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
pip install torch --index-url https://download.pytorch.org/whl/cpu
pip install transformers accelerate jinja2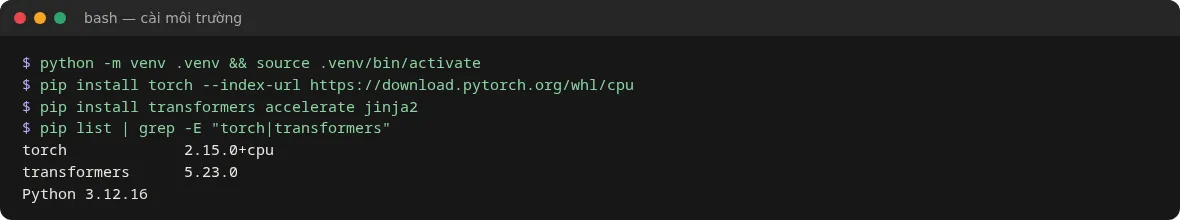
Bước 5: Viết hàm Python làm "công cụ"
Mình viết hai hàm: get_schedule trả về lịch học theo thứ (dữ liệu mẫu) và calculate_gpa tính điểm trung bình theo tín chỉ. Phần quan trọng là type hint và docstring: hàm get_json_schema của transformers đọc chúng để sinh ra JSON schema, chính là "bản mô tả" mà model sẽ đọc.
LICH_HOC = {
    "monday": [{"subject": "Android Basics", "time": "07:30", "room": "P301"}],
    "tuesday": [{"subject": "Database (SQL Server)", "time": "13:00", "room": "Lab 2"}],
    "wednesday": [],
}

def get_schedule(day: str) -> list:
    """
    Get the class schedule of the student for one day of the week.

    Args:
        day: Day of the week in English, lowercase, e.g. "monday".
    """
    return LICH_HOC.get(day.lower(), [])

def calculate_gpa(scores: list[float], credits: list[int]) -> float:
    """
    Calculate the weighted average score (GPA on a 10-point scale).

    Args:
        scores: Score of each subject, from 0 to 10.
        credits: Number of credits of each subject, same order as scores.
    """
    return round(sum(s * c for s, c in zip(scores, credits)) / sum(credits), 2)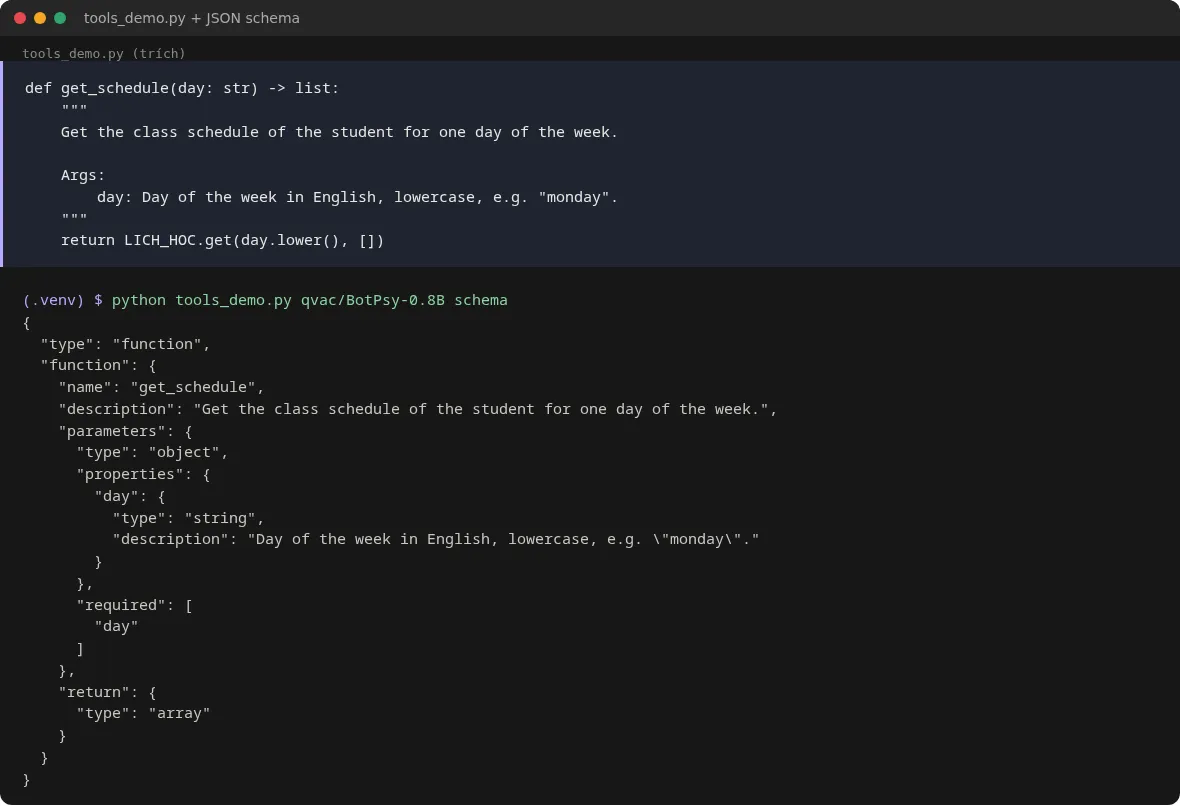
Docstring viết bằng tiếng Anh vì model card khuyến nghị dùng tiếng Anh.
Bước 6: Xem prompt mà model thật sự nhìn thấy
Không có phép màu nào cả: chat template của model chèn danh sách hàm vào system prompt dưới dạng JSON, kèm hướng dẫn định dạng <tool_call>. Các bạn in ra được bằng apply_chat_template(..., tools=tools, tokenize=False).
from transformers import AutoTokenizer
tok = AutoTokenizer.from_pretrained("qvac/BotPsy-0.8B")
messages = [{"role": "user", "content": "What classes do I have on Tuesday?"}]
print(tok.apply_chat_template(messages, tools=[get_schedule, calculate_gpa],
                              tokenize=False, add_generation_prompt=True))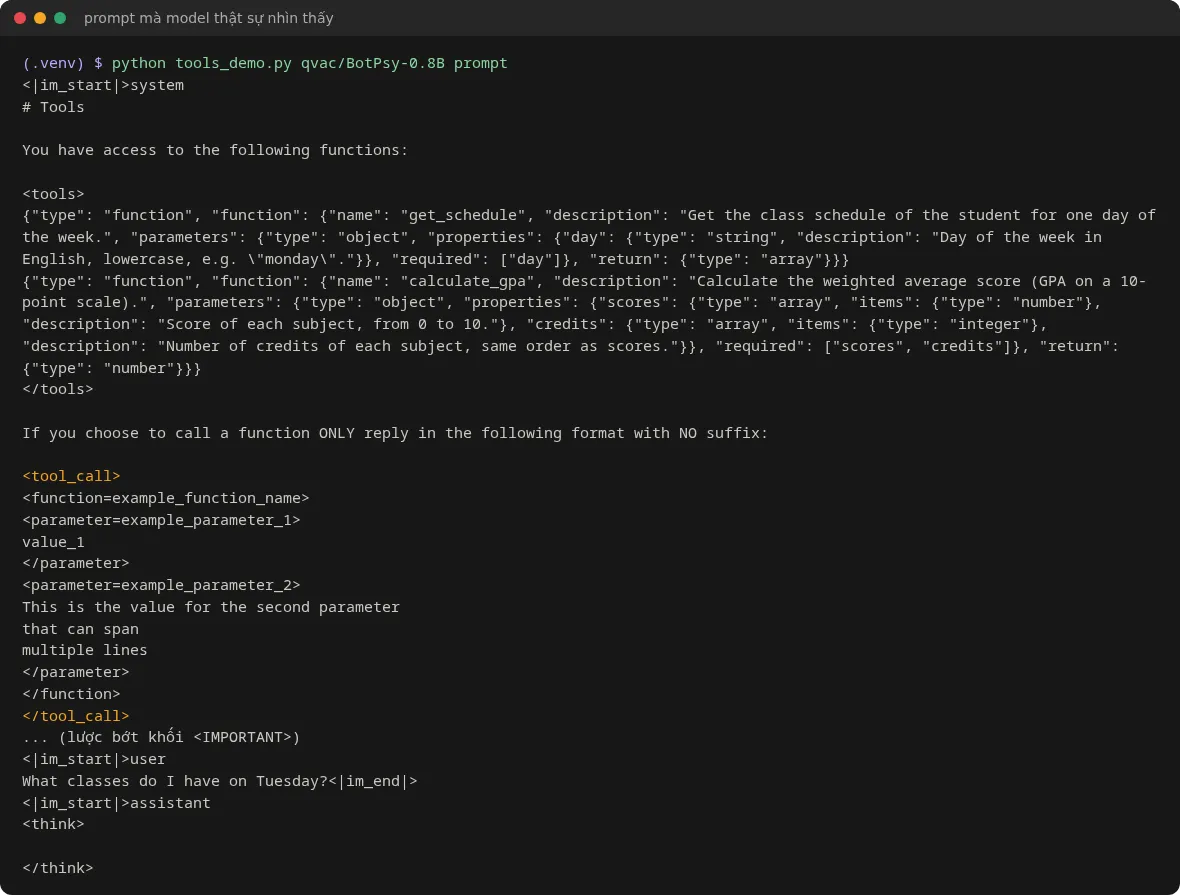
Bước 7: Chạy model, đọc lời gọi hàm và gửi kết quả lại
Đoạn code chính gồm 3 việc: sinh câu trả lời lần 1, tách khối <tool_call> ra thành tên hàm và tham số, chạy hàm thật, thêm kết quả vào hội thoại với vai trò tool, rồi sinh câu trả lời lần 2.
import json, re, torch
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("qvac/BotPsy-0.8B", dtype=torch.bfloat16)
tools = [get_schedule, calculate_gpa]
TOOLS = {"get_schedule": get_schedule, "calculate_gpa": calculate_gpa}

def generate(msgs):
    ids = tok.apply_chat_template(msgs, tools=tools, add_generation_prompt=True,
                                  return_tensors="pt", return_dict=True)
    out = model.generate(**ids, max_new_tokens=400, do_sample=False)
    return tok.decode(out[0][ids["input_ids"].shape[1]:], skip_special_tokens=True)

def parse_tool_calls(text):
    calls = []
    for block in re.findall(r"<tool_call>(.*?)</tool_call>", text, re.S):
        name = re.search(r"<function=([\w\-]+)>", block).group(1)
        args = {}
        for k, v in re.findall(r"<parameter=([\w\-]+)>\s*(.*?)\s*</parameter>", block, re.S):
            try:
                args[k] = json.loads(v)      # [8.5, 7, 9] -> list
            except json.JSONDecodeError:
                args[k] = v                  # tuesday -> chuỗi
        calls.append({"name": name, "arguments": args})
    return calls

reply = generate(messages)
calls = parse_tool_calls(reply)
messages.append({"role": "assistant", "content": "",
                 "tool_calls": [{"type": "function", "function": c} for c in calls]})
for c in calls:
    result = TOOLS[c["name"]](**c["arguments"])
    messages.append({"role": "tool", "name": c["name"], "content": json.dumps(result)})
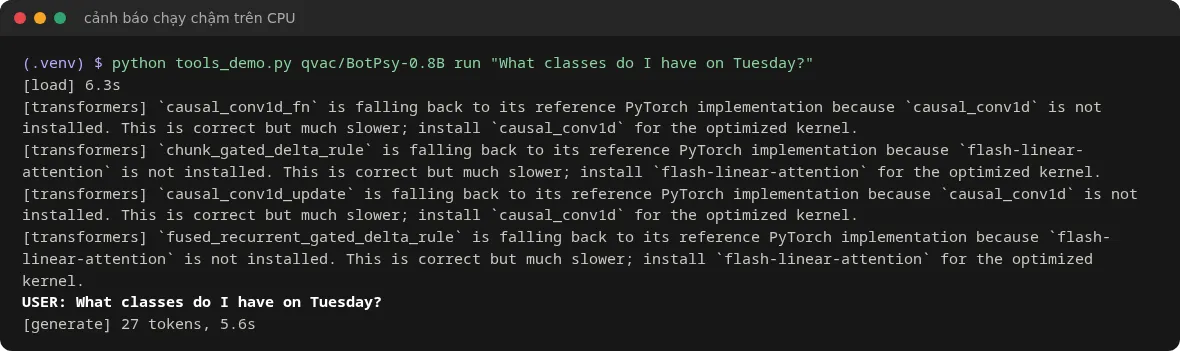
print(generate(messages))Trên 4 nhân CPU, mỗi lượt sinh mất khoảng 5–6 giây. Lời gọi hàm chỉ có 27 token nên rất nhanh.
Bước 8: Thử câu hỏi có nhiều tham số và câu hỏi không cần công cụ
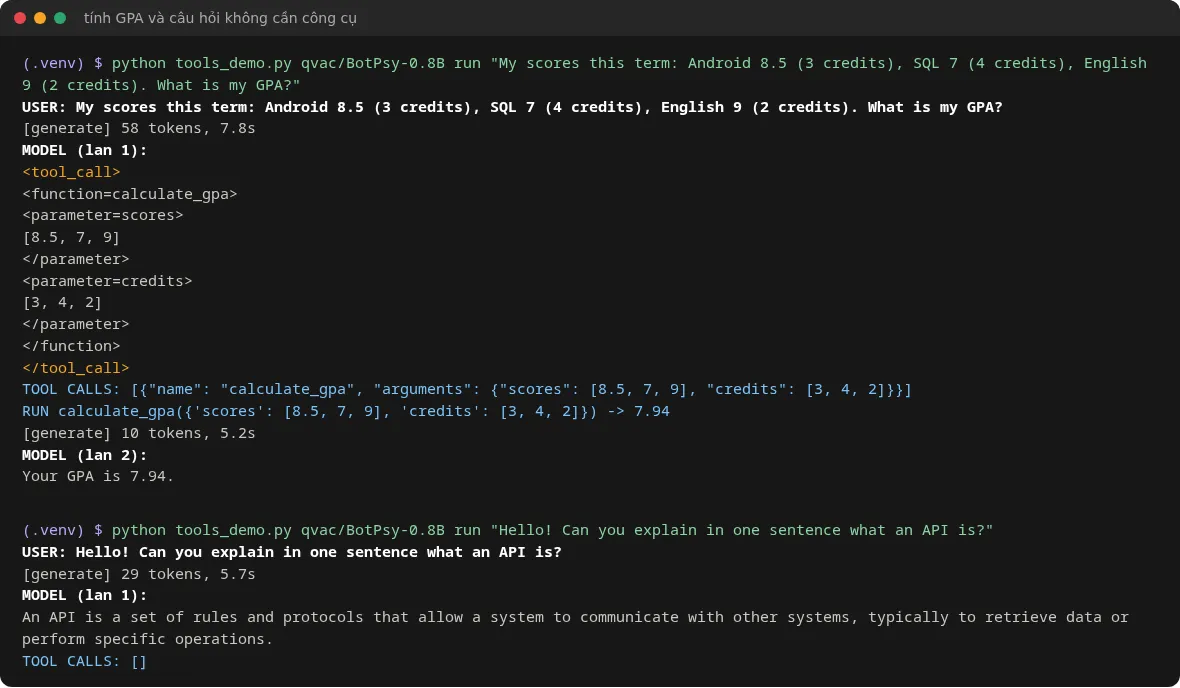
Với câu hỏi tính GPA, model tự tách điểm và tín chỉ thành hai danh sách đúng thứ tự, hàm Python tính ra 7,94 (các bạn tự kiểm tra: (8,5×3 + 7×4 + 9×2) / 9 = 7,94). Với câu hỏi "API là gì", model trả lời luôn mà không gọi hàm nào. Đó là hành vi đúng: chỉ gọi công cụ khi cần.
Bước 9: Vòng lặp agent: gọi nhiều hàm rồi mới trả lời
Một "AI agent" thực chất là đoạn code trên đặt trong vòng lặp: chừng nào model còn gọi hàm thì mình còn chạy hàm và gửi kết quả lại, đến khi model trả lời bằng chữ thì dừng. Mình giới hạn tối đa 3 lượt để tránh lặp vô hạn.
for turn in range(1, 4):
    reply = generate(messages)
    calls = parse_tool_calls(reply)
    if not calls:
        print("Trả lời:", reply)
        break
    messages.append({"role": "assistant", "content": "",
                     "tool_calls": [{"type": "function", "function": c} for c in calls]})
    for c in calls:
        fn = TOOLS.get(c["name"])
        result = fn(**c["arguments"]) if fn else {"error": f"unknown tool {c['name']}"}
        messages.append({"role": "tool", "name": c["name"],
                         "content": json.dumps(result, ensure_ascii=False)})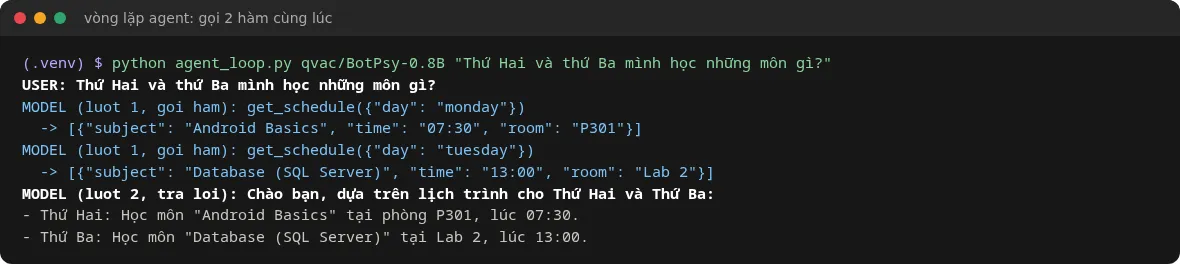
Về cơ bản, các coding agent như Claude Code hay Copilot agent mode cũng chạy theo vòng lặp này, chỉ khác là công cụ của chúng là "đọc file", "chạy lệnh terminal", "tìm kiếm web". MCP (xem bài MCP server là gì) là chuẩn chung để chia sẻ các công cụ đó giữa nhiều ứng dụng.
Lỗi thường gặp
Hỏi bằng tiếng Việt, model truyền tham số sai
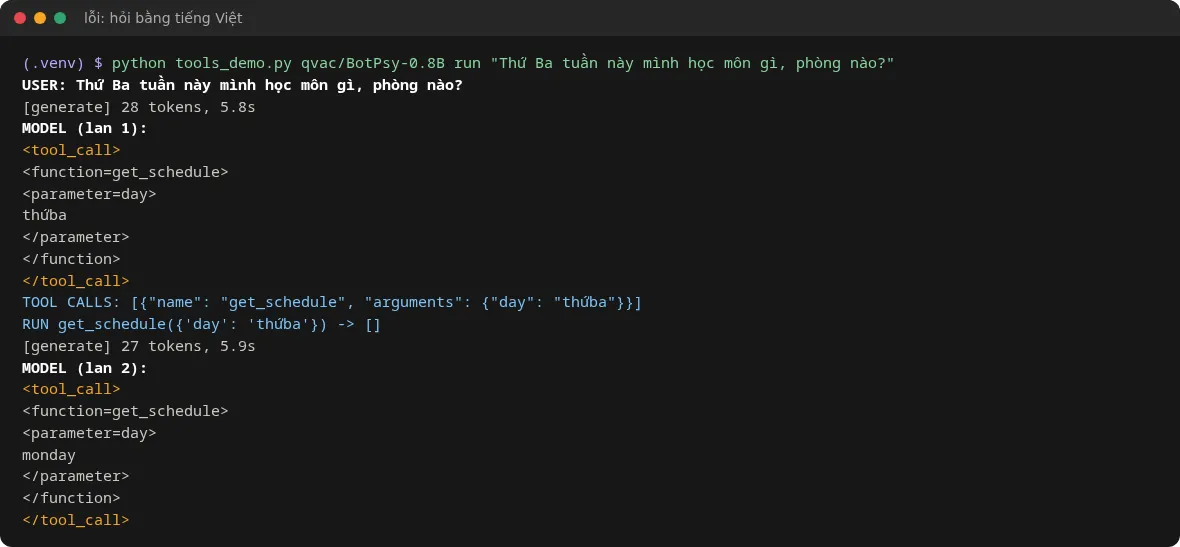
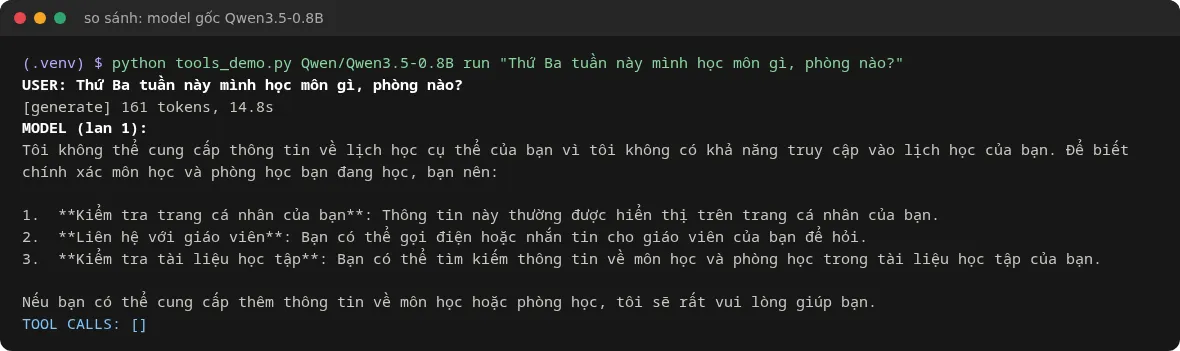
Với câu "Thứ Ba tuần này mình học môn gì, phòng nào?", BotPsy có gọi đúng hàm nhưng truyền day = "thứba". Hàm trả về danh sách rỗng, và ở lượt sau model lại đoán sang monday. Đây là lỗi thật mình gặp khi chạy, và nó cho thấy model nhỏ dễ bị lệch khi tham số là chữ tự do.
Cách sửa: giới hạn giá trị bằng enum. Trong docstring của transformers, các bạn ghi (choices: [...]) ở cuối mô tả tham số, schema sẽ có trường enum. Mình thêm cả dòng ánh xạ "Thu Ba = tuesday" vào mô tả hàm và cho hàm trả về lỗi rõ ràng khi giá trị không hợp lệ. Lần chạy tiếp theo model đã gọi đúng tuesday, nhưng câu trả lời cuối vẫn lẫn lộn: nó nói không trả lời được và nhắc tới "tuần thứ nhất", "tuần thứ Ba". Vì vậy mình thêm system prompt yêu cầu trả lời ngắn, bằng tiếng Việt, chỉ dựa trên dữ liệu công cụ trả về. Sau hai thay đổi này, kết quả đã đúng.
DAYS = ["monday", "tuesday", "wednesday", "thursday", "friday", "saturday", "sunday"]

def get_schedule(day: str) -> list:
    """
    Get the class schedule of the student for one day of the week.
    Vietnamese: Thu Hai = monday, Thu Ba = tuesday, ... Chu Nhat = sunday.

    Args:
        day: Day of the week. (choices: ["monday", "tuesday", "wednesday", "thursday", "friday", "saturday", "sunday"])
    """
    if day not in DAYS:
        return {"error": f"invalid day '{day}', use one of {DAYS}"}
    return LICH_HOC.get(day, [])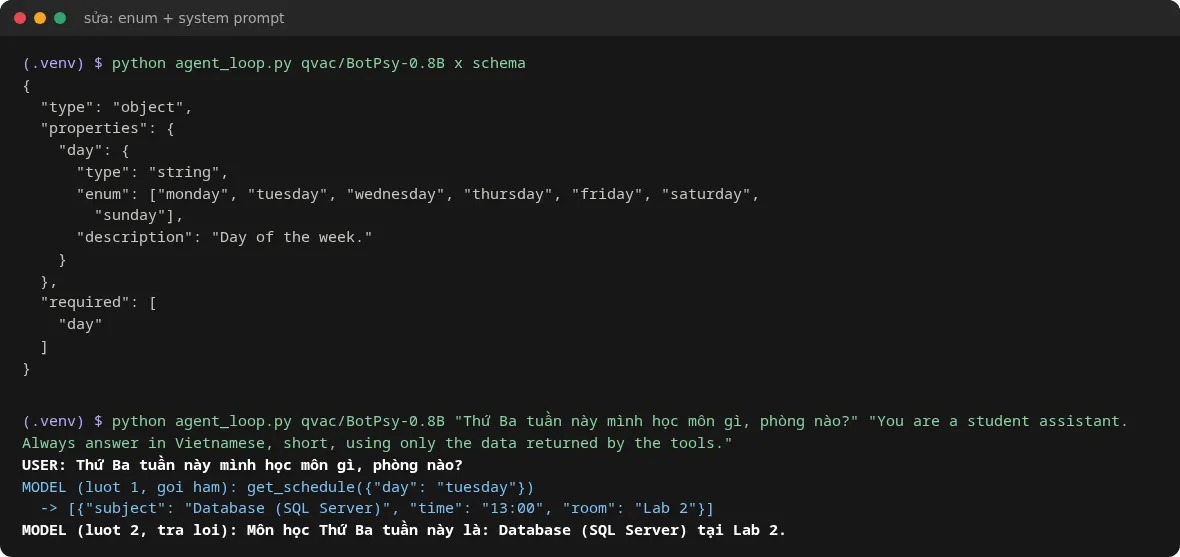
Model thường không gọi hàm, chỉ xin lỗi
Cùng câu hỏi tiếng Việt đó, model gốc Qwen3.5-0.8B (chưa tinh chỉnh cho function calling) không gọi hàm nào mà trả lời "Tôi không thể cung cấp thông tin về lịch học cụ thể của bạn", dù hàm get_schedule có ngay trong prompt. Với câu hỏi tiếng Anh đơn giản thì model gốc vẫn gọi hàm đúng. Nếu cần gọi hàm ổn định, các bạn nên chọn model có thẻ function-calling / tool-calling trên Hugging Face và thử với chính câu hỏi của người dùng thật.
Cảnh báo "falling back to its reference PyTorch implementation"
Lần chạy đầu transformers in ra 4 cảnh báo vì thiếu causal_conv1d và flash-linear-attention. Chính cảnh báo cũng nói rõ: cách chạy này đúng nhưng chậm hơn ("correct but much slower"). Mình không cài hai gói này, và mọi kết quả trong bài đều chạy ở chế độ đó trên CPU, nên các bạn có thể bỏ qua cảnh báo khi học.
Câu hỏi thường gặp
Function calling khác MCP thế nào?
Function calling là khả năng của model: đọc mô tả công cụ và sinh ra lời gọi có cấu trúc. MCP là giao thức để một ứng dụng (Claude Desktop, VS Code…) lấy danh sách công cụ từ một server bên ngoài. Ứng dụng lấy công cụ qua MCP rồi vẫn đưa cho model bằng function calling.
Model có tự chạy code của mình không?
Không. Model chỉ sinh ra tên hàm và tham số, chạy hay không là do code của các bạn. Với hàm có tác dụng thật (xóa file, gửi email), nên kiểm tra tham số hoặc hỏi lại người dùng trước khi chạy.
Dùng ChatGPT, Gemini, Claude API thì có khác không?
Ý tưởng giống hệt. Khác ở chỗ API đã tách sẵn lời gọi hàm thành JSON (không cần tự viết parse_tool_calls), nhưng cần tài khoản và API key.
Có dùng BotPsy-0.8B cho đồ án được không?
Được, với các tác vụ đơn giản và chạy offline (giấy phép Apache 2.0). Model card ghi rõ model hợp với tác vụ độ khó thấp đến trung bình, chủ yếu được huấn luyện bằng tiếng Anh, và không nên dùng cho việc liên quan đến tiền, dữ liệu cá nhân hay sức khỏe. Muốn chạy nhẹ hơn, nhóm phát triển có bản GGUF cho llama.cpp.
Máy không có GPU chạy có nổi không?
Trong thử nghiệm của mình (4 nhân CPU), mỗi lượt sinh mất khoảng 5–8 giây, cả vòng gọi hàm và trả lời khoảng 11–13 giây. File model bản BF16 nặng 1,71 GB nên laptop RAM 8 GB nhiều khả năng đủ, nhưng mình chưa thử trực tiếp trên laptop.
Nguồn tham khảo
- Claude Docs: Tool use with Claude
- Gemini API: Function calling
- Hugging Face Transformers: Tool use
- Model card qvac/BotPsy-0.8B
- Model gốc Qwen/Qwen3.5-0.8B
Ảnh chụp và thử nghiệm ngày 14/11/2026.