GGUF là gì? Lượng tử hóa model AI bằng llama.cpp trên CPU (2026)
Trong bài này
- GGUF là gì, lượng tử hóa là gì?
- Cần chuẩn bị
- Bước 1: Tải llama.cpp v1.0.0
- Bước 2: Giải nén và kiểm tra phiên bản
- Bước 3: Tải model gốc BF16 dạng GGUF
- Bước 4: Xem bên trong file GGUF
- Bước 5: Lượng tử hóa bằng llama-quantize
- Bước 6: So sánh dung lượng
- Bước 7: Đo tốc độ bằng llama-bench
- Bước 8: Đo chất lượng bằng perplexity
- Bước 9: Hỏi thử cùng một câu
- Bước 10: Chạy llama-server và gọi API
- Nên chọn bản nào?
- Lỗi thường gặp
- requantizing from type q4_K is disabled
- failed to open GGUF file (No such file or directory)
- Model trả lời lặp lại một câu
- Câu hỏi thường gặp
- GGUF khác safetensors thế nào?
- llama.cpp khác Ollama thế nào?
- Có phải lúc nào cũng tự lượng tử hóa không?
- Chạy được trên điện thoại Android không?
- Nguồn tham khảo
Khi tải model AI về máy, các bạn sẽ gặp những cái tên như Q4_K_M.gguf, Q8_0.gguf, BF16.gguf và không biết nên chọn file nào. Trong bài này, mình giải thích GGUF là gì, lượng tử hóa (quantization) là gì, rồi cùng các bạn tự lượng tử hóa một model 0,8 tỷ tham số bằng llama.cpp và đo thật dung lượng, tốc độ, chất lượng của từng bản ngay trên CPU. Bài làm theo llama.cpp v1.0.0 (phát hành 13/11/2026), mất khoảng 20 phút, không cần GPU, không cần tài khoản hay API key.
GGUF là gì, lượng tử hóa là gì?
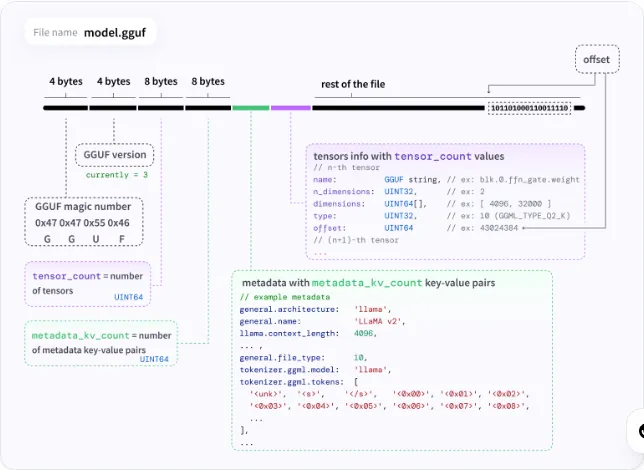
GGUF là định dạng file chứa model AI do tác giả của llama.cpp tạo ra. Theo tài liệu của Hugging Face, khác với safetensors chỉ chứa tensor (các ma trận trọng số), một file GGUF chứa cả tensor lẫn metadata: kiến trúc model, tokenizer, độ dài ngữ cảnh, giấy phép… Vì vậy chỉ cần một file là chạy được trong llama.cpp, Ollama hay LM Studio.
Lượng tử hóa là lưu mỗi trọng số bằng ít bit hơn. Bản gốc thường dùng 16 bit (BF16) cho mỗi số. Bản Q8 dùng khoảng 8 bit, Q4 khoảng 4–5 bit, Q2 khoảng 2–3 bit. Ít bit hơn thì file nhỏ hơn, chạy nhanh hơn, nhưng số bị làm tròn nhiều hơn nên model có thể trả lời kém đi. Phần dưới đây sẽ đo xem "kém đi" là bao nhiêu.
Cần chuẩn bị
- Máy Linux, macOS hoặc Windows 64-bit, RAM từ 4 GB, trống khoảng 4 GB ổ cứng. Mình chạy trên Linux, CPU 4 luồng.
- Python 3 (chỉ để cài gói
ggufxem metadata, không bắt buộc). - Biết mở terminal và gõ lệnh cơ bản. Nếu chưa từng chạy model trên máy, các bạn đọc trước bài Ollama là gì.
Bước 1: Tải llama.cpp v1.0.0
llama.cpp là chương trình C/C++ chạy model GGUF, cũng là "động cơ" bên dưới nhiều công cụ khác. Ngày 13/11/2026 dự án ra bản v1.0.0, được GitHub đánh dấu Latest.
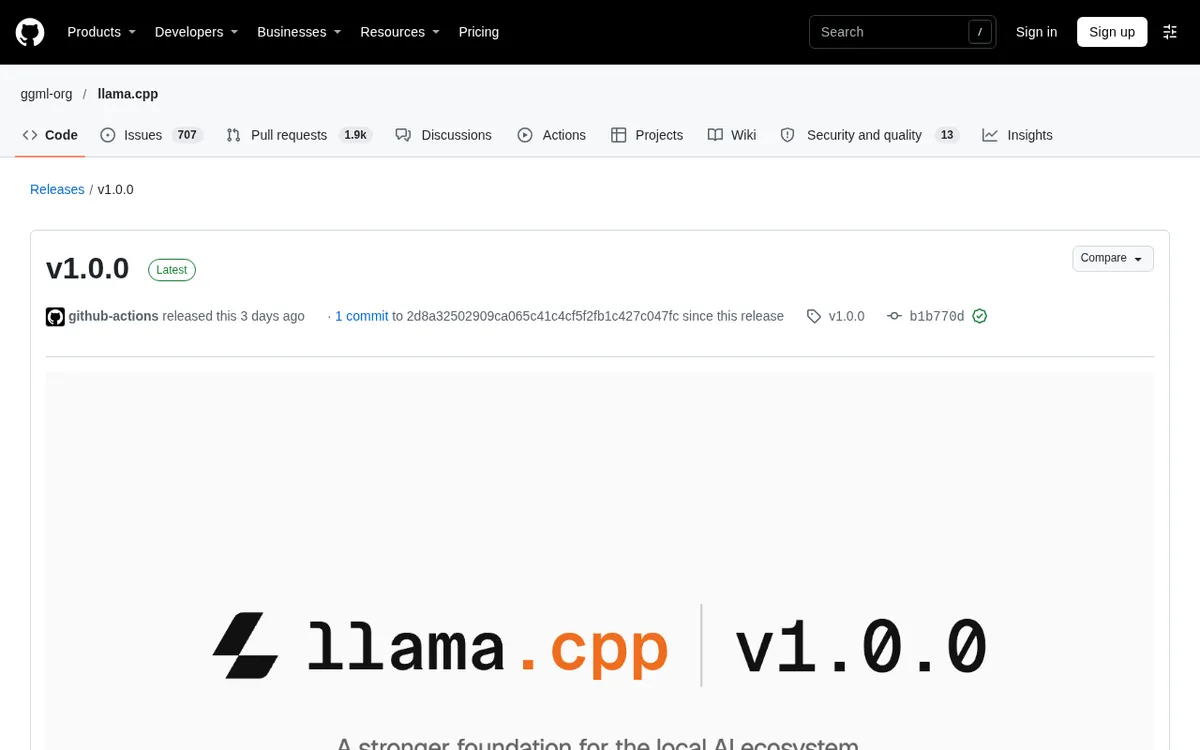
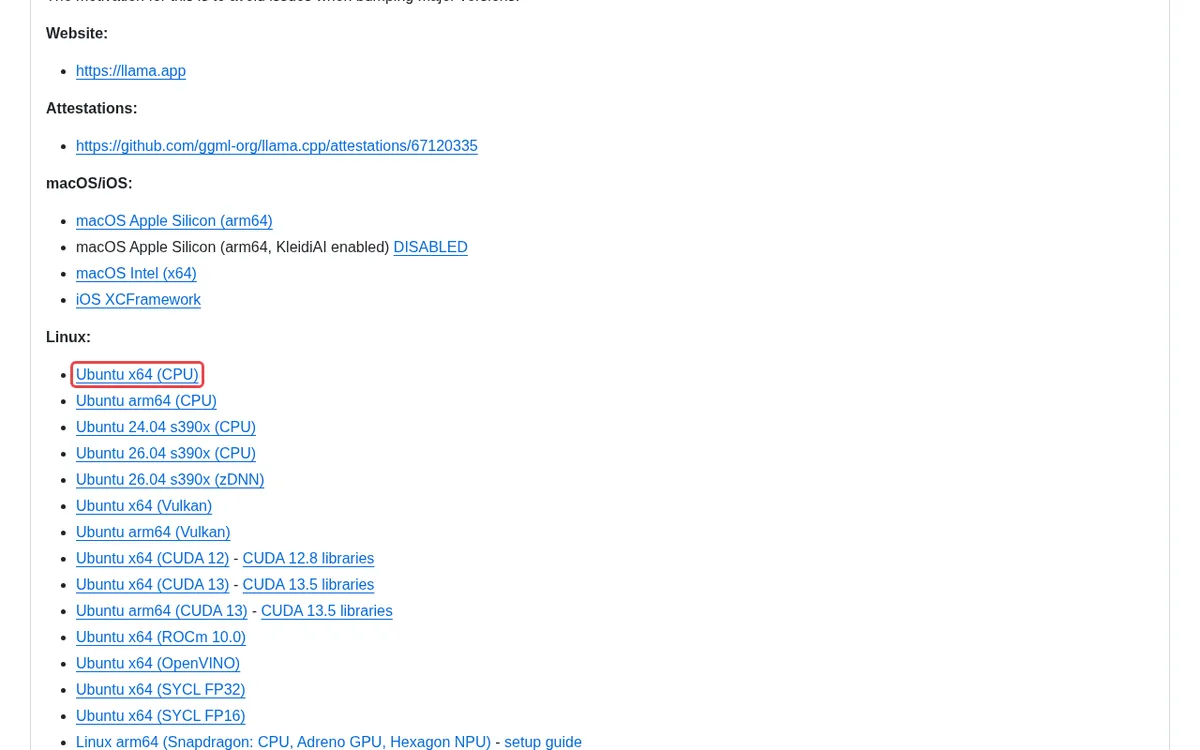
File chạy sẵn của v1.0.0 nằm ở bản build b12359 (đăng cùng lúc). Các bạn chọn đúng hệ điều hành: Linux chọn Ubuntu x64 (CPU), Windows chọn file win-cpu-x64.zip. Trong danh sách còn có cả bản cho Android arm64.
Bước 2: Giải nén và kiểm tra phiên bản
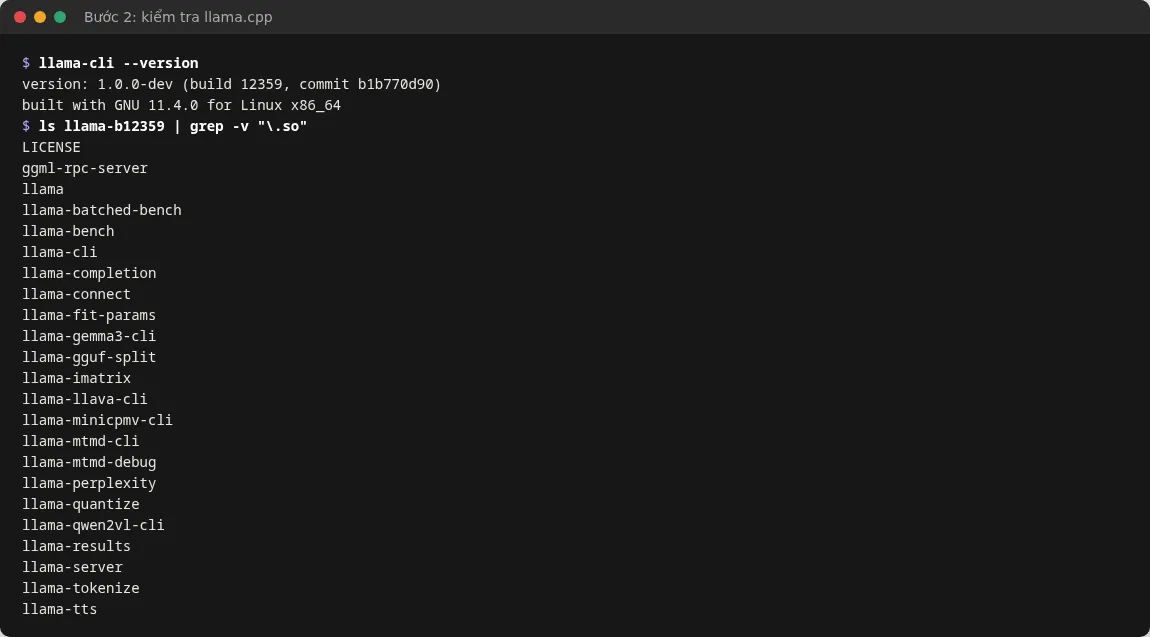
Trên Linux, mình tải và giải nén bằng các lệnh sau, rồi thêm thư mục vào PATH để gọi lệnh cho gọn:
curl -L -o llama-v1.tar.gz https://github.com/ggml-org/llama.cpp/releases/download/b12359/llama-b12359-bin-ubuntu-x64.tar.gz
tar -xzf llama-v1.tar.gz
export PATH=$PWD/llama-b12359:$PATH
export LD_LIBRARY_PATH=$PWD/llama-b12359
llama-cli --version
Bài này dùng 5 công cụ trong thư mục: llama-quantize (lượng tử hóa), llama-bench (đo tốc độ), llama-perplexity (đo chất lượng), llama-cli (chat) và llama-server (chạy API).
Bước 3: Tải model gốc BF16 dạng GGUF
Muốn tự lượng tử hóa thì phải bắt đầu từ bản 16 bit. Mình dùng Qwen3.5-0.8B (giấy phép Apache 2.0) trong kho chính thức ggml-org/Qwen3.5-0.8B-GGUF trên Hugging Face, file Qwen3.5-0.8B-BF16.gguf nặng 1,56 GB.
mkdir -p models
curl -L -o models/Qwen3.5-0.8B-BF16.gguf https://huggingface.co/ggml-org/Qwen3.5-0.8B-GGUF/resolve/main/Qwen3.5-0.8B-BF16.gguf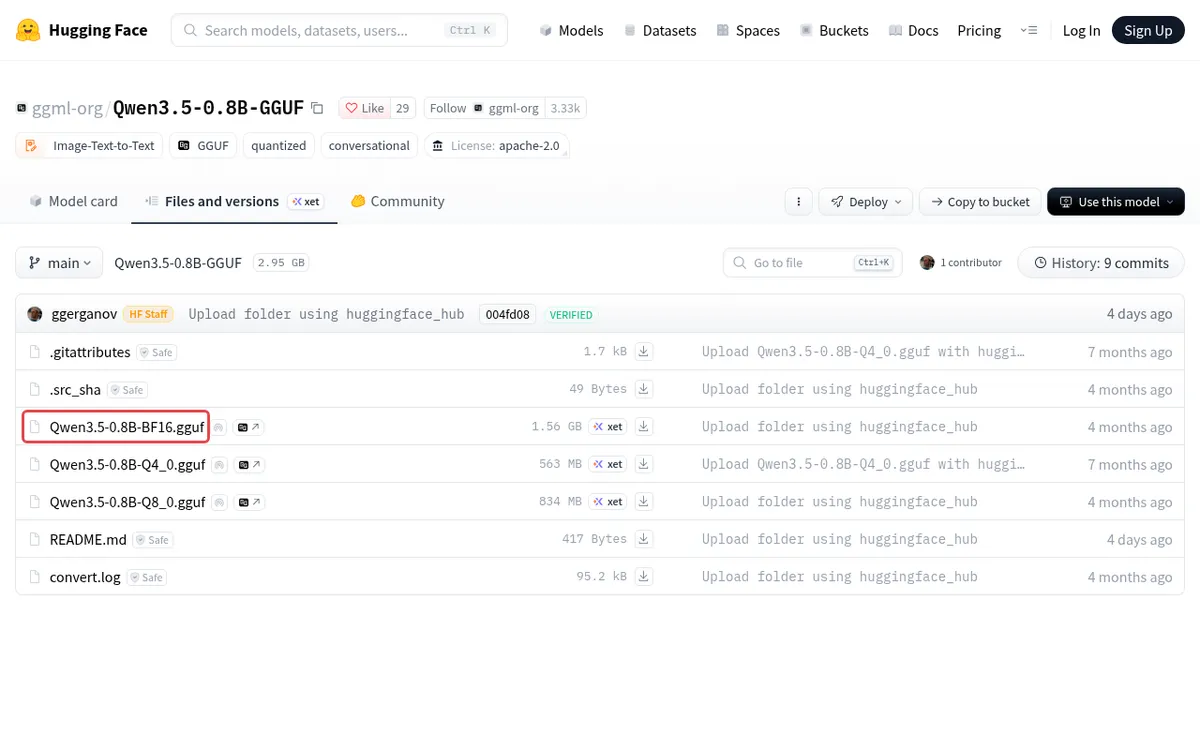
Bước 4: Xem bên trong file GGUF
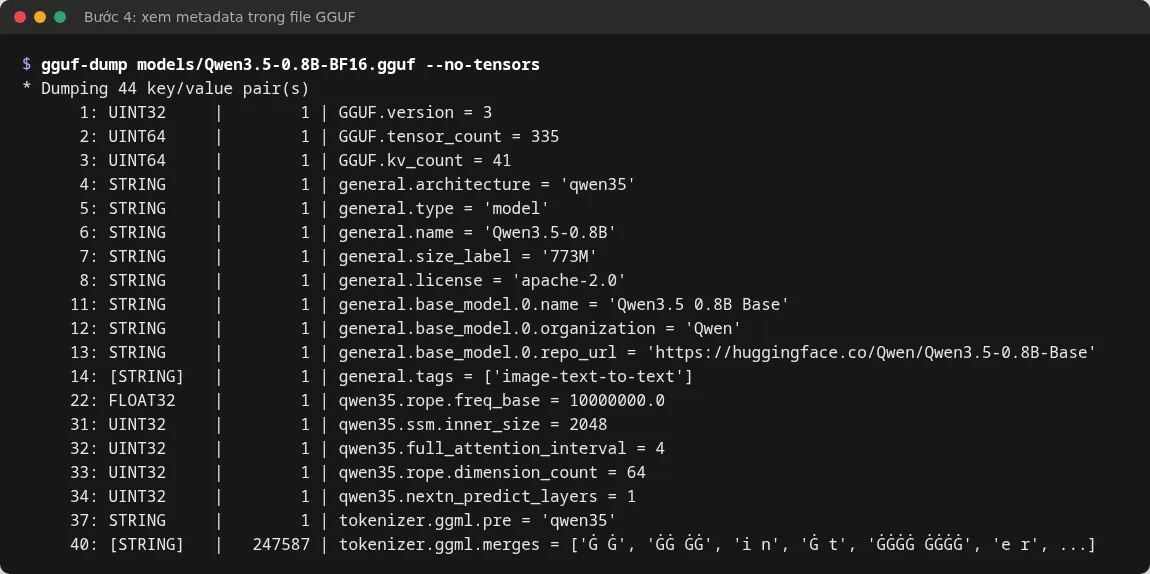
Gói Python gguf có lệnh gguf-dump để đọc metadata mà không cần chạy model:
pip install gguf
gguf-dump models/Qwen3.5-0.8B-BF16.gguf --no-tensors
Kết quả cho thấy file có 335 tensor, kiến trúc qwen35, nhãn kích thước 773M, giấy phép apache-2.0 và đường dẫn tới model gốc. Tokenizer cũng nằm ngay trong file, đây là lý do một file GGUF chạy được độc lập.
Bước 5: Lượng tử hóa bằng llama-quantize
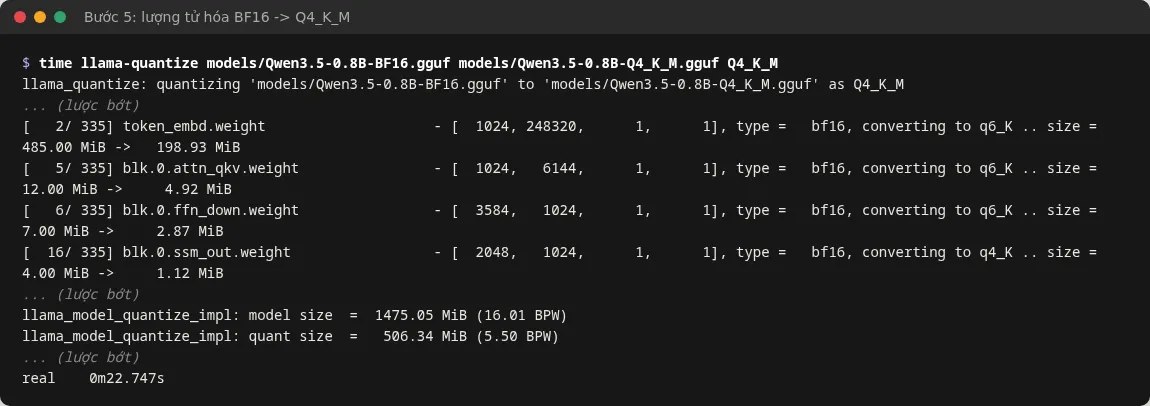
Cú pháp là: file vào, file ra, kiểu lượng tử hóa. Mình tạo 3 bản Q8_0, Q4_K_M và Q2_K:
llama-quantize models/Qwen3.5-0.8B-BF16.gguf models/Qwen3.5-0.8B-Q8_0.gguf Q8_0
llama-quantize models/Qwen3.5-0.8B-BF16.gguf models/Qwen3.5-0.8B-Q4_K_M.gguf Q4_K_M
llama-quantize models/Qwen3.5-0.8B-BF16.gguf models/Qwen3.5-0.8B-Q2_K.gguf Q2_K
Bản Q4_K_M mất khoảng 23 giây, Q8_0 chỉ hơn 2 giây. Các bạn để ý log: không phải tensor nào cũng bị nén xuống 4 bit. Bảng embedding token_embd và một số tensor quan trọng được giữ ở q6_K, các tensor còn lại mới xuống q4_K. Chữ "M" (medium) trong Q4_K_M chính là kiểu pha trộn này.
Bước 6: So sánh dung lượng
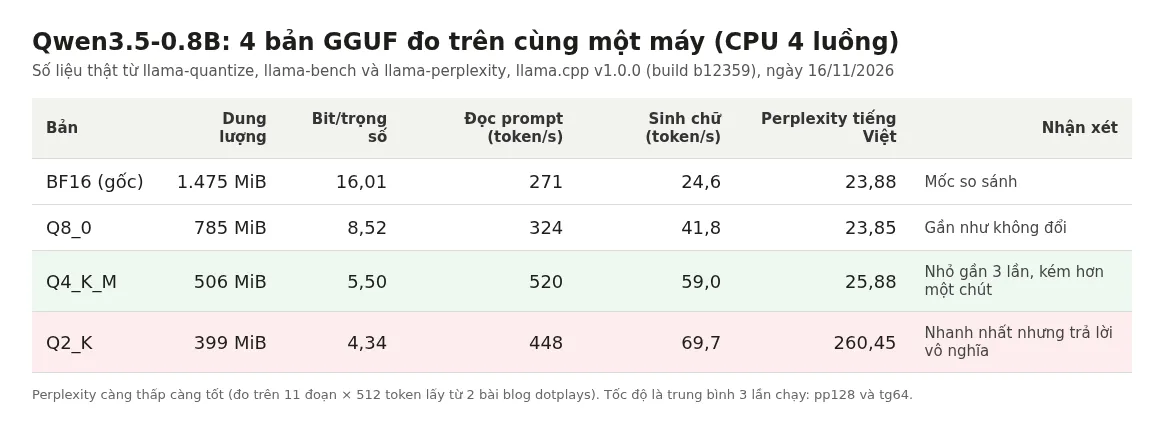
Từ 1,5 GB, bản Q8_0 còn 795 MB, Q4_K_M còn 517 MB, Q2_K còn 410 MB.
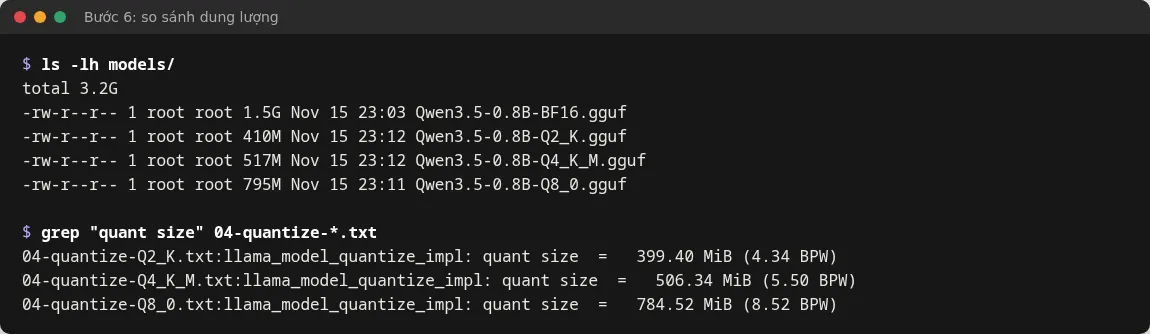
Có một điểm bất ngờ: Q2_K vẫn trung bình 4,34 bit mỗi trọng số chứ không phải 2. Lý do là bảng embedding của model này rất lớn (248.320 token × 1024 chiều, 485 MiB, gần 1/3 model) và luôn được giữ ở q6_K. Riêng bảng này đã chiếm 199 MiB trong 399 MiB của bản Q2_K. Với model nhỏ, lượng tử hóa thấp hơn nữa không giúp file nhỏ đi bao nhiêu.
Bước 7: Đo tốc độ bằng llama-bench
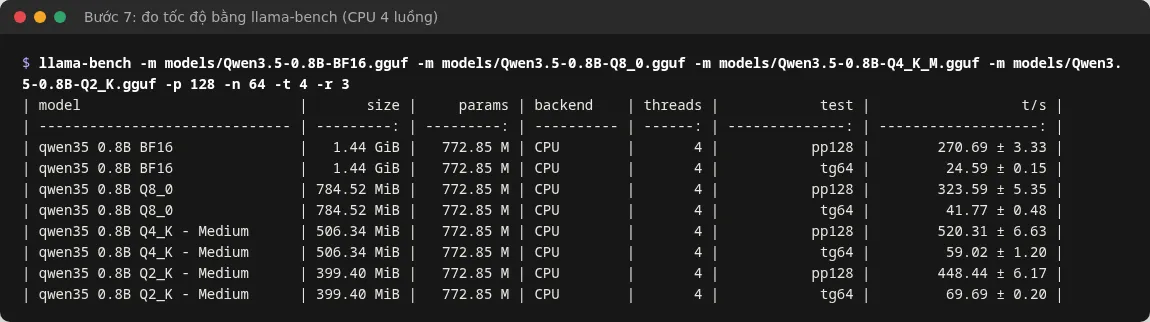
llama-bench -m models/Qwen3.5-0.8B-BF16.gguf -m models/Qwen3.5-0.8B-Q8_0.gguf \
  -m models/Qwen3.5-0.8B-Q4_K_M.gguf -m models/Qwen3.5-0.8B-Q2_K.gguf -p 128 -n 64 -t 4 -r 3
Cột pp128 là tốc độ đọc prompt, tg64 là tốc độ sinh chữ (token mỗi giây). Bản Q4_K_M sinh 59 token/giây, gấp khoảng 2,4 lần bản gốc (24,6). Q2_K sinh nhanh nhất (69,7) nhưng đọc prompt lại chậm hơn Q4_K_M.
Bước 8: Đo chất lượng bằng perplexity
Perplexity cho biết model "bối rối" thế nào khi đoán từ tiếp theo trong một đoạn văn có sẵn. Càng thấp càng tốt. Mình lấy chữ của hai bài blog dotplays (RAG và token) làm văn bản tiếng Việt vi-eval.txt, rồi chạy cho từng bản:
llama-perplexity -m models/Qwen3.5-0.8B-Q4_K_M.gguf -f vi-eval.txt -c 512 -t 4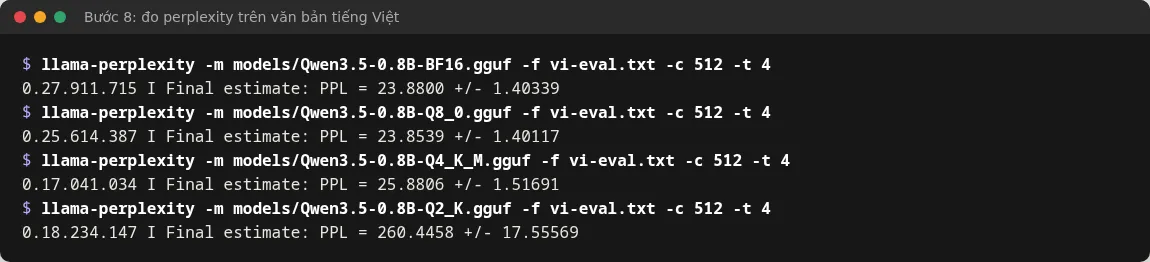
Q8_0 gần như y hệt bản gốc (23,85 so với 23,88, chênh lệch nằm trong sai số ±1,4). Q4_K_M tăng lên 25,88, tức kém hơn khoảng 8%. Q2_K vọt lên 260, gấp khoảng 11 lần: model gần như không còn hiểu tiếng Việt. Bảng dưới gom cả ba phép đo:
Bước 9: Hỏi thử cùng một câu
Con số là trung bình, nên mình hỏi thêm một câu cụ thể cho cả 4 bản, nhiệt độ 0 để kết quả lặp lại được:
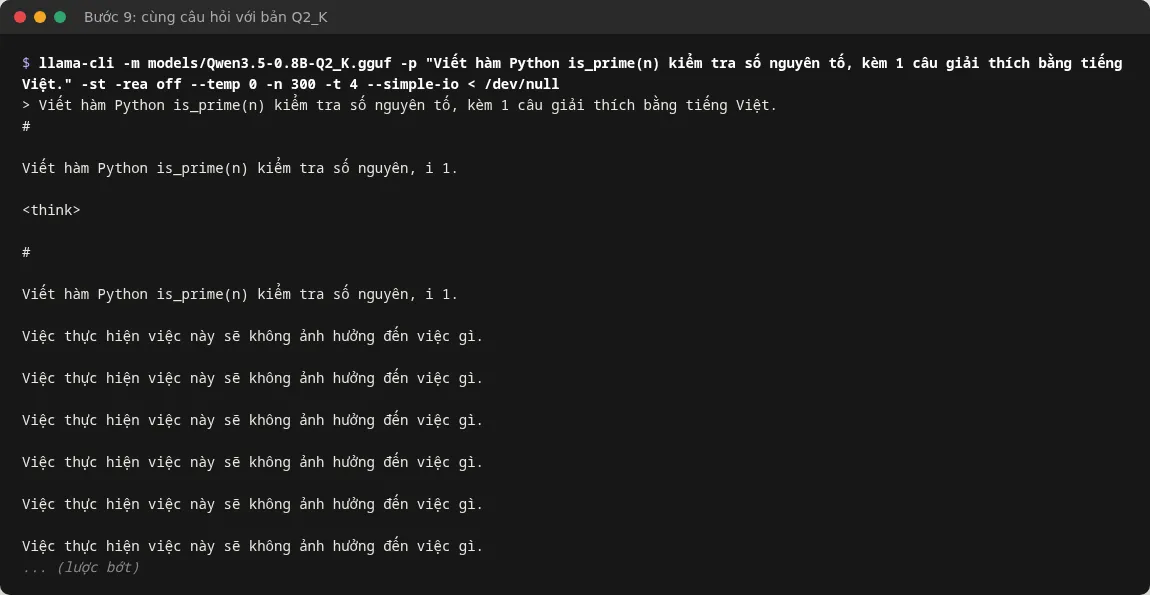
llama-cli -m models/Qwen3.5-0.8B-Q4_K_M.gguf -p "Viết hàm Python is_prime(n) kiểm tra số nguyên tố, kèm 1 câu giải thích bằng tiếng Việt." -st -rea off --temp 0 -n 300 -t 4-st là hỏi một lượt rồi thoát, -rea off tắt chế độ suy nghĩ (thinking) của Qwen3.5. Bản Q4_K_M viết code gọn, có xử lý n ≤ 1, nhưng phần giải thích lại ghi sai ("n ≤ 3 không phải số nguyên tố").
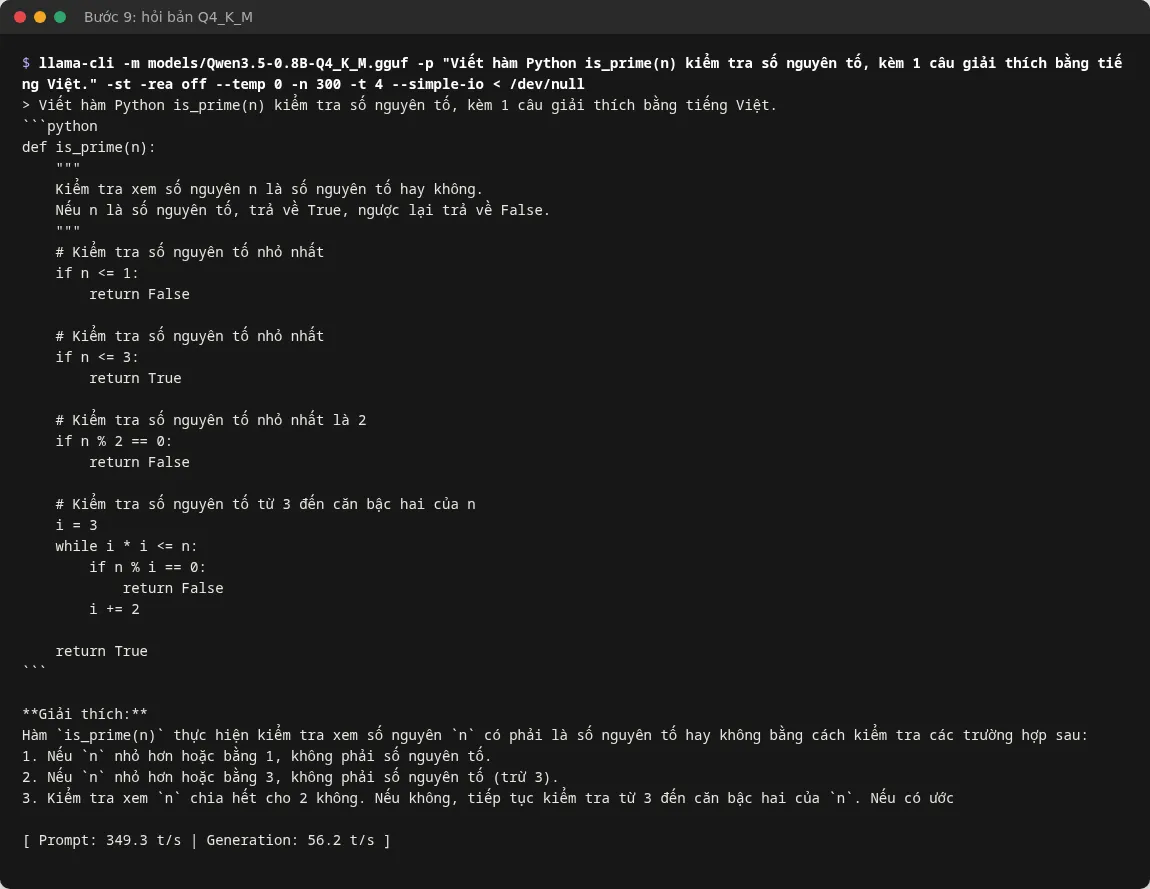
Bản Q2_K thì hỏng hẳn: chép lại đề sai chữ, chèn thẻ <think> dù đã tắt thinking, rồi lặp một câu vô nghĩa cho đến hết 300 token. Kết quả này khớp với perplexity 260 ở bước 8.
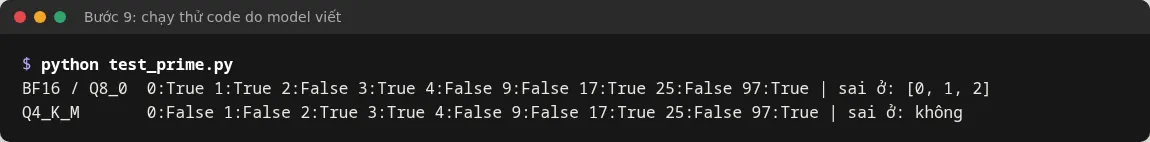
Bản BF16 và Q8_0 viết ra cùng một hàm. Mình chạy thử cả hai hàm với vài số và thấy điều bất ngờ: hàm của bản gốc sai ở 0, 1 và 2 (cho rằng 2 không phải số nguyên tố), còn hàm của Q4_K_M đúng hết. Một câu hỏi không nói lên được bản nào tốt hơn, các bạn cần đo trên nhiều dữ liệu như bước 8 và luôn chạy thử code AI viết.
Bước 10: Chạy llama-server và gọi API
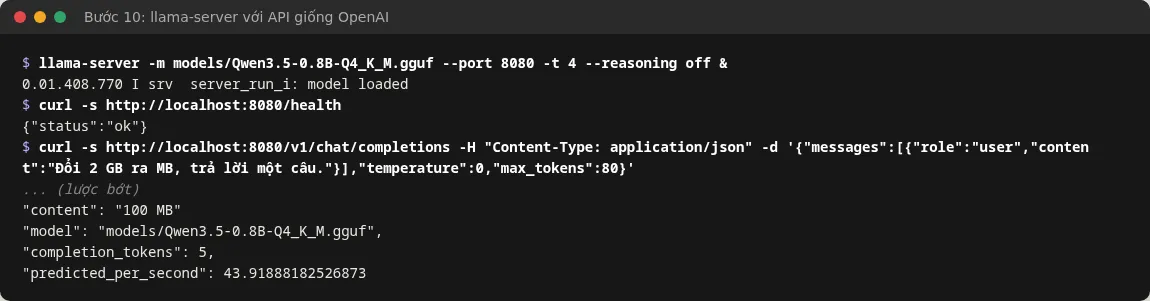
llama-server mở một API giống OpenAI ở cổng 8080, nên code đang gọi ChatGPT chỉ cần đổi địa chỉ là dùng được model trên máy:
llama-server -m models/Qwen3.5-0.8B-Q4_K_M.gguf --port 8080 -t 4 --reasoning off
curl -s http://localhost:8080/v1/chat/completions -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Đổi 2 GB ra MB, trả lời một câu."}],"temperature":0,"max_tokens":80}'
API trả về đúng định dạng, nhưng nội dung "100 MB" là sai. Mình hỏi lại câu này với bản gốc BF16 và cũng nhận được "100 MB.", nghĩa là lỗi do model 0,8B quá nhỏ chứ không phải do lượng tử hóa.
Nên chọn bản nào?
- Q8_0: gần như không mất chất lượng, nhỏ một nửa. Hợp khi máy còn dư RAM.
- Q4_K_M: nhỏ gần 3 lần, nhanh hơn 2,4 lần, chất lượng giảm nhẹ. Đây là lựa chọn mặc định hợp lý cho laptop sinh viên.
- Q2_K: với model nhỏ như 0,8B thì không nên dùng. Muốn dùng 2–3 bit, các bạn nên chọn model lớn hơn hoặc các bản có importance matrix (imatrix) do nhóm khác làm sẵn.
Lỗi thường gặp
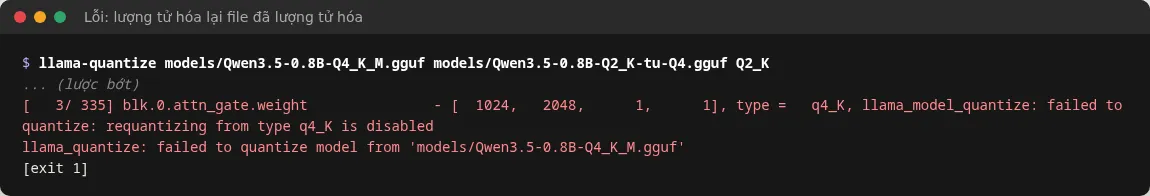
requantizing from type q4_K is disabled
Lỗi này xuất hiện khi lấy file đã lượng tử hóa (Q4_K_M) để nén tiếp xuống Q2_K. Cách đúng là luôn bắt đầu từ bản BF16/F16. Có cờ --allow-requantize để ép chạy, nhưng tài liệu của llama-quantize cảnh báo cách này có thể làm chất lượng giảm nặng.
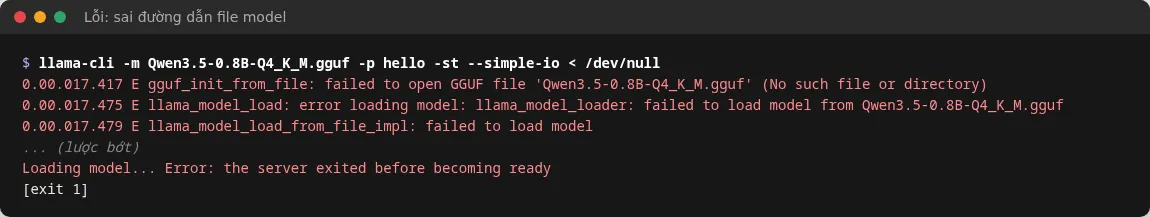
failed to open GGUF file (No such file or directory)
Sai đường dẫn sau -m. Ở đây file nằm trong thư mục models/ nhưng lệnh lại ghi thiếu. Các bạn kiểm tra bằng ls models/ rồi copy đúng tên file.
Model trả lời lặp lại một câu
Thường là do dùng bản lượng tử hóa quá thấp so với kích thước model (như Q2_K ở bước 9). Đổi sang Q4_K_M hoặc Q8_0.
Câu hỏi thường gặp
GGUF khác safetensors thế nào?
safetensors chỉ chứa tensor, thường dùng với thư viện transformers của Python (để huấn luyện, fine-tune như bài LoRA). GGUF chứa cả tensor lẫn metadata, tokenizer, thường đã lượng tử hóa, dùng để chạy model nhanh với llama.cpp, Ollama, LM Studio.
llama.cpp khác Ollama thế nào?
Ollama dùng file GGUF và cung cấp cách tải, chạy model đơn giản hơn. llama.cpp là công cụ gốc, cho các bạn tự lượng tử hóa, đo tốc độ, đo perplexity như trong bài. Học llama.cpp giúp hiểu Ollama đang làm gì bên dưới.
Có phải lúc nào cũng tự lượng tử hóa không?
Không. Nhiều kho trên Hugging Face đã có sẵn nhiều bản, ví dụ kho ggml-org có Q4_0 và Q8_0, kho unsloth có từ 2 bit đến 8 bit. Tự làm có ích khi các bạn fine-tune model riêng hoặc muốn so sánh như bài này.
Chạy được trên điện thoại Android không?
Bản phát hành có file dựng sẵn cho Android arm64. Mình chưa thử trên điện thoại trong bài này. Với RAM điện thoại, bản Q4_K_M của model nhỏ (khoảng 500 MB) là điểm bắt đầu hợp lý.
Nguồn tham khảo
- llama.cpp v1.0.0 release và bản build b12359
- Tài liệu llama-quantize
- Hugging Face: GGUF và bảng các kiểu lượng tử hóa
- ggml-org/Qwen3.5-0.8B-GGUF và Qwen/Qwen3.5-0.8B
- Gói Python gguf (gguf-dump)
Ảnh chụp và thử nghiệm ngày 16/11/2026.
