Window function trong SQL: ROW_NUMBER, RANK, SUM OVER và bài tập tổng hợp (Bài 5)
Trong bài này
- Window function khác GROUP BY thế nào?
- ROW_NUMBER: đánh số thứ tự trong từng nhóm
- ROW_NUMBER, RANK, DENSE_RANK: xử lý đồng hạng
- SUM OVER: cộng dồn và tỷ lệ phần trăm
- LAG: so sánh với dòng trước
- Lấy top N mỗi nhóm: ROW_NUMBER trong CTE
- Những lỗi hay gặp
- Bài tập tổng hợp cả series
- Tổng kết series: SQLite và SQL Server khác nhau ở đâu?
Series · Bài 5/5 SQL từ cơ bản đến nâng cao
- SQL là gì? Truy vấn đầu tiên với SELECT và WHERE
- ORDER BY, LIMIT, hàm gộp COUNT, SUM, AVG và GROUP BY, HAVING
- JOIN trong SQL: nối nhiều bảng với INNER JOIN và LEFT JOIN
- Subquery và CTE (WITH): chia nhỏ truy vấn khó
- Window function (ROW_NUMBER, RANK, SUM OVER) và bài tập tổng hợp
GROUP BY rất mạnh nhưng có một nhược điểm: nó gộp nhiều dòng thành một. Muốn vừa thấy từng sản phẩm, vừa thấy giá trung bình của danh mục nằm ngay bên cạnh, hay đánh số thứ tự đơn hàng của mỗi khách, cộng dồn doanh thu qua các tháng, thì GROUP BY không làm được gọn. Đây là việc của window function (hàm cửa sổ): tính toán trên một nhóm dòng mà vẫn giữ nguyên từng dòng. Bài này đi qua ROW_NUMBER, RANK, DENSE_RANK, SUM OVER, LAG, rồi kết thúc series bằng bộ bài tập tổng hợp.
Đây là bài 5/5, bài cuối của series SQL từ cơ bản đến nâng cao. Bài này dùng CTE của bài 4 khá nhiều, cùng với JOIN (bài 3), GROUP BY (bài 2) và SELECT, WHERE (bài 1). Mọi câu lệnh được mình chạy ngày 15/11/2026 trên trang thực hành (SQLite 3.45.2 trong trình duyệt), dữ liệu là giả lập, "doanh thu" là tổng tiền các đơn không bị hủy. Window function có trên SQLite từ bản 3.25 và trên SQL Server; mình ghi chú phiên bản SQL Server ở từng hàm.
Window function khác GROUP BY thế nào?
So sánh nhanh trên bảng sản phẩm:
SELECT danh_muc, AVG(gia) FROM san_pham GROUP BY danh_muc: 12 dòng gộp thành 4 dòng, mất tên từng sản phẩm.- Window function: vẫn 12 dòng, mỗi dòng có thêm một cột tính trên "cửa sổ" là các dòng cùng danh mục.
SELECT danh_muc, ten_sp, gia,
       AVG(gia) OVER (PARTITION BY danh_muc) AS gia_tb_danh_muc
FROM san_pham
ORDER BY danh_muc, gia DESC;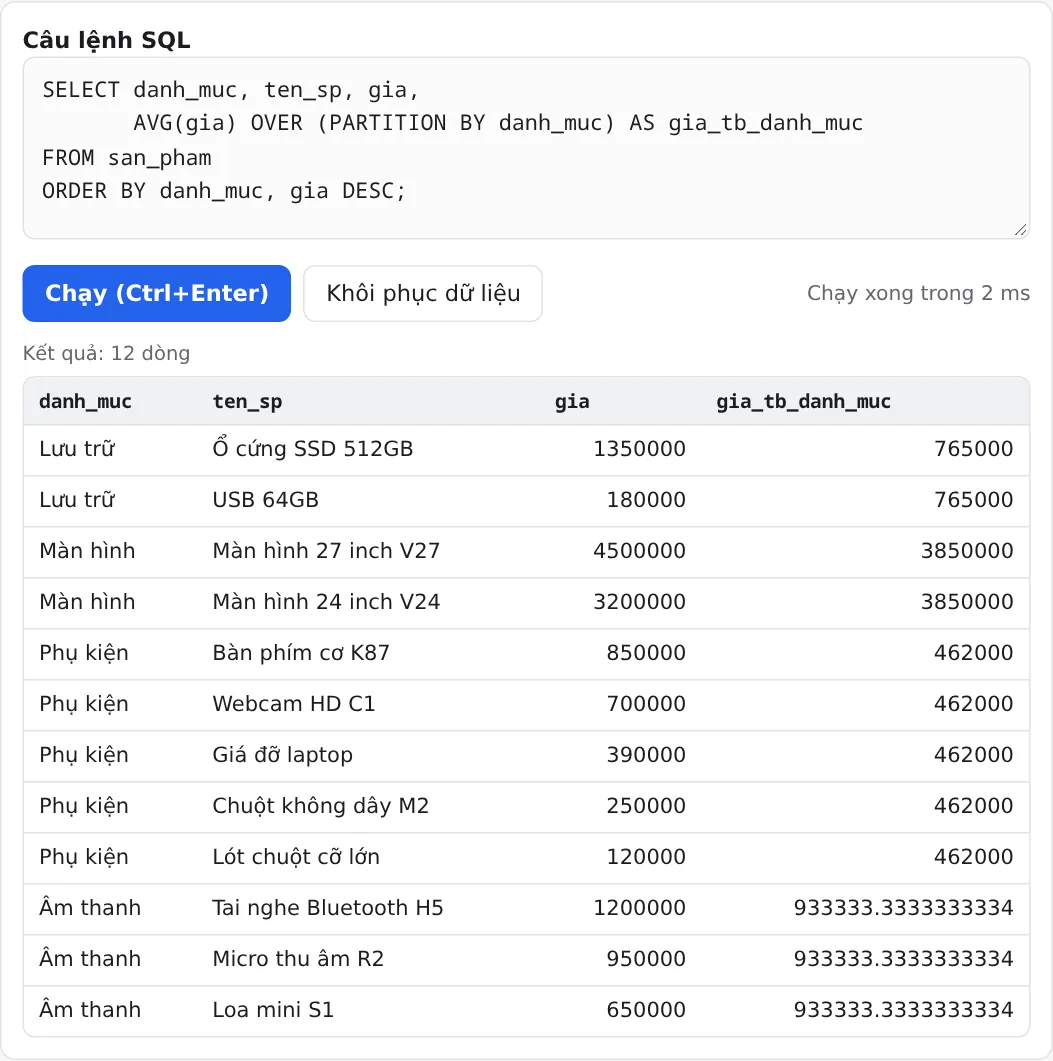
Cú pháp chung: HÀM(...) OVER (PARTITION BY ... ORDER BY ...).
OVER (...)là dấu hiệu nhận biết window function. Thêm OVER vào sau AVG, SUM, COUNT là chúng thành hàm cửa sổ.PARTITION BY: chia dòng thành từng nhóm, giống GROUP BY nhưng không gộp. Bỏ PARTITION BY thì cả bảng là một cửa sổ.ORDER BYtrong OVER: thứ tự dòng bên trong cửa sổ, cần cho đánh số, xếp hạng, cộng dồn.
Nhìn dòng Phụ kiện: giá trung bình 462.000, Bàn phím cơ và Webcam cao hơn mức này. Đây chính là bài tập 2 của bài 4, giờ không cần subquery tương quan. Với Âm thanh, trung bình là 933333.33. Khác biệt SQL Server: cột giá kiểu INT thì AVG trả về số nguyên (933333), như đã nói ở bài 2.
ROW_NUMBER: đánh số thứ tự trong từng nhóm
Mỗi đơn là đơn thứ mấy của khách đó? Đánh số theo ngày đặt, đếm lại từ 1 cho mỗi khách:
SELECT khach_hang_id, id AS ma_don, ngay_dat,
       ROW_NUMBER() OVER (
         PARTITION BY khach_hang_id ORDER BY ngay_dat
       ) AS don_thu
FROM don_hang
WHERE khach_hang_id IN (1, 2, 3)
ORDER BY khach_hang_id, ngay_dat;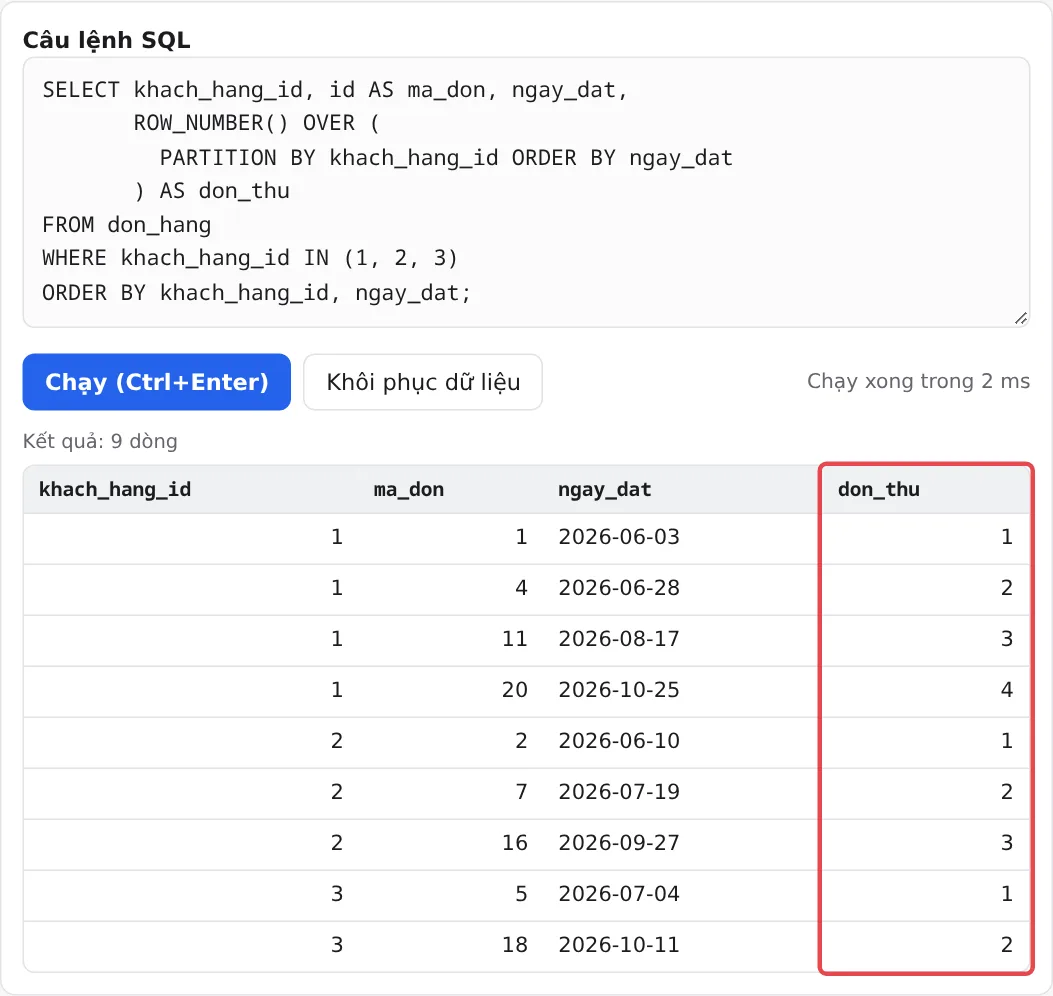
Ứng dụng: tìm đơn đầu tiên của mỗi khách (don_thu = 1), tính xem khách quay lại mua lần 2 sau bao lâu. SQL Server: ROW_NUMBER có từ SQL Server 2005, cú pháp giống hệt.
ROW_NUMBER, RANK, DENSE_RANK: xử lý đồng hạng
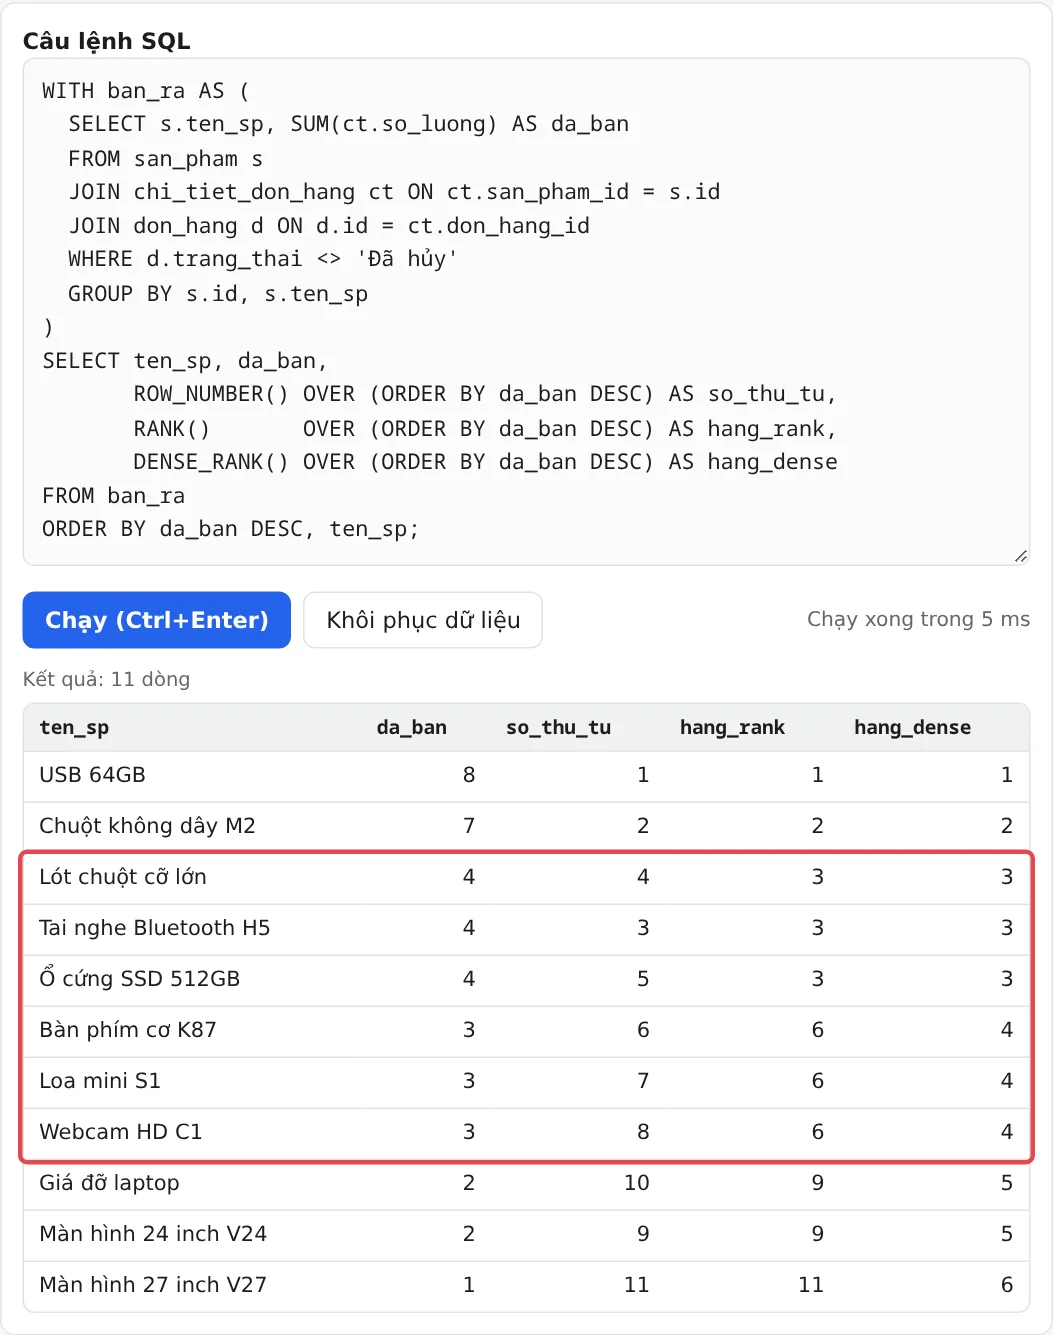
Ba hàm này đều đánh số theo thứ tự, chỉ khác nhau khi có giá trị bằng nhau. Xếp hạng sản phẩm theo số lượng đã bán:
WITH ban_ra AS (
  SELECT s.ten_sp, SUM(ct.so_luong) AS da_ban
  FROM san_pham s
  JOIN chi_tiet_don_hang ct ON ct.san_pham_id = s.id
  JOIN don_hang d ON d.id = ct.don_hang_id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY s.id, s.ten_sp
)
SELECT ten_sp, da_ban,
       ROW_NUMBER() OVER (ORDER BY da_ban DESC) AS so_thu_tu,
       RANK()       OVER (ORDER BY da_ban DESC) AS hang_rank,
       DENSE_RANK() OVER (ORDER BY da_ban DESC) AS hang_dense
FROM ban_ra
ORDER BY da_ban DESC, ten_sp;| Hàm | Khi đồng hạng | Ví dụ trong ảnh (bán 4 cái, rồi bán 3 cái) |
|---|---|---|
ROW_NUMBER | Vẫn đánh số khác nhau, không bao giờ trùng | 3, 4, 5 rồi 6, 7, 8 |
RANK | Cùng hạng, hạng sau nhảy cóc | 3, 3, 3 rồi 6, 6, 6 |
DENSE_RANK | Cùng hạng, hạng sau liền mạch | 3, 3, 3 rồi 4, 4, 4 |
Nhìn kỹ cột so_thu_tu: "Lót chuột" được số 4 còn "Tai nghe" được số 3, ngược với thứ tự hiển thị. Khi các dòng bằng nhau, ROW_NUMBER đánh số theo thứ tự tùy ý, chạy lại hoặc đổi hệ quản trị có thể ra khác. Muốn ổn định, thêm cột phụ vào ORDER BY trong OVER, ví dụ ROW_NUMBER() OVER (ORDER BY da_ban DESC, ten_sp).
Chọn hàm nào? Thi đấu, bảng xếp hạng có đồng hạng: RANK. Đếm "có bao nhiêu mức khác nhau": DENSE_RANK. Cần đúng 1 dòng mỗi nhóm (lấy top 1, khử trùng lặp): ROW_NUMBER. SQL Server: cả ba hàm có từ SQL Server 2005.
SUM OVER: cộng dồn và tỷ lệ phần trăm
Doanh thu theo tháng, kèm lũy kế từ đầu kỳ và tỷ lệ mỗi tháng so với tổng:
WITH theo_thang AS (
  SELECT strftime('%Y-%m', d.ngay_dat) AS thang,
         SUM(ct.so_luong * ct.don_gia) AS doanh_thu
  FROM don_hang d
  JOIN chi_tiet_don_hang ct ON ct.don_hang_id = d.id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY strftime('%Y-%m', d.ngay_dat)
)
SELECT thang, doanh_thu,
       SUM(doanh_thu) OVER (ORDER BY thang) AS luy_ke,
       ROUND(doanh_thu * 100.0 / SUM(doanh_thu) OVER (), 1) AS phan_tram
FROM theo_thang
ORDER BY thang;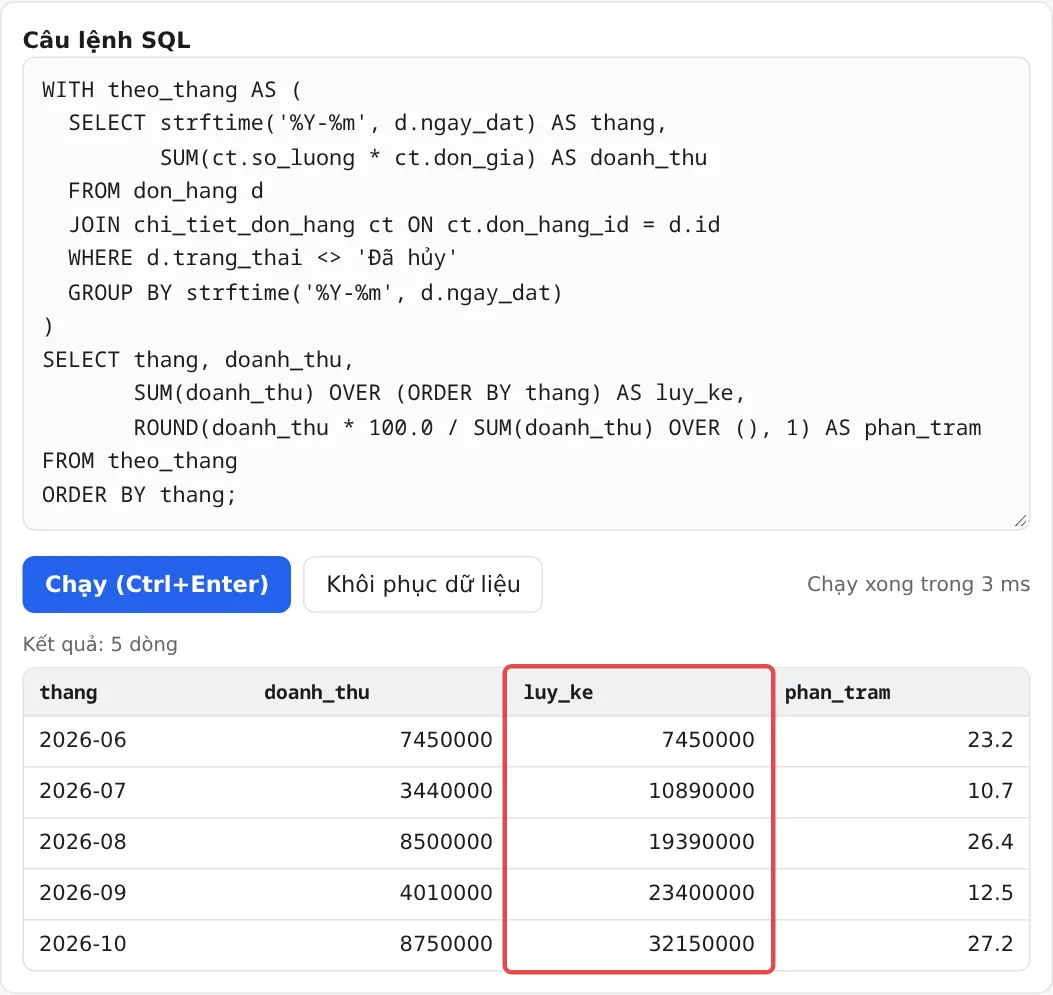
SUM(doanh_thu) OVER (ORDER BY thang): có ORDER BY nên SUM chỉ cộng từ dòng đầu đến dòng hiện tại, ra số lũy kế.SUM(doanh_thu) OVER (): OVER rỗng nghĩa là cửa sổ là cả bảng, ra tổng 32.150.000 trên mọi dòng. Chia cho tổng là ra tỷ lệ. Nhân100.0chứ không phải100để tránh phép chia số nguyên (cả SQLite và SQL Server đều cắt phần thập phân khi chia hai số nguyên).
Một chi tiết nâng cao: khi có ORDER BY trong OVER mà không ghi khung cửa sổ, mặc định (ở cả SQLite và SQL Server) là RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW. Nếu cột ORDER BY có giá trị trùng nhau, các dòng trùng được cộng cùng lúc và có cùng số lũy kế. Ở đây mỗi tháng là duy nhất nên không gặp. Muốn cộng từng dòng một, ghi rõ ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW.
Khác biệt SQL Server: SUM OVER có ORDER BY (cộng dồn) cần SQL Server 2012 trở lên. Và nhắc lại từ bài 4: strftime chỉ có trên SQLite.
LAG: so sánh với dòng trước
Tháng này tăng hay giảm bao nhiêu so với tháng trước? LAG(cot) lấy giá trị của dòng ngay trước trong cửa sổ:
WITH theo_thang AS (
  SELECT strftime('%Y-%m', d.ngay_dat) AS thang,
         SUM(ct.so_luong * ct.don_gia) AS doanh_thu
  FROM don_hang d
  JOIN chi_tiet_don_hang ct ON ct.don_hang_id = d.id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY strftime('%Y-%m', d.ngay_dat)
)
SELECT thang, doanh_thu,
       LAG(doanh_thu) OVER (ORDER BY thang) AS thang_truoc,
       doanh_thu - LAG(doanh_thu) OVER (ORDER BY thang) AS chenh_lech
FROM theo_thang
ORDER BY thang;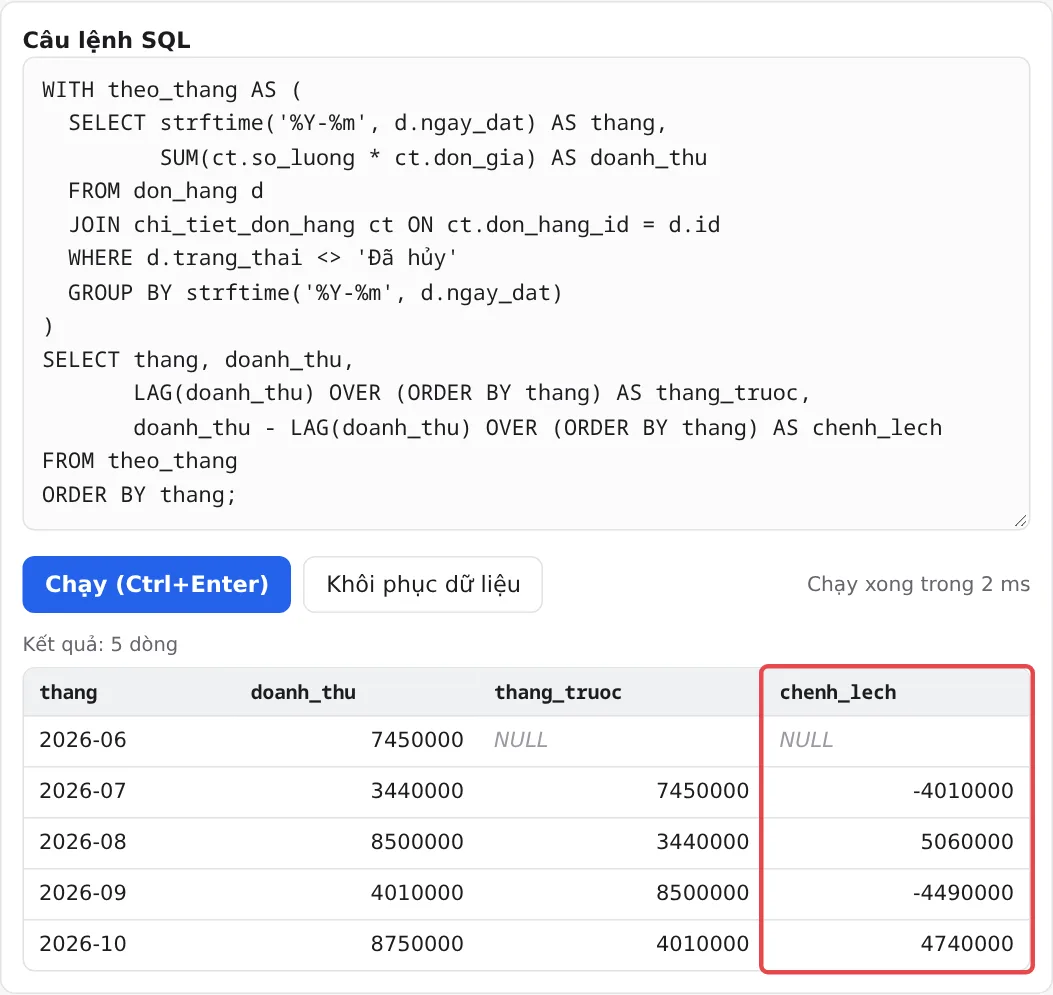
Doanh thu cửa hàng giả lập này lên xuống xen kẽ: tháng 7 giảm 4.010.000, tháng 8 tăng 5.060.000. Dòng đầu tiên không có dòng trước nên LAG trả về NULL, kéo theo chênh lệch cũng NULL. Hàm ngược lại là LEAD (lấy dòng sau). SQL Server: LAG và LEAD có từ SQL Server 2012.
Lấy top N mỗi nhóm: ROW_NUMBER trong CTE
Đây là bài toán gặp rất nhiều trong phỏng vấn: sản phẩm có doanh thu cao nhất của mỗi danh mục. Ý đầu tiên của nhiều người là lọc thẳng trong WHERE:
SELECT ten_sp, danh_muc, gia,
       ROW_NUMBER() OVER (PARTITION BY danh_muc ORDER BY gia DESC) AS rn
FROM san_pham
WHERE ROW_NUMBER() OVER (PARTITION BY danh_muc ORDER BY gia DESC) = 1;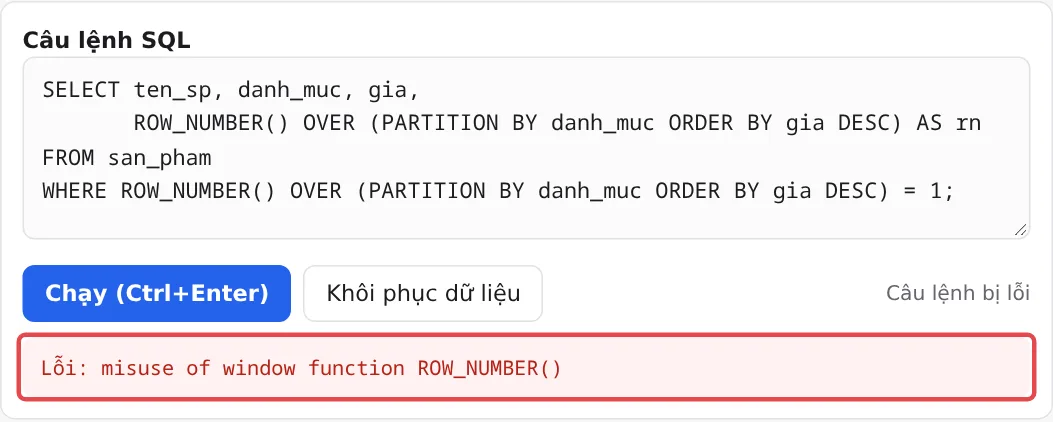
Nhớ lại thứ tự xử lý ở bài 2: WHERE chạy trước SELECT, còn window function được tính ở bước SELECT. Lúc WHERE chạy, ROW_NUMBER chưa tồn tại. Cách đúng: tính ROW_NUMBER trong một CTE, rồi lọc ở câu ngoài:
WITH xep_hang AS (
  SELECT s.danh_muc, s.ten_sp,
         SUM(ct.so_luong * ct.don_gia) AS doanh_thu,
         ROW_NUMBER() OVER (
           PARTITION BY s.danh_muc
           ORDER BY SUM(ct.so_luong * ct.don_gia) DESC
         ) AS rn
  FROM san_pham s
  JOIN chi_tiet_don_hang ct ON ct.san_pham_id = s.id
  JOIN don_hang d ON d.id = ct.don_hang_id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY s.danh_muc, s.id, s.ten_sp
)
SELECT danh_muc, ten_sp, doanh_thu
FROM xep_hang
WHERE rn = 1
ORDER BY doanh_thu DESC;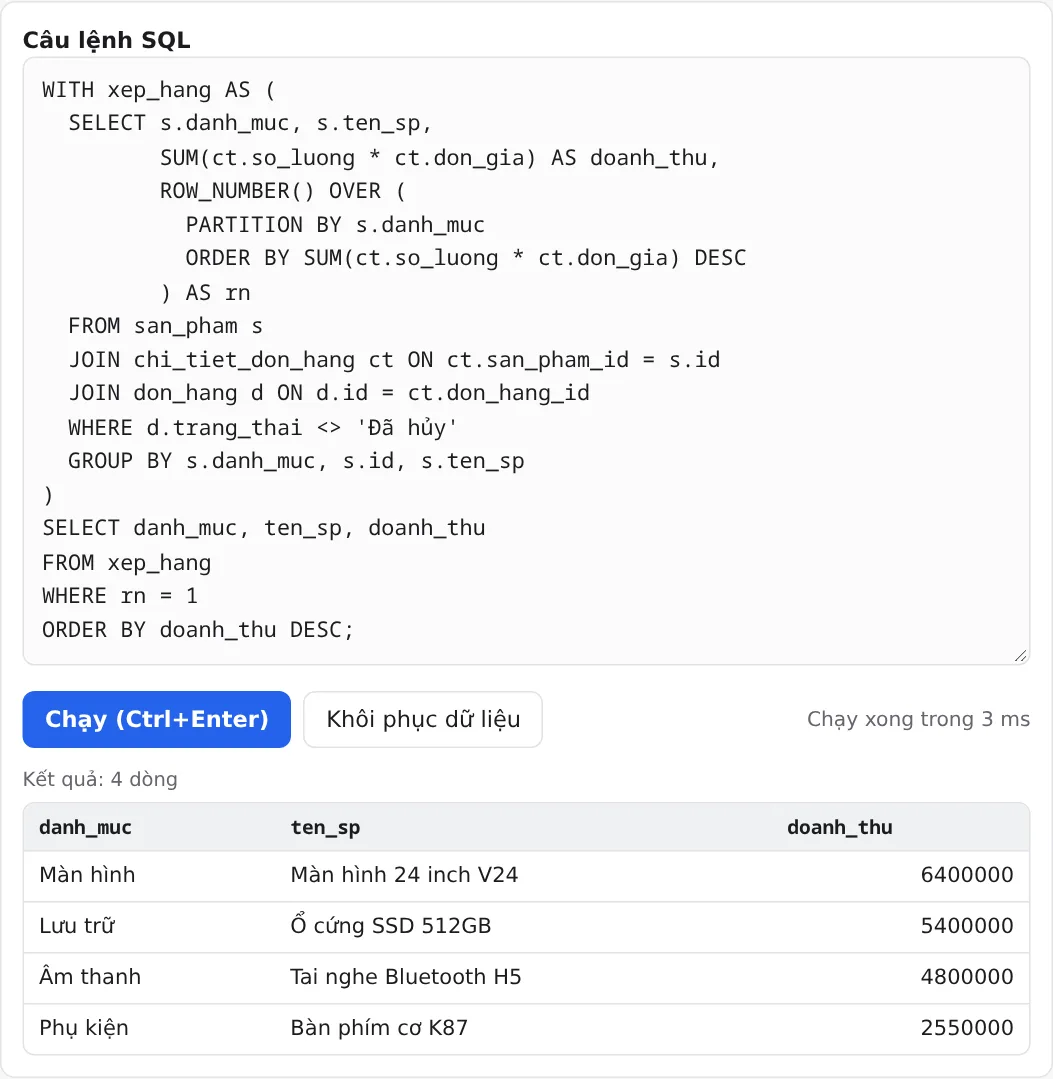
rn = 1 thành rn <= 2 là ra top 2.Câu này kết hợp gần đủ những gì đã học: JOIN 3 bảng, WHERE bỏ đơn hủy, GROUP BY theo sản phẩm, window function chạy sau GROUP BY (nên trong ORDER BY của OVER dùng được SUM(...)), CTE để lọc kết quả. Thú vị là màn hình 24 inch dẫn đầu dù rẻ hơn màn hình 27 inch, vì bán được 2 cái. Nếu hai sản phẩm có thể bằng doanh thu và bạn muốn giữ cả hai, đổi ROW_NUMBER thành RANK.
Những lỗi hay gặp
- Dùng window function trong WHERE hoặc HAVING: báo lỗi, phải bọc trong CTE hoặc subquery như trên.
- ROW_NUMBER với giá trị trùng mà không có cột phụ: kết quả "top 1" có thể đổi giữa các lần chạy.
- Quên PARTITION BY: đánh số liên tục trên cả bảng thay vì đếm lại cho mỗi nhóm.
- Nhầm ORDER BY trong OVER với ORDER BY cuối câu: cái trong OVER quyết định cách đánh số hay cộng dồn, cái cuối câu quyết định thứ tự hiển thị. Hai cái độc lập, thường bạn cần cả hai.
- Chia số nguyên khi tính phần trăm:
doanh_thu * 100 / tongtrên hai cột số nguyên sẽ bị cắt phần thập phân. Dùng100.0.
Bài tập tổng hợp cả series
Ba bài dưới đây cần kết hợp kiến thức của cả 5 bài. Hãy tự viết trên trang thực hành trước khi mở đáp án.
- Ở mỗi thành phố, khách nào chi tiêu nhiều nhất (không tính đơn hủy)? Nếu đồng hạng thì hiện tất cả.
- Với mỗi khách đã từng đặt hàng, cho biết đơn gần nhất: mã đơn, ngày đặt, trạng thái. Sắp xếp đơn mới nhất lên đầu.
- Doanh thu theo danh mục sản phẩm và tỷ lệ phần trăm của mỗi danh mục trên tổng doanh thu.
Xem đáp án bài 1 (đã chạy thử)
WITH chi_tieu AS (
  SELECT k.thanh_pho, k.ho_ten,
         SUM(ct.so_luong * ct.don_gia) AS tong
  FROM khach_hang k
  JOIN don_hang d ON d.khach_hang_id = k.id
  JOIN chi_tiet_don_hang ct ON ct.don_hang_id = d.id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY k.id, k.thanh_pho, k.ho_ten
),
xep_hang AS (
  SELECT *, RANK() OVER (PARTITION BY thanh_pho ORDER BY tong DESC) AS hang
  FROM chi_tieu
)
SELECT thanh_pho, ho_ten, tong
FROM xep_hang
WHERE hang = 1
ORDER BY tong DESC;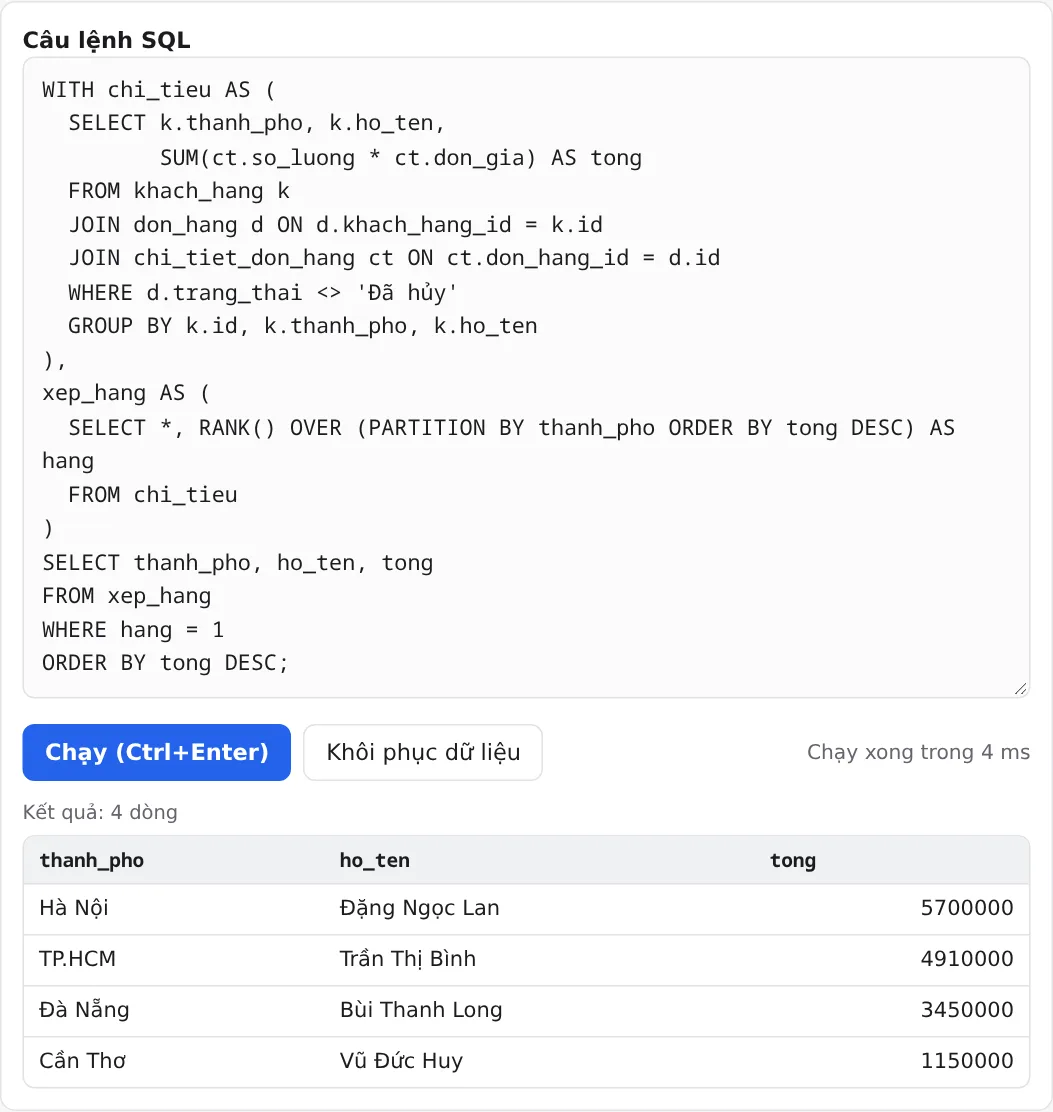
Dùng RANK chứ không phải ROW_NUMBER vì đề yêu cầu giữ cả những người đồng hạng. Hải Phòng vắng mặt do INNER JOIN bỏ khách chưa mua. Nếu muốn Hải Phòng hiện với tổng 0, bạn cần LEFT JOIN như bài 3 (và cẩn thận đặt điều kiện đơn hủy vào ON).
Xem đáp án bài 2 (đã chạy thử)
WITH don_xep AS (
  SELECT d.khach_hang_id, d.id, d.ngay_dat, d.trang_thai,
         ROW_NUMBER() OVER (
           PARTITION BY d.khach_hang_id ORDER BY d.ngay_dat DESC
         ) AS rn
  FROM don_hang d
)
SELECT k.ho_ten, x.id AS ma_don, x.ngay_dat, x.trang_thai
FROM don_xep x
JOIN khach_hang k ON k.id = x.khach_hang_id
WHERE x.rn = 1
ORDER BY x.ngay_dat DESC;| ho_ten | ma_don | ngay_dat | trang_thai |
|---|---|---|---|
| Nguyễn Văn An | 20 | 2026-10-25 | Đang giao |
| Đỗ Mai Phương | 19 | 2026-10-18 | Đang giao |
| Lê Minh Châu | 18 | 2026-10-11 | Đang giao |
| Đặng Ngọc Lan | 17 | 2026-10-03 | Hoàn thành |
| Trần Thị Bình | 16 | 2026-09-27 | Hoàn thành |
| Lý Thảo Vy | 15 | 2026-09-20 | Hoàn thành |
| Phạm Quốc Dũng | 14 | 2026-09-12 | Đã hủy |
| Hoàng Thu Hà | 13 | 2026-09-05 | Hoàn thành |
| Bùi Thanh Long | 10 | 2026-08-09 | Hoàn thành |
| Vũ Đức Huy | 9 | 2026-08-02 | Hoàn thành |
Đây là mẫu "lấy 1 dòng mỗi nhóm" kinh điển: PARTITION BY theo khách, ORDER BY ngày giảm dần, giữ rn = 1. Đề không nói bỏ đơn hủy nên đơn 14 của anh Dũng vẫn được tính là đơn gần nhất.
Xem đáp án bài 3 (đã chạy thử)
WITH theo_danh_muc AS (
  SELECT s.danh_muc, SUM(ct.so_luong * ct.don_gia) AS doanh_thu
  FROM chi_tiet_don_hang ct
  JOIN san_pham s ON s.id = ct.san_pham_id
  JOIN don_hang d ON d.id = ct.don_hang_id
  WHERE d.trang_thai <> 'Đã hủy'
  GROUP BY s.danh_muc
)
SELECT danh_muc, doanh_thu,
       ROUND(doanh_thu * 100.0 / SUM(doanh_thu) OVER (), 1) AS phan_tram
FROM theo_danh_muc
ORDER BY doanh_thu DESC;| danh_muc | doanh_thu | phan_tram |
|---|---|---|
| Màn hình | 10900000 | 33.9 |
| Phụ kiện | 7660000 | 23.8 |
| Lưu trữ | 6840000 | 21.3 |
| Âm thanh | 6750000 | 21 |
Bốn tỷ lệ cộng lại đúng 100. Trang thực hành hiển thị 21.0 thành 21. Màn hình chỉ bán 3 cái nhưng chiếm hơn một phần ba doanh thu, một nhận xét đáng đưa vào báo cáo.
Tổng kết series: SQLite và SQL Server khác nhau ở đâu?
Qua 5 bài, đây là những điểm khác biệt mình đã gặp và ghi chú. Nếu bạn học trên SQL Server, hãy lưu bảng này lại:
| Việc | SQLite (trang thực hành) | SQL Server |
|---|---|---|
| Lấy N dòng đầu | LIMIT 5, LIMIT 4 OFFSET 4 | TOP 5, OFFSET 4 ROWS FETCH NEXT 4 ROWS ONLY (2012+) |
| Chuỗi tiếng Việt | 'Hà Nội' | N'Hà Nội' với cột NVARCHAR |
Chuỗi trong nháy kép "..." | Thường vẫn chạy (coi là chuỗi) | Bị hiểu là tên cột, báo lỗi |
| Cột không có trong GROUP BY | Chạy, ra giá trị tùy ý | Báo lỗi |
| Bí danh trong WHERE, HAVING | Chạy được | Báo lỗi, phải viết lại biểu thức |
| AVG cột số nguyên | Ra số thực | Ra số nguyên |
| JOIN thiếu ON | Thành tích Descartes | Báo lỗi cú pháp |
| Subquery trong FROM thiếu bí danh | Chạy được | Báo lỗi |
| Subquery trả nhiều dòng khi cần 1 giá trị | Lấy dòng đầu, không báo | Báo lỗi |
| CTE đệ quy | WITH RECURSIVE | WITH |
| Lấy năm-tháng | strftime('%Y-%m', ngay) | FORMAT(ngay, 'yyyy-MM'), YEAR(), MONTH() |
Để ý một xu hướng: SQLite "dễ dãi", nhiều câu sai vẫn chạy và ra kết quả trông hợp lý. SQL Server chặt chẽ hơn và báo lỗi. Nếu thực hành trên SQLite rồi nộp bài trên SQL Server, những dòng trong bảng trên là chỗ bạn hay bị trừ điểm nhất.
Nhìn lại cả series:
- Bài 1: SQL là gì? Truy vấn đầu tiên với SELECT và WHERE: lấy cột, lọc dòng, AND/OR, LIKE, IN, NULL.
- Bài 2: ORDER BY, LIMIT, hàm gộp và GROUP BY, HAVING: sắp xếp, đếm, tổng, trung bình theo nhóm.
- Bài 3: JOIN, nối nhiều bảng với INNER JOIN và LEFT JOIN: ghép bảng, tìm dòng không khớp, bẫy WHERE và ON.
- Bài 4: Subquery và CTE (WITH): chia truy vấn khó thành nhiều bước.
- Bài 5 (bài này): window function và bài tập tổng hợp.
Bạn có thể xem toàn bộ series ở trang SQL từ cơ bản đến nâng cao. Bước tiếp theo nên học là làm sao cho truy vấn chạy nhanh trên bảng lớn, bắt đầu từ index: mình có bài Giới thiệu về Index trong SQL Server. Còn cách học hiệu quả nhất vẫn là tự đặt câu hỏi cho dữ liệu cửa hàng trên trang thực hành ("khách nào mua nhiều danh mục nhất?", "tuần nào trong tháng bán chạy nhất?") rồi viết SQL để trả lời. Chúc bạn học tốt.
