Chuyển giọng nói thành văn bản tiếng Việt miễn phí bằng Whisper (2026)
Trong bài này
- Cần chuẩn bị
- Bước 1: Hiểu Whisper và faster-whisper
- Bước 2: Cài faster-whisper
- Bước 3: Chuẩn bị file âm thanh tiếng Việt
- Bước 4: Chạy nhận dạng lần đầu với model small
- Bước 5: So sánh 5 model để chọn cho máy của mình
- Bước 6: Đọc kỹ các lỗi của model tốt nhất
- Bước 7: Xuất phụ đề .srt cho video
- Lỗi thường gặp
- Lỗi 1: TypeError: open() got an unexpected keyword argument 'metadata_errors'
- Lỗi 2: Whisper "bịa" ra câu không có trong file
- Lỗi 3: Bật VAD thì mất hẳn một câu
- Câu hỏi thường gặp
- Có cần mạng Internet mỗi lần chạy không?
- Có dùng được file mp3 hoặc file ghi âm điện thoại không?
- Máy không có card đồ họa thì nên chọn model nào?
- Có cần chỉ định language="vi" không?
- Dùng kết quả này để nộp bài có ổn không?
- Nguồn tham khảo
Ghi âm buổi học, phỏng vấn hay video thuyết trình rồi ngồi gõ lại từng câu rất mất thời gian. Trong bài này mình hướng dẫn các bạn dùng Whisper (model nhận dạng giọng nói mã nguồn mở của OpenAI) qua thư viện Python faster-whisper để chuyển giọng nói thành văn bản tiếng Việt và xuất file phụ đề .srt, chạy ngay trên CPU, không cần GPU hay tài khoản nào. Làm theo mất khoảng 20–30 phút, phần lớn là thời gian tải model.
Mọi số liệu trong bài là kết quả mình chạy thật ngày 19/11/2026 với faster-whisper 1.2.1, Python 3.12 trên Linux, giới hạn 4 nhân CPU và 6 GB RAM.
Cần chuẩn bị
- Máy tính có Python 3.10 trở lên (Windows, macOS hay Linux đều được). Không cần card đồ họa.
- Khoảng 2–3 GB dung lượng trống nếu muốn thử cả model lớn (model
large-v3-turbonặng 1,6 GB). - Kết nối mạng ở lần chạy đầu để tải model. Các lần sau dùng lại bản đã tải.
- Một file ghi âm tiếng Việt (wav, mp3…). Nếu chưa có, bài này dùng file mẫu công khai, xem bước 3.
- Tùy chọn:
ffmpegđể chỉnh âm lượng (dùng ở phần Lỗi thường gặp).
Bước 1: Hiểu Whisper và faster-whisper
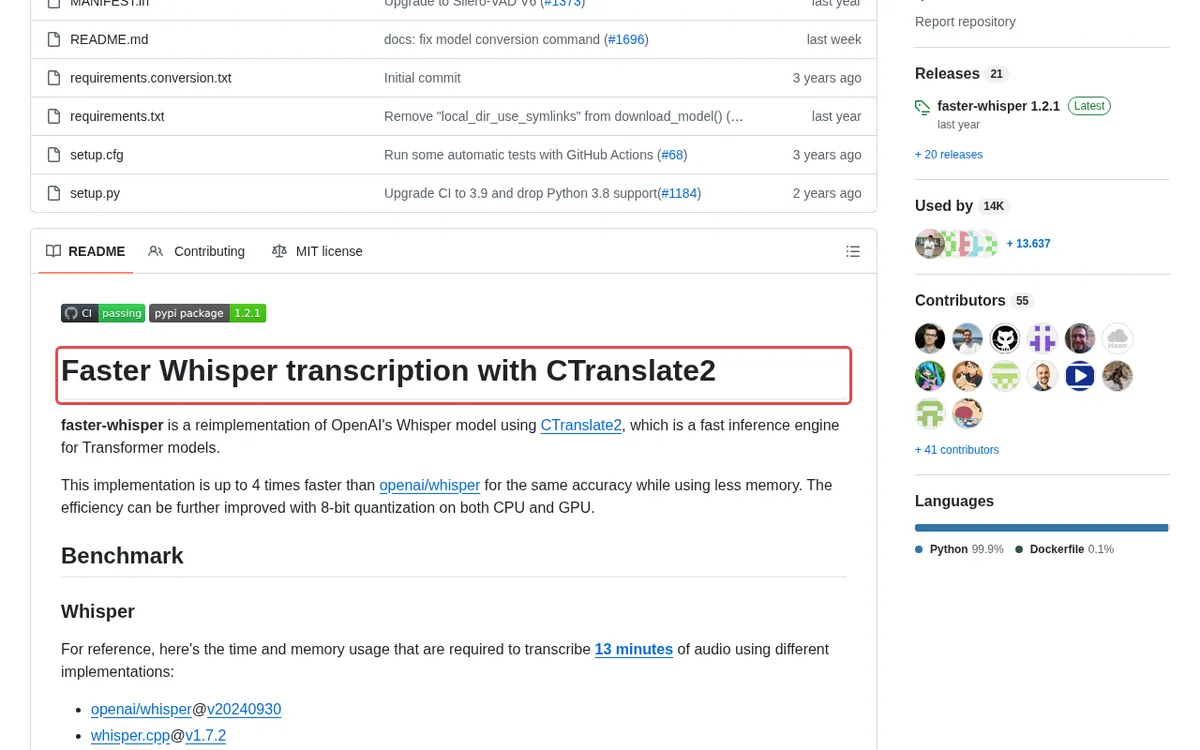
Whisper là model nhận dạng giọng nói đa ngôn ngữ (có tiếng Việt) do OpenAI công bố, mã nguồn và trọng số dùng giấy phép MIT. faster-whisper là bản viết lại dùng thư viện CTranslate2, theo README của dự án thì nhanh hơn bản gốc tới 4 lần với cùng độ chính xác và tốn ít bộ nhớ hơn, lại hỗ trợ lượng tử hóa 8-bit (int8) để chạy tốt trên CPU. Vì vậy mình chọn faster-whisper cho máy sinh viên.
Bước 2: Cài faster-whisper
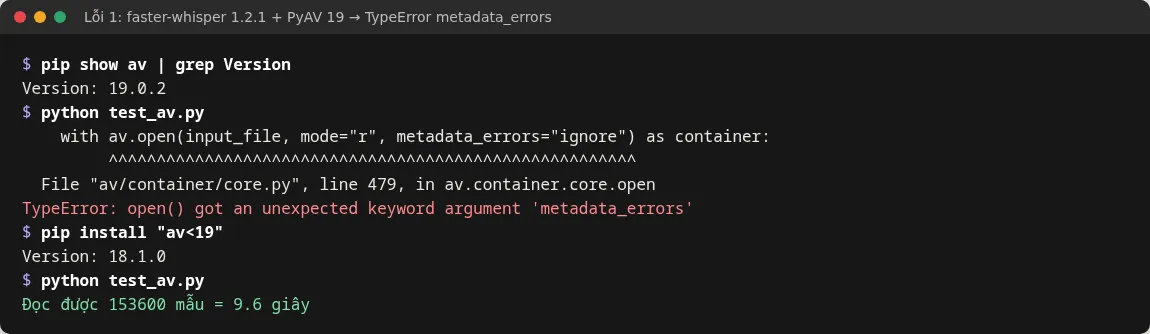
Tạo môi trường ảo rồi cài thư viện. Lưu ý mình ghi thêm "av<19": bản faster-whisper 1.2.1 đang có trên PyPI chưa chạy được với PyAV 19 (lỗi ở phần Lỗi thường gặp), nên phải giữ PyAV ở bản 18.
python -m venv venv2
source venv2/bin/activate        # Windows: venv2\Scripts\activate
pip install faster-whisper "av<19"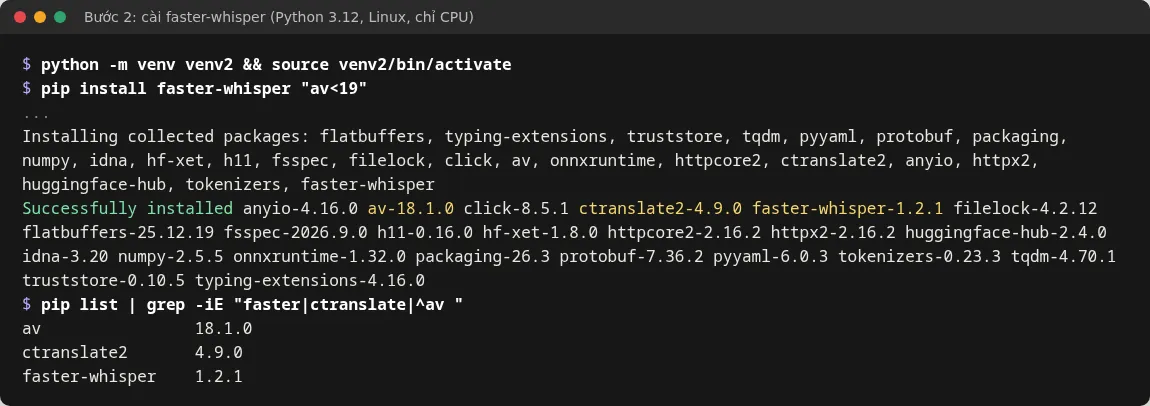
Bước 3: Chuẩn bị file âm thanh tiếng Việt
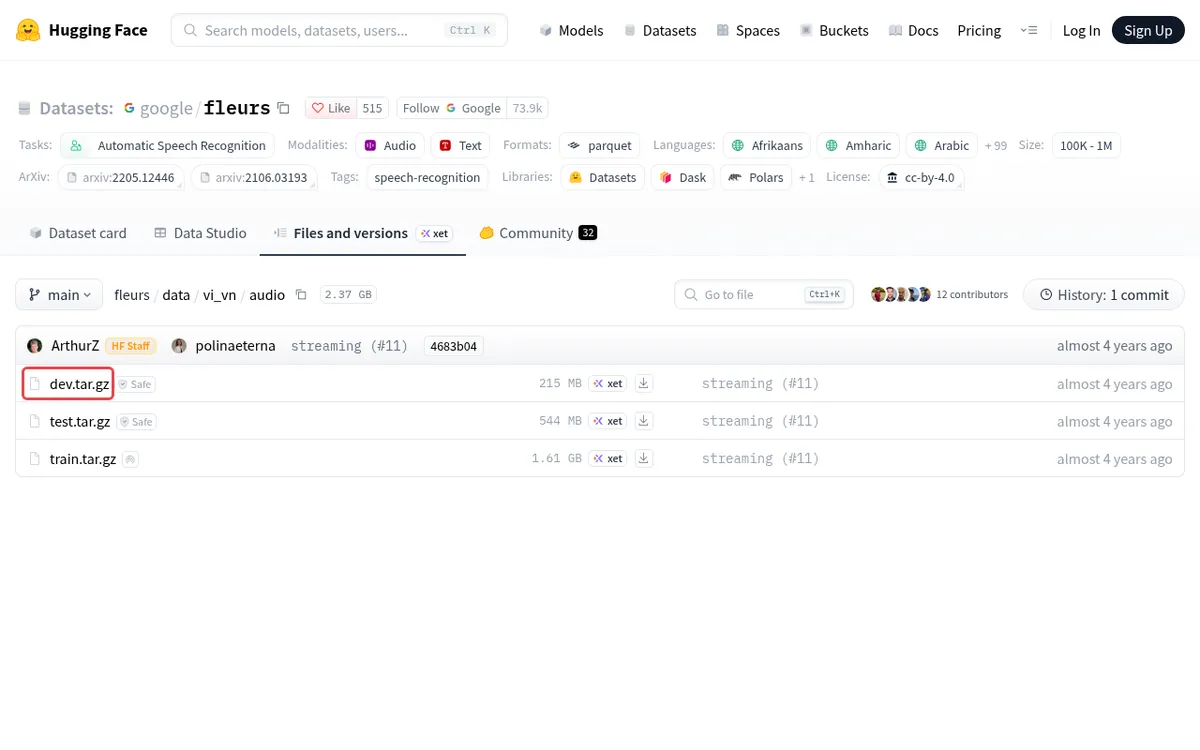
Để đo được độ chính xác, mình cần âm thanh có sẵn câu gốc. Mình lấy 8 câu tiếng Việt (giọng nam, mỗi câu 7–14 giây) trong tập dev của bộ dữ liệu Google FLEURS trên Hugging Face (giấy phép CC BY 4.0), rồi ghép thành một file ghep-8-cau.wav dài 87,9 giây, giữa các câu có 0,8 giây im lặng. Các bạn có thể thay bằng file ghi âm của mình.
Bước 4: Chạy nhận dạng lần đầu với model small
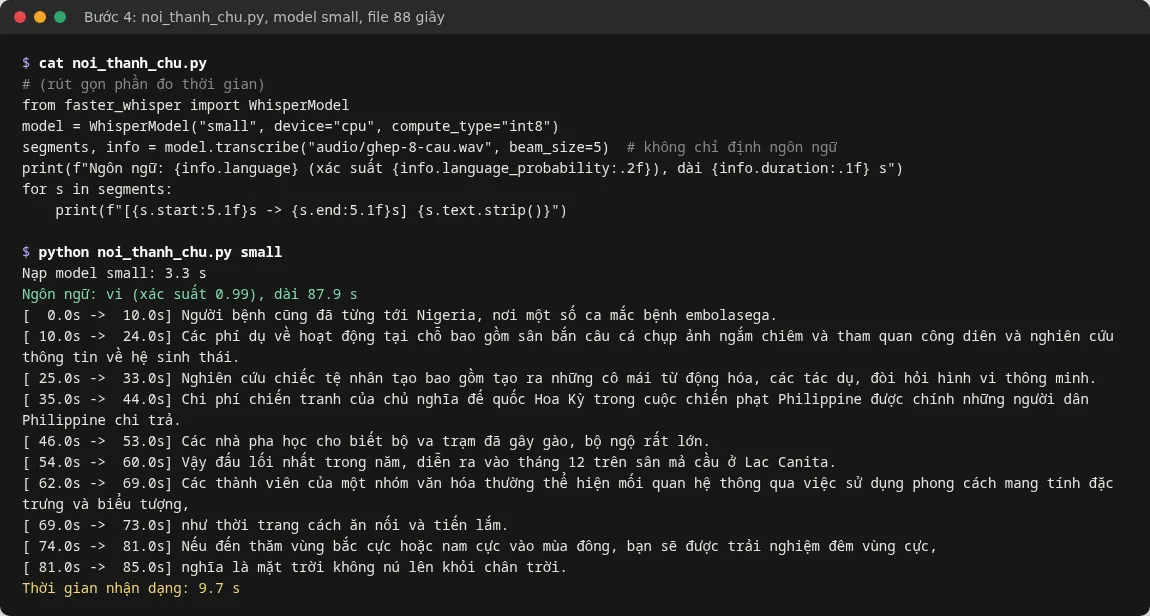
Đoạn code dưới đây nạp model, để Whisper tự nhận ngôn ngữ rồi in từng đoạn kèm mốc thời gian. Lần đầu chạy, model tự tải về thư mục cache của Hugging Face.
from faster_whisper import WhisperModel

model = WhisperModel("small", device="cpu", compute_type="int8")
segments, info = model.transcribe("audio/ghep-8-cau.wav", beam_size=5)
print(f"Ngôn ngữ: {info.language} (xác suất {info.language_probability:.2f})")
for s in segments:  # segments là generator: vòng lặp này mới thực sự chạy nhận dạng
    print(f"[{s.start:5.1f}s -> {s.end:5.1f}s] {s.text.strip()}")
Kết quả: Whisper nhận đúng tiếng Việt (xác suất 0,99) và xử lý 88 giây âm thanh trong 9,7 giây. Câu chữ đọc hiểu được nhưng còn nhiều lỗi dấu và từ đồng âm, ví dụ "các phí dụ" thay vì "các ví dụ".
Bước 5: So sánh 5 model để chọn cho máy của mình
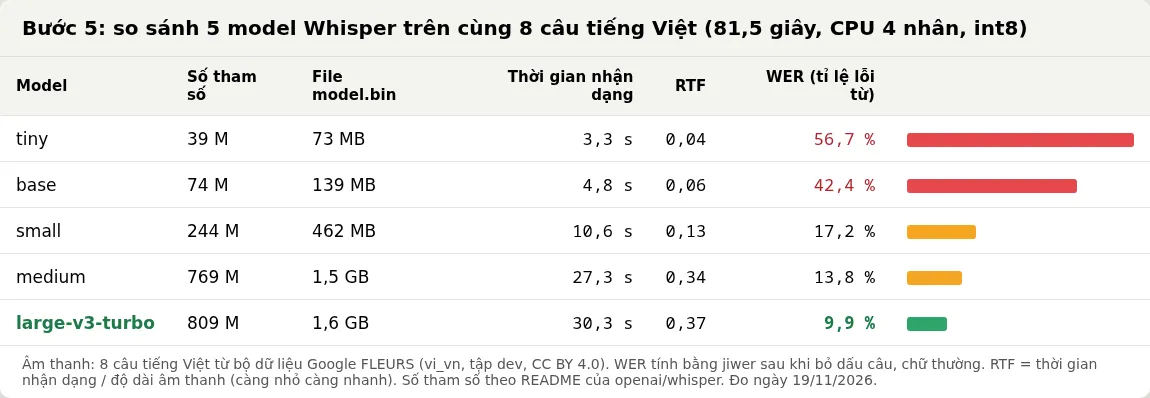
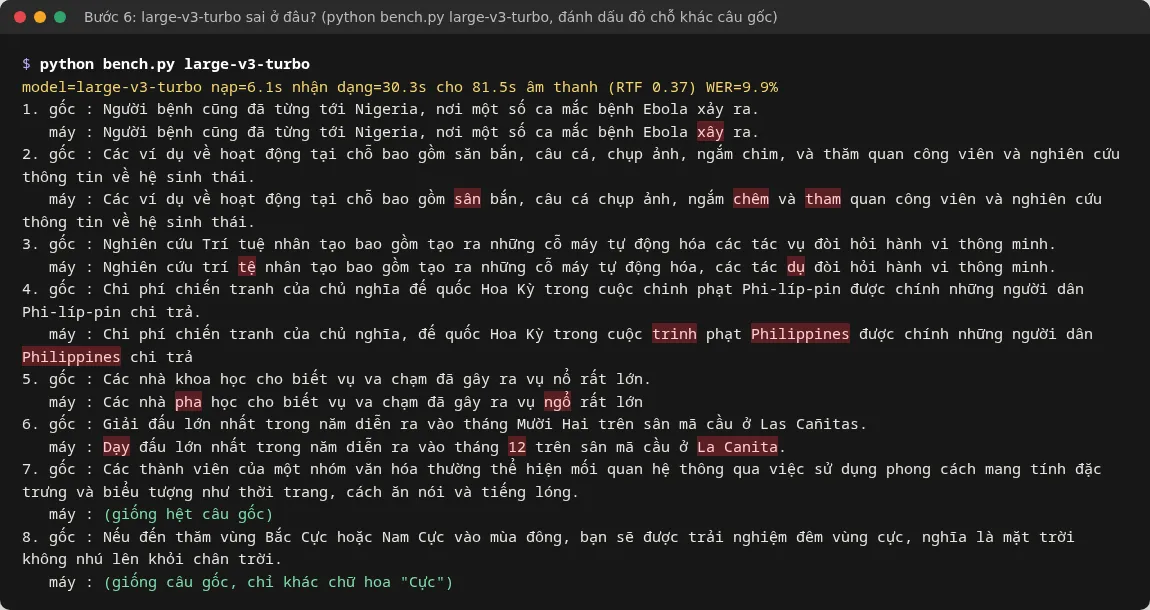
Mình viết thêm script bench.py chạy lần lượt 5 model trên đúng 8 câu đó (chỉ định language="vi") và tính WER (tỉ lệ lỗi từ, càng thấp càng tốt) bằng thư viện jiwer. Model large-v3-turbo sai 9,9% số từ và chạy mất 30 giây cho 81,5 giây âm thanh. tiny và base rất nhanh nhưng sai 42–57% số từ, gần như không dùng được cho tiếng Việt.
pip install jiwer
python bench.py tiny
python bench.py large-v3-turboGợi ý của mình: máy yếu hoặc cần kết quả nhanh thì dùng small, cần chữ chính xác để nộp bài hay làm phụ đề thì dùng large-v3-turbo. Đáng chú ý là turbo còn nhanh gần bằng medium mà lại ít lỗi hơn.
Bước 6: Đọc kỹ các lỗi của model tốt nhất
WER 9,9% nghe thấp nhưng các bạn vẫn phải đọc lại. Turbo sai đúng những chỗ tiếng Việt khó: dấu thanh ("xây ra", "sân bắn", "vụ ngổ"), phụ âm gần nhau ("pha học" thay vì "khoa học", "trinh phạt" thay vì "chinh phạt"). Một số "lỗi" thật ra chỉ khác cách viết: máy ghi "tháng 12" còn câu gốc là "tháng Mười Hai", máy ghi "Philippines" còn câu gốc là "Phi-líp-pin", nên WER thực tế còn thấp hơn con số đo được.
Bước 7: Xuất phụ đề .srt cho video
File .srt chỉ là danh sách đoạn có số thứ tự, mốc thời gian dạng giờ:phút:giây,mili giây và nội dung. Đây là định dạng phụ đề phổ biến, các phần mềm dựng video và YouTube đều cho nhập. Mình bật vad_filter=True để bỏ qua đoạn im lặng (lý do ở Lỗi 2).
import sys
from faster_whisper import WhisperModel

vao = sys.argv[1]
ra = "phu-de.srt"

def gio(t):  # 12.345 -> "00:00:12,345"
    ms = int(round(t * 1000))
    h, ms = divmod(ms, 3600000)
    m, ms = divmod(ms, 60000)
    s, ms = divmod(ms, 1000)
    return f"{h:02}:{m:02}:{s:02},{ms:03}"

model = WhisperModel("large-v3-turbo", device="cpu", compute_type="int8")
segments, info = model.transcribe(vao, language="vi", beam_size=5, vad_filter=True)

with open(ra, "w", encoding="utf-8") as f:
    for i, s in enumerate(segments, 1):
        f.write(f"{i}\n{gio(s.start)} --> {gio(s.end)}\n{s.text.strip()}\n\n")
print("Đã ghi", ra)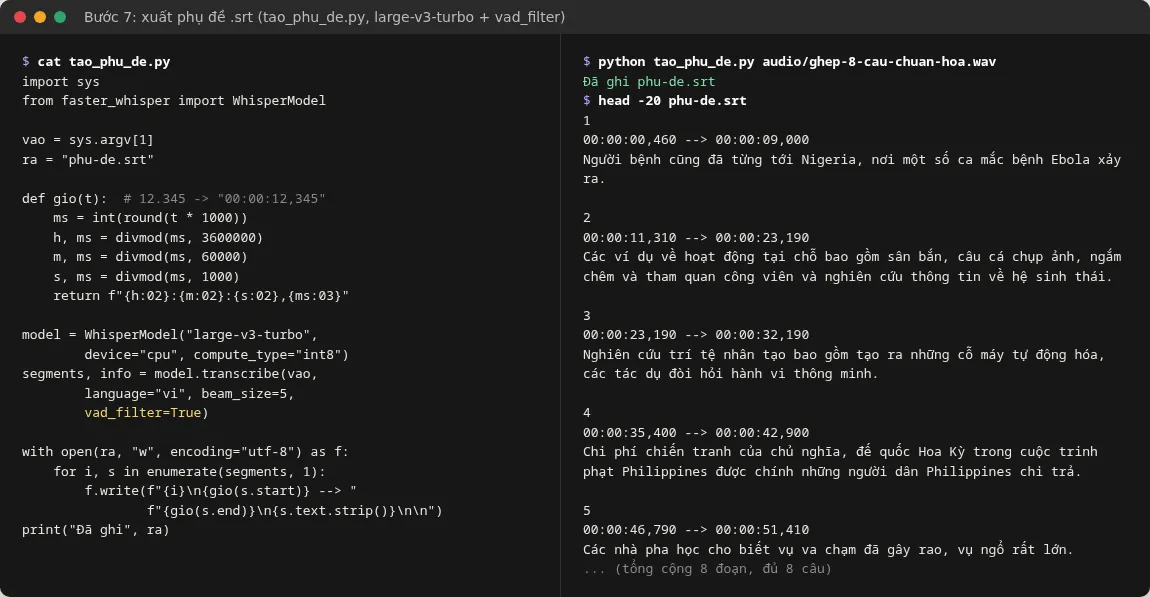
Trước khi đăng video, các bạn mở file .srt ra sửa các từ sai như ở bước 6. Sửa vài chữ vẫn nhanh hơn nhiều so với gõ lại từ đầu.
Lỗi thường gặp
Lỗi 1: TypeError: open() got an unexpected keyword argument 'metadata_errors'
Lỗi này xuất hiện khi pip cài PyAV 19 cùng faster-whisper 1.2.1. Bản 1.2.1 vẫn gọi av.open(..., metadata_errors="ignore"), mà PyAV 19 đã bỏ tham số này. Dự án đã sửa trên GitHub (issue #1589, đóng ngày 03/10/2026) nhưng tới ngày 19/11/2026 bản mới nhất trên PyPI vẫn là 1.2.1. Cách sửa: pip install "av<19".
Lỗi 2: Whisper "bịa" ra câu không có trong file
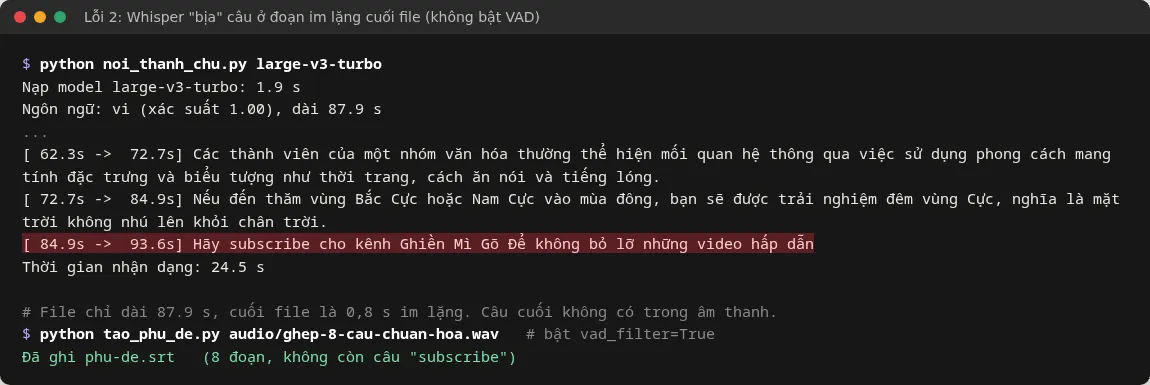
Khi chạy không bật VAD, turbo thêm một câu "Hãy subscribe cho kênh…" ở cuối, với mốc thời gian tới 93,6 giây trong khi file chỉ dài 87,9 giây. Đây là hiện tượng "ảo giác" (hallucination) của Whisper ở đoạn im lặng hoặc nhiễu. Cách sửa: bật vad_filter=True để bộ lọc Silero VAD cắt bỏ phần không có tiếng nói trước khi đưa vào Whisper. Với file của mình, bật VAD là câu này biến mất.
Lỗi 3: Bật VAD thì mất hẳn một câu
Ngược lại, khi bật VAD thì file phụ đề chỉ còn 7 đoạn, mất câu số 7. Mình đo độ lớn âm thanh (RMS) từng câu: câu 7 chỉ 0,0018, nhỏ hơn các câu khác từ 7 đến 17 lần, nên VAD coi phần lớn câu đó là im lặng. Hạ ngưỡng VAD xuống 0,3 không giải quyết được. Cách hiệu quả là cân bằng âm lượng trước bằng ffmpeg, sau đó chạy lại thì đủ 8 câu:
ffmpeg -i audio/ghep-8-cau.wav -af dynaudnorm -ar 16000 -ac 1 audio/ghep-8-cau-chuan-hoa.wav
python tao_phu_de.py audio/ghep-8-cau-chuan-hoa.wav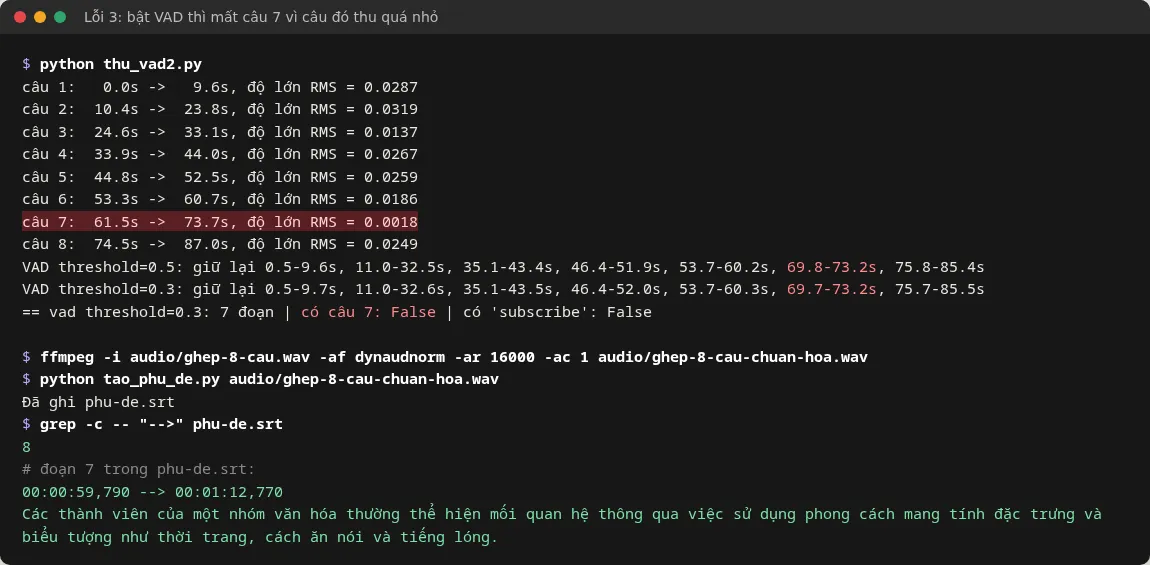
Bài học: sau khi tạo phụ đề, các bạn đếm số đoạn và nghe lướt những chỗ có khoảng trống dài, vì VAD có thể bỏ sót tiếng nói nhỏ mà không báo lỗi.
Câu hỏi thường gặp
Có cần mạng Internet mỗi lần chạy không?
Không. Chỉ lần đầu cần mạng để tải model. Mình đã thử đặt biến môi trường HF_HUB_OFFLINE=1 để chặn kết nối tới Hugging Face, model small vẫn nạp từ cache (0,7 giây) và nhận dạng bình thường.
Có dùng được file mp3 hoặc file ghi âm điện thoại không?
Được. faster-whisper giải mã âm thanh bằng PyAV nên đọc được nhiều định dạng. Mình đã thử một file mp3 64 kbps, model small nhận ra tiếng Việt (xác suất 0,99) và cho kết quả trong 2,1 giây.
Máy không có card đồ họa thì nên chọn model nào?
Toàn bộ số liệu trong bài đo trên CPU 4 nhân. Với large-v3-turbo, một giờ ghi âm sẽ mất khoảng 22 phút (RTF 0,37). Nếu cần nhanh hơn thì dùng small (RTF 0,13, khoảng 8 phút cho một giờ) rồi chấp nhận sửa nhiều chữ hơn.
Có cần chỉ định language="vi" không?
Whisper tự nhận tiếng Việt khá chắc (0,99–1,00 trong các lần mình chạy). Tuy vậy, nếu biết chắc là tiếng Việt thì các bạn nên ghi language="vi" để model khỏi phải đoán, nhất là với file đầu có nhạc hoặc nói chen tiếng Anh.
Dùng kết quả này để nộp bài có ổn không?
Đây là bản nháp giúp các bạn đỡ phải gõ, không phải bản cuối. Như bước 6, model tốt nhất vẫn sai dấu và tên riêng, nên luôn đọc lại và sửa trước khi nộp hay đăng.
Nguồn tham khảo
- SYSTRAN/faster-whisper trên GitHub
- Issue #1589: PyAV open() does not accept metadata_errors argument
- faster-whisper trên PyPI
- openai/whisper trên GitHub (bảng kích thước model, giấy phép MIT)
- Bộ dữ liệu google/fleurs trên Hugging Face (CC BY 4.0)
- Model faster-whisper-large-v3-turbo
- Bộ lọc dynaudnorm của FFmpeg
Ảnh chụp và thử nghiệm ngày 19/11/2026.
